Qu’est-ce que l’analyse de régression ? Un guide complet pour les débutants
L'analyse de régression est une technique statistique utilisée pour modéliser la relation entre la variable dépendante et une ou plusieurs variables indépendantes, permettant des prédictions, des prises de décision et des informations dans divers domaines.
Points forts
- L'analyse de régression modélise les relations entre les variables dépendantes et indépendantes à des fins de prédiction et de prise de décision.
- Les régressions linéaire, logistique et polynomiale sont des types clés de régression, chacune adaptée à des données et des objectifs différents.
- Les mesures d'adéquation, comme le R au carré et le R au carré ajusté, évaluent les performances et l'explicabilité du modèle.
- Les hypothèses de régression incluent la linéarité, la normalité, l'indépendance des erreurs et l'homoscédasticité, qui doivent être validées.
- Les pièges courants incluent la confusion entre la corrélation et la causalité, le surajustement, la multicolinéarité, le biais de variable omis et l'extrapolation.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Qu'est-ce que l'analyse de régression ?
L'analyse de régression est une technique fondamentale en statistique et en science des données qui permet d'explorer et de quantifier les relations entre les variables. Elle est utilisée pour prédire des résultats, identifier des tendanceset prendre decisions basées sur les données dans divers domaines, allant du commerce et de la finance à la santé et à l'ingénierie.
L'analyse de régression vise essentiellement à modéliser la relation entre une variable dépendante (celle que l'on cherche à prédire ou à expliquer) et une ou plusieurs variables indépendantes (les facteurs qui influencent la variable dépendante). Ce faisant, elle permet de mieux comprendre les tendances et les relations causales sous-jacentes de nos données, et ainsi d'effectuer des prédictions plus fiables et et plus informé decisions.
L'idée fondamentale de l'analyse de régression est de trouver le modèle qui représente le mieux la relation entre les variables dépendantes et indépendantes. Cela implique souvent d'ajuster une droite ou une courbe aux points de données afin de minimiser les différences entre les valeurs observées et les valeurs prédites, appelées résidus.
En pratique, l'analyse de régression peut prendre de nombreuses formes, allant de la régression linéaire simple, qui modélise la relation entre une variable dépendante et une variable indépendante, à des techniques plus avancées, telles que la régression polynomiale multiple, qui permettent l'analyse de relations plus complexes.
En tant que polyvalent et puissant L'analyse de régression, outil statistiquepuissant et polyvalent , est essentielle pour quiconque souhaite interpréter des données et en tirer des conclusions pertinentes. Ce guide vous présente les différents types de l'analyse de régression, leur fondamental conceptsfondamentaux , leurs principales hypothèses et limites, ainsi que leurs applications pratiques dans de nombreux secteurs. En comprenant l'analyse de régression et en maîtrisant ses techniques, vous serez parfaitement outillé pour relever des défis complexes liés aux données et prendre des décisions éclairées en toute confiance.
Types d'analyse de régression
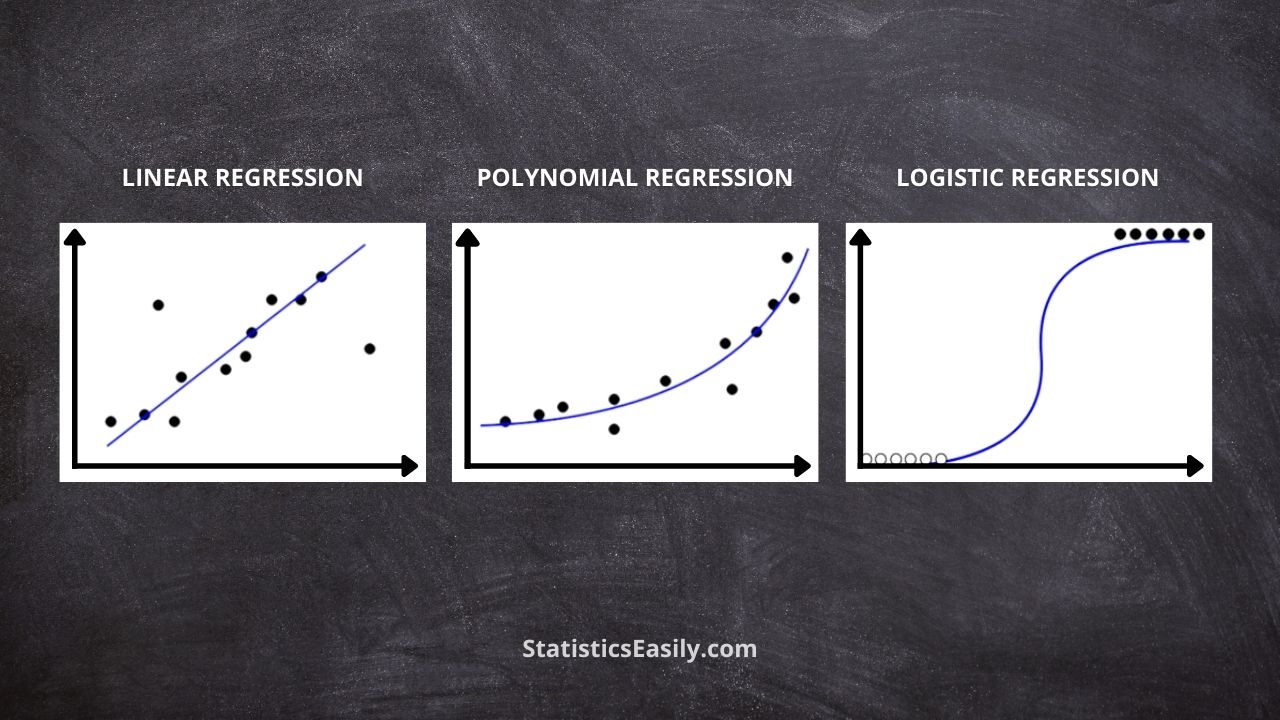
Régression linéaire :Il s’agit de la forme la plus simple d’analyse de régression permettant de modéliser la relation entre les variables dépendantes et indépendantes. Elle suppose une relation linéaire entre les variables, représentée par une droite. L’objectif est de trouver la droite d’ajustement optimale qui minimise la somme des carrés des différences entre les valeurs observées et les valeurs prédites. La régression linéaire est largement utilisée pour la prévision, l’analyse des tendances et l’identification de l’influence d’une variable sur une autre.
Régression logistique :Il s’agit d’un type d’analyse de régression conçu pour les problèmes impliquant des variables dépendantes catégorielles, notamment binaires (deux résultats possibles), nominales (catégories non ordonnées) et ordinales (catégories ordonnées). Au lieu de prédire la valeur réelle de la variable dépendante, la régression logistique estime la probabilité d’occurrence d’un événement en fonction de la variable indépendante. Elle utilise la fonction logistique, qui transforme le résultat du modèle de régression en une valeur de probabilité comprise entre 0 et 1. Couramment utilisée dans des domaines tels que la recherche médicale, le marketing et la finance, la régression logistique est un outil polyvalent pour prédire la probabilité d’événements ou de résultats spécifiques et comprendre l’impact de divers facteurs sur ces résultats.
Régression polynomiale :Il s’agit d’une extension de la régression linéaire utilisée lorsque la relation entre les variables dépendante et indépendante est non linéaire. Au lieu d’ajuster une droite, une fonction polynomiale est utilisée pour modéliser la courbure de cette relation. La régression polynomiale permet de saisir des tendances plus complexes dans les données, offrant un meilleur ajustement dans les situations où les modèles linéaires sont inadéquats. Cependant, il est essentiel de choisir avec soin le degré du polynôme, car des modèles trop complexes peuvent conduire à un surajustement et à une mauvaise généralisation aux nouvelles données.
*: La régression multiple est une technique avancée permettant d’inclure plusieurs variables indépendantes, ce qui rend possible l’analyse de relations plus complexes entre les variables et le contrôle des facteurs de confusion. Elle ne se limite pas à une généralisation de la régression linéaire. Elle peut également être étendue à d’autres types de régression, comme la régression logistique et la régression polynomiale. La régression multiple vise à trouver le modèle qui explique le mieux la relation entre les variables dépendantes et indépendantes.
Les concepts fondamentaux de l'analyse de régression
Variables dépendantes et indépendantes :En analyse de régression, la variable dépendante (ou variable cible) est le résultat que l’on cherche à prédire ou à expliquer. Les variables indépendantes (également appelées prédicteurs, variables explicatives ou variables indépendantes) sont les facteurs qui influencent la variable dépendante. L’analyse de régression vise à modéliser la relation entre ces variables, ce qui permet de comprendre l’influence des variables indépendantes sur la variable dépendante et d’effectuer des prédictions.
Coefficients et ordonnée à l'origine :Les coefficients et l'ordonnée à l'origine sont des composantes essentielles d'un modèle de régression. Les coefficients représentent l'effet des variables indépendantes sur la variable dépendante, indiquant la variation de cette dernière pour chaque unité d'augmentation des variables indépendantes, toutes les autres variables restant constantes. L'ordonnée à l'origine représente la valeur attendue de la variable dépendante lorsque toutes les variables indépendantes sont nulles. Ces valeurs sont estimées par la méthode des moindres carrés ordinaires ou par la méthode du maximum de vraisemblance lors de l'ajustement du modèle.
Qualité de l'ajustement et R² : La qualité de l'ajustement mesure la capacité du modèle de régression à s'adapter aux données observées. Plusieurs indicateurs permettent d'évaluer cette qualité. Parmi les plus courants, on trouve le R² (ou coefficient de détermination). Le R² représente la proportion de variance de la variable dépendante expliquée par les variables indépendantes du modèle. Il varie entre 0 et 1, les valeurs les plus élevées indiquant un meilleur ajustement. En régression multiple, il est essentiel de considérer le R² ajusté, qui tient compte du nombre de variables indépendantes. La valeur du R² peut augmenter avec l'ajout de variables, même si ces dernières n'améliorent pas significativement le pouvoir prédictif du modèle. Le R² ajusté corrige ce problème en pénalisant la valeur du R² pour l'inclusion de variables superflues. Il en résulte une évaluation plus précise des performances du modèle et une réduction du risque de surajustement. Toutefois, le R² et le R² ajusté doivent être interprétés avec prudence, car une valeur élevée ne garantit pas un bon modèle. Le modèle peut néanmoins être sujet à des problèmes tels que la multicolinéarité, le biais de variable omise ou d'autres violations des hypothèses de régression.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Hypothèses et limites clés
L'analyse de régression repose sur plusieurs hypothèses clés communes à différents types de régression, notamment les extensions de régression linéaire, logistique, polynomiale et multiple. Si ces hypothèses ne sont pas satisfaites, l'exactitude et la validité des prédictions et des conclusions du modèle pourraient être limitées. Par conséquent, il est crucial de comprendre et d’évaluer ces hypothèses lors de la réalisation d’une analyse de régression.
Forme fonctionnelle appropriée :La relation entre les variables dépendantes et indépendantes doit respecter la forme fonctionnelle du modèle de régression. Cela signifie une relation linéaire pour une régression linéaire et une relation polynomiale pour une régression polynomiale. L’examen des nuages de points ou des graphiques de résidus permet de détecter d’éventuelles violations de cette hypothèse.
Indépendance des observations :les observations d’un jeu de données doivent être indépendantes les unes des autres. En cas d’autocorrélation (lorsque des observations consécutives sont liées), le modèle de régression peut sous-estimer la variabilité réelle des données, ce qui conduit à des estimations de coefficients et à des tests d’hypothèses peu fiables.
Indépendance des erreurs :Les résidus (erreurs) doivent être indépendants, c’est-à-dire que l’erreur d’une observation ne doit pas influencer l’erreur d’une autre. Si les erreurs sont corrélées, les erreurs-types des coefficients peuvent être sous-estimées, ce qui conduit à des conclusions et des intervalles de confiance erronés.
Homoscédasticité (pour les régressions linéaires et polynomiales) :la variance résiduelle doit être constante pour toutes les valeurs des variables indépendantes. Si la variance varie (phénomène appelé hétéroscédasticité), les erreurs standard des coefficients peuvent être biaisées, ce qui affecte les tests d’hypothèses et les intervalles de confiance.
Normalité des résidus (pour les régressions linéaires et polynomiales) :les résidus (c’est-à-direles différences entre les valeurs observées et prédites) doivent suivre une distribution normale. Le non-respect de cette distribution peut affecter les tests d’hypothèses et la validité des intervalles de confiance.
Absence de multicolinéarité :les variables indépendantes ne doivent pas être fortement corrélées entre elles. La multicolinéarité peut entraîner une instabilité des estimations des coefficients et rendre difficile l’interprétation de la contribution individuelle de chaque variable.
Fonction de lien correctement spécifiée (pour la régression logistique) :La fonction de lien doit être correctement définie en régression logistique pour transformer les valeurs prédites en probabilités. L’utilisation d’une fonction de lien incorrecte peut entraîner des estimations de coefficients biaisées et des prédictions inexactes.
Interprétation des résultats de l'analyse de régression
Comprendre et interpréter les résultats de l’analyse de régression est crucial pour prendre de meilleures décisions et tirer des conclusions significatives. Voici quelques aspects clés à prendre en compte lors de l’interprétation des résultats de tout modèle de régression, y compris la régression linéaire, logistique, polynomiale et multiple :
Estimation des coefficients :Les coefficients représentent l’effet de chaque variable indépendante sur la variable dépendante, toutes les autres variables étant maintenues constantes. En régression linéaire et polynomiale, les coefficients indiquent la variation de la variable dépendante pour une augmentation d’une unité de la variable indépendante. En régression logistique, les coefficients représentent la variation du logarithme du rapport de cotes de l’événement pour une augmentation d’une unité de la variable indépendante.
Signification des coefficients :Des tests d’hypothèse, tels que les tests t ou les tests z, sont réalisés pour déterminer la signification statistique des coefficients. Un coefficient statistiquement significatif indique que la variable indépendante a un impact significatif sur la variable dépendante. Un coefficient non significatif implique que la variable indépendante ne contribue probablement pas de manière significative au modèle.
Intervalles de confiance :Les intervalles de confiance estiment la plage dans laquelle le coefficient de population est susceptible de se situer. Des intervalles plus étroits suggèrent des estimations plus précises, tandis que des intervalles plus larges indiquent une plus grande incertitude.
Statistiques d'ajustement du modèle :Les indicateurs de qualité d'ajustement, tels que le coefficient de détermination (R²), le R² ajusté ou le critère d'information d'Akaike (AIC), permettent d'évaluer la performance globale du modèle. Ces indicateurs doivent être considérés conjointement avec d'autres mesures et graphiques de diagnostic afin d'évaluer la pertinence du modèle.
Analyse des résidus :L’examen des résidus peut révéler des tendances ou des schémas suggérant des violations des hypothèses de régression ou des zones où le modèle ne s’ajuste pas correctement aux données. Les graphiques de résidus, les graphiques de probabilité normale et les graphiques d’autocorrélation peuvent être utilisés pour diagnostiquer les problèmes potentiels et orienter l’amélioration du modèle.
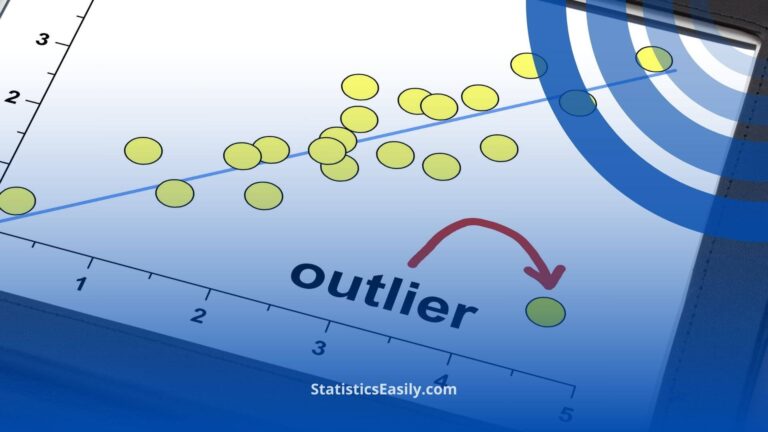
Valeurs aberrantes et points influents :Les valeurs aberrantes et les points influents peuvent avoir un impact significatif sur le modèle de régression. Identifier et traiter ces observations en les excluant ou en utilisant des techniques de régression robustes peut contribuer à améliorer les performances du modèle.
Validation et généralisation : La validation croisée ou la validation par échantillonnage peut être utilisée pour évaluer les performances du modèle sur de nouvelles données, permettant ainsi d’évaluer sa généralisabilité et d’éviter le surapprentissage.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Applications pratiques de l'analyse de régression
L'analyse de régression est un outil statistique puissant avec de nombreuses applications pratiques dans divers secteurs. L'analyse de régression peut aider à éclairer la prise de décision, à optimiser les processus et à prédire les résultats futurs en modélisant la relation entre les variables dépendantes et indépendantes. Voici quelques exemples de la façon dont l’analyse de régression est utilisée dans divers secteurs :
Finance et économie :En finance, l’analyse de régression permet de modéliser la relation entre les cours boursiers et les indicateurs économiques, tels que les taux d’intérêt ou le taux de chômage. Cela peut aider les investisseurs à prendre de meilleures décisions concernant la répartition de leur portefeuille et la gestion des risques. Par ailleurs, les économistes peuvent utiliser la régression pour étudier l’impact des politiques monétaires et budgétaires sur la croissance économique et l’inflation.
Marketing et ventes :Les modèles de régression permettent d’analyser l’efficacité des campagnes marketing, de comprendre le comportement des consommateurs et de prévoir les ventes. Par exemple, les entreprises peuvent utiliser la régression pour déterminer l’impact des dépenses publicitaires sur les ventes, ce qui leur permet d’optimiser leur budget marketing et d’obtenir un retour sur investissement maximal.
Santé :l'analyse de régression explore la relation entre les caractéristiques des patients et leurs résultats de santé. Elle permet d'identifier les facteurs de risque de maladies, d'orienter les décisions thérapeutiques et d'optimiser la prise en charge des patients. Par exemple, la régression logistique peut prédire la probabilité qu'un patient développe une pathologie particulière à partir de variables démographiques et cliniques.
Production et contrôle qualité :L’analyse de régression permet d’optimiser les processus de fabrication, d’améliorer la qualité des produits et de réduire les coûts de production. En modélisant la relation entre les variables de processus et les caractéristiques du produit, les entreprises peuvent identifier les conditions optimales pour atteindre les spécifications souhaitées tout en minimisant les déchets et la consommation de ressources.
Ressources humaines :En gestion des ressources humaines, l’analyse de régression permet de comprendre les facteurs influençant la performance, la fidélisation et la satisfaction au travail des employés. Elle aide les organisations à élaborer des stratégies ciblées de recrutement, de formation et d’engagement des employés, contribuant ainsi à améliorer la productivité et à réduire le roulement du personnel.
Analyse sportive :Les modèles de régression sont de plus en plus utilisés en analyse sportive pour évaluer les performances des joueurs, éclairer les décisions des entraîneurs et optimiser les stratégies d'équipe. Par exemple, l'analyse de régression multiple permet de quantifier la contribution des statistiques individuelles des joueurs au succès de l'équipe, aidant ainsi les entraîneurs et les managers à prendre des décisions plus éclairées concernant la composition de l'équipe.
Sciences de l'environnement : En recherche écologique, l'analyse de régression permet de modéliser la relation entre les facteurs environnementaux, tels que la température ou les précipitations, et les résultats écologiques, tels que la répartition des espèces ou la productivité des écosystèmes. Ces modélisations peuvent éclairer les efforts de conservation, la gestion des ressources naturelles et l'élaboration des politiques publiques.
Pièges courants et idées fausses dans l’analyse de régression
Bien que l’analyse de régression soit un outil statistique puissant et largement utilisé, elle présente des défis et des pièges potentiels. Être conscient de ces idées fausses et problèmes courants peut aider les praticiens à éviter les erreurs et à améliorer la qualité de leur analyse :
Corrélation et causalité :une erreur fréquente en analyse de régression est de croire que corrélation implique causalité. Bien que la régression puisse identifier des relations entre les variables, elle ne prouve pas nécessairement un lien de causalité. Établir la causalité exige une compréhension plus approfondie des mécanismes sous-jacents et implique souvent des protocoles expérimentaux ou des analyses complémentaires.
Surapprentissage :La construction d’un modèle trop complexe ou comportant un trop grand nombre de variables indépendantes peut entraîner un surapprentissage, où le modèle capture le bruit présent dans les données plutôt que les relations sous-jacentes. Les modèles surajustés sont peu performants sur de nouvelles données et peuvent conduire à des conclusions erronées. Pour prévenir le surapprentissage, il est conseillé d’utiliser la validation croisée, la régularisation ou la sélection de modèle basée sur des critères d’information tels que l’AIC ou le BIC.
Multicolinéarité :lorsque les variables indépendantes sont fortement corrélées, il devient difficile d’interpréter la contribution individuelle de chaque variable au modèle. La multicolinéarité peut entraîner des estimations instables et une augmentation des erreurs standard. La détection de la multicolinéarité à l’aide des facteurs d’inflation de la variance (VIF) ou des matrices de corrélation, et sa correction par des techniques telles que la sélection de variables ou la réduction de dimensionnalité, peuvent contribuer à améliorer l’interprétation et la performance du modèle.
Biais lié aux variables omises :exclure des variables importantes du modèle de régression peut entraîner des estimations de coefficients biaisées et des conclusions erronées. Pour éviter ce biais, assurez-vous que toutes les variables pertinentes soient incluses dans l’analyse. Envisagez d’utiliser une régression pas à pas ou des techniques de sélection de modèle pour identifier les prédicteurs les plus importants.
Non-respect des hypothèses :Ignorer ou ne pas vérifier les hypothèses sous-jacentes à l’analyse de régression peut conduire à des résultats non fiables. Il est essentiel d’évaluer la validité de ces hypothèses, telles que la linéarité, l’indépendance des erreurs et l’homoscédasticité, et d’utiliser des techniques ou des transformations alternatives si nécessaire.
Extrapolation :Utiliser des modèles de régression pour faire des prédictions au-delà de la plage des données observées peut s’avérer risqué, car les relations entre les variables peuvent ne pas se vérifier dans les régions non observées. Il convient d’être prudent lors de l’extrapolation des prédictions et de tenir compte des limites du modèle ainsi que de la possibilité que des facteurs imprévus influencent le résultat.
Interprétation erronée des coefficients : Interpréter les coefficients de régression sans tenir compte de l’échelle des variables ou de la fonction de lien (dans le cas d’une régression logistique) peut induire en erreur et mener à des conclusions incorrectes. Il est essentiel que l’interprétation des coefficients soit adaptée au contexte et prenne en considération les unités de mesure, le sens de l’effet et l’intensité de la relation.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusion
L'analyse de régression est un outil statistique puissant et polyvalent permettant aux praticiens de modéliser les relations entre les variables, de faire des prédictions et d'éclairer la prise de décision dans divers secteurs. En comprenant les concepts fondamentaux, tels que les variables dépendantes et indépendantes, les coefficients et la qualité de l'ajustement, les analystes peuvent sélectionner le type de modèle de régression approprié pour leurs données, notamment la régression linéaire, logistique, polynomiale et multiple.
Cependant, il est crucial d'être conscient des hypothèses et des limites de l'analyse de régression et d'interpréter soigneusement les résultats pour éviter les pièges et les idées fausses courantes. En prenant en compte les hypothèses, en abordant des problèmes tels que la multicolinéarité et le surajustement, et en utilisant des techniques telles que la validation croisée et la régularisation, les praticiens peuvent créer des modèles plus précis et généralisables qui apportent des informations précieuses et orientent la prise de décision basée sur les données.
En résumé, l’analyse de régression est un outil précieux pour comprendre des relations complexes et résoudre des problèmes du monde réel, à condition que les praticiens soient conscients de ses défis et limites potentiels et qu’ils s’engagent à utiliser la méthode de manière responsable et efficace.
Articles recommandés
Envie d'enrichir vos connaissances ? Consultez notre blog pour découvrir des articles pertinents et approfondir votre compréhension de ces tests statistiques essentiels. Profitez-en pour perfectionner vos compétences l'analyse des données et prendre des décisions plus éclairées. Lisez dès maintenant !
- Comment rapporter les résultats d'une régression linéaire multiple dans le style APA
- Comment rapporter les résultats de la régression linéaire simple dans le style APA
- Hypothèses de régression linéaire : un guide complet
- Régression logistique utilisant R : le guide définitif
- Quelles sont les hypothèses de régression logistique ?
- Quels sont les 3 types de régression logistique ?
- Comment créer des lignes de régression dans Excel
- Maîtriser la régression logistique (Récit)
FAQ : Qu'est-ce que l'analyse de régression ?
L'analyse de régression est une approche statistique permettant de modéliser les relations entre les variables dépendantes et indépendantes à des fins de prédiction et de prise de décision.
Les principaux types sont la régression linéaire, logistique, polynomiale et multiple, chacune adaptée à différents types de données et objectifs.
La corrélation mesure la force et la direction d'une relation entre les variables. Dans le même temps, la causalité implique qu’une variable influence directement l’autre.
Les hypothèses incluent la linéarité, la normalité, l'indépendance des erreurs et l'homoscédasticité, qui doivent être validées pour des résultats fiables.
Lorsque les variables indépendantes sont fortement corrélées, une multicolinéarité se produit, ce qui rend difficile l’interprétation des contributions individuelles. Il peut être résolu à l’aide de techniques de sélection de variables ou de réduction de dimensionnalité.
Le surajustement se produit lorsqu'un modèle capture le bruit plutôt que les relations sous-jacentes, ce qui entraîne une mauvaise généralisabilité. Cela peut être évité grâce à la validation croisée, à la régularisation ou à la sélection de modèles.
Les coefficients représentent l'effet des variables indépendantes sur la variable dépendante tout en maintenant les autres variables constantes. L'interprétation dépend du type de régression et des échelles variables.
L'analyse des résidus examine les résidus (différences entre les valeurs observées et prédites) pour identifier les modèles, les tendances ou les violations des hypothèses de régression, guidant ainsi l'amélioration du modèle.
L'analyse de régression est largement utilisée dans les domaines de la finance, du marketing, de la santé, de la fabrication, des ressources humaines, de l'analyse sportive et des sciences de l'environnement.
Les pièges courants incluent la confusion entre la corrélation et la causalité, le surajustement, la multicolinéarité, le biais de variable omis, l'extrapolation et la mauvaise interprétation des coefficients.