Hypothèses de régression linéaire : un guide complet
Vous apprendrez les principes fondamentaux des hypothèses de la régression linéaire et comment les valider à l'aide d'exemples concrets pour l'analyse des données.
Points forts
- La régression linéaire est une technique de modélisation prédictive largement utilisée pour comprendre les relations entre les variables.
- La normalité des résidus permet de garantir des prédictions impartiales et des intervalles de confiance fiables dans la régression linéaire.
- L'homoscédasticité garantit que les prédictions du modèle ont une précision constante sur différentes valeurs.
- L'identification et le traitement de la multicolinéarité améliorent la stabilité et l'interprétabilité de votre modèle de régression.
- Les techniques de prétraitement et de transformation des données, telles que la mise à l'échelle et la normalisation, peuvent atténuer les problèmes potentiels de la régression linéaire.
La régression linéaire est une technique permettant de modéliser et de prédire la relation entre une variable cible et une ou plusieurs variables d'entrée.
Cela nous aide à comprendre comment un changement dans les variables d'entrée affecte la variable cible.
La régression linéaire suppose qu'une ligne droite peut représenter cette relation.
Par exemple, disons que vous souhaitez estimer le coût d'une propriété en tenant compte de sa taille (mesurée en pieds carrés) et de son âge (en années).
Dans ce cas, le prix de la maison est la variable cible, et la taille et l’âge sont les variables d’entrée.
À l’aide de la régression linéaire, vous pouvez estimer l’effet de la taille et de l’âge sur le prix de la maison.
Hypothèses de régression linéaire
Six hypothèses principales de la régression linéaire doivent être satisfaites pour que le modèle soit fiable et valide. Ces hypothèses sont les suivantes :
1. Linéarité
Cette hypothèse stipule qu'il existe une relation linéaire entre les variables dépendantes et indépendantes. En d’autres termes, la variation de la variable dépendante doit être proportionnelle à la variation des variables indépendantes. La linéarité peut être évaluée à l’aide de nuages de points ou en examinant les résidus.
2. Normalité des erreurs
Les résidus doivent suivre une distribution normale avec une moyenne de zéro. Cette hypothèse est essentielle pour tester correctement les hypothèses et construire des intervalles de confiance. La normalité des erreurs peut être évaluée à l'aide de méthodes visuelles, comme un histogramme ou un tracé QQ, ou par des tests statistiques, comme le test de Shapiro-Wilk ou le test de Kolmogorov-Smirnov.
3. Homoscédasticité
Cette hypothèse stipule que la variance des résidus doit être constante à tous les niveaux de variables indépendantes. En d’autres termes, la répartition des résidus doit être similaire pour toutes les valeurs des variables indépendantes. L'hétéroscédasticité, violant cette hypothèse, peut être identifiée à l'aide de nuages de points des résidus ou de tests formels comme le test de Breusch-Pagan.
4. Indépendance des erreurs
Cette hypothèse stipule que les observations de l'ensemble de données doivent être indépendantes les unes des autres. Les observations peuvent dépendre les unes des autres lorsque l'on travaille avec des séries chronologiques ou des données spatiales en raison de leur proximité temporelle ou spatiale. La violation de cette hypothèse peut conduire à des estimations biaisées et à des prévisions peu fiables. Des modèles spécialisés tels que des séries chronologiques ou des modèles spatiaux peuvent être plus appropriés dans de tels cas.
5. Absence de multicolinéarité (Régression Linéaire Multiple)
La multicolinéarité se manifeste lorsque deux ou plusieurs variables indépendantes d'un modèle de régression linéaire sont fortement corrélées, ce qui complique l'établissement de l'effet précis de chaque variable sur la variable dépendante. La multicolinéarité peut engendrer des estimations instables, une augmentation des erreurs standard et une difficulté d'interprétation des coefficients. Le facteur d'inflation de la variance (VIF) ou la matrice de corrélation permettent de détecter la multicolinéarité. En cas de multicolinéarité, il est conseillé d'envisager la suppression d'une des variables corrélées, la combinaison des variables corrélées ou l'utilisation de techniques telles que l'analyse en composantes principales (ACP) ou la régression ridge.
6. Indépendance des observations
Cette hypothèse stipule que les observations de l'ensemble de données doivent être indépendantes les unes des autres. Les observations peuvent dépendre les unes des autres lorsque l'on travaille avec des séries chronologiques ou des données spatiales en raison de leur proximité temporelle ou spatiale. La violation de cette hypothèse peut conduire à des estimations biaisées et à des prévisions peu fiables. Des modèles spécialisés tels que des séries chronologiques ou des modèles spatiaux peuvent être plus appropriés dans de tels cas.
En vous assurant que ces hypothèses sont respectées, vous pouvez augmenter la précision, la fiabilité et l'interprétabilité de vos modèles de régression linéaire. Si des hypothèses ne sont pas respectées, il peut être nécessaire d'appliquer des transformations de données, d'utiliser des techniques de modélisation alternatives ou d'envisager d'autres approches pour résoudre les problèmes.
❓ L'analyse des données vous paraît complexe ? Notre guide complet le rendra parfaitement clair
| Hypothèses | Description |
|---|---|
| Linéarité | Relation linéaire entre variables dépendantes et indépendantes, vérifiée à l'aide de nuages de points |
| Normalité | Distribution normale des résidus, évaluée par le test de Shapiro-Wilk |
| L'homoscédasticité | Variance constante en termes d'erreur, évaluée à l'aide du test de Breusch-Pagan |
| Indépendance des erreurs | Termes d'erreur indépendants, vérifiés à l'aide du test de Durbin-Watson |
| Indépendance des observations | Points de données collectés indépendamment sans autocorrélation |
| Absence de multicolinéarité | Aucune multicolinéarité entre les variables indépendantes, déterminée à l'aide de mesures VIF et de tolérance |
Exemple pratique
Voici une démonstration d'un problème de modèle de régression linéaire avec deux variables indépendantes et une variable dépendante.
Dans cet exemple, nous modéliserons la relation entre la superficie d'une maison et son âge avec son prix de vente.
L'ensemble de données contient la superficie en pieds carrés, l'âge et le prix de vente de 40 maisons.
Nous utiliserons la régression linéaire multiple pour estimer les effets de la superficie en pieds carrés et de l'âge sur le prix de vente.
Voici un tableau avec les données que vous pouvez copier et coller :
| Maison | Pieds carrés | Âge | Tarifs et Prix |
|---|---|---|---|
| 1 | 1500 | 10 | 250000.50 |
| 2 | 2000 | 5 | 300000.75 |
| 3 | 1200 | 15 | 200500.25 |
| 4 | 2500 | 2 | 400100.80 |
| 5 | 1800 | 8 | 270500.55 |
| 6 | 1600 | 12 | 220800.60 |
| 7 | 2200 | 4 | 320200.10 |
| 8 | 2400 | 1 | 420300.90 |
| 9 | 1000 | 18 | 180100.15 |
| 10 | 2000 | 7 | 290700.40 |
| 11 | 1450 | 11 | 240900.65 |
| 12 | 2050 | 6 | 315600.20 |
| 13 | 1150 | 16 | 190800.75 |
| 14 | 2600 | 3 | 410500.50 |
| 15 | 1750 | 9 | 260200.55 |
| 16 | 1550 | 13 | 210700.85 |
| 17 | 2300 | 3 | 330400.45 |
| 18 | 2450 | 2 | 415200.90 |
| 19 | 1100 | 17 | 185300.65 |
| 20 | 1900 | 8 | 275900.80 |
| 21 | 1400 | 12 | 235800.55 |
| 22 | 2100 | 6 | 305300.40 |
| 23 | 1300 | 14 | 195400.25 |
| 24 | 2700 | 3 | 410200.75 |
| 25 | 1700 | 10 | 255600.20 |
| 26 | 1650 | 11 | 215400.60 |
| 27 | 2150 | 5 | 325500.50 |
| 28 | 1250 | 15 | 205700.85 |
| 29 | 2550 | 4 | 395900.90 |
| 30 | 1850 | 9 | 265100.65 |
| 31 | 1350 | 13 | 225900.40 |
| 32 | 1950 | 7 | 285800.15 |
| 33 | 1100 | 16 | 195900.80 |
| 34 | 2800 | 3 | 430700.55 |
| 35 | 1750 | 10 | 245500.20 |
| 36 | 1600 | 12 | 225300.10 |
| 37 | 2000 | 7 | 310700.50 |
| 37 | 2000 | 7 | 310700.50 |
| 38 | 1200 | 15 | 201200.90 |
| 39 | 2600 | 4 | 380800.65 |
| 40 | 1800 | 8 | 279500.25 |
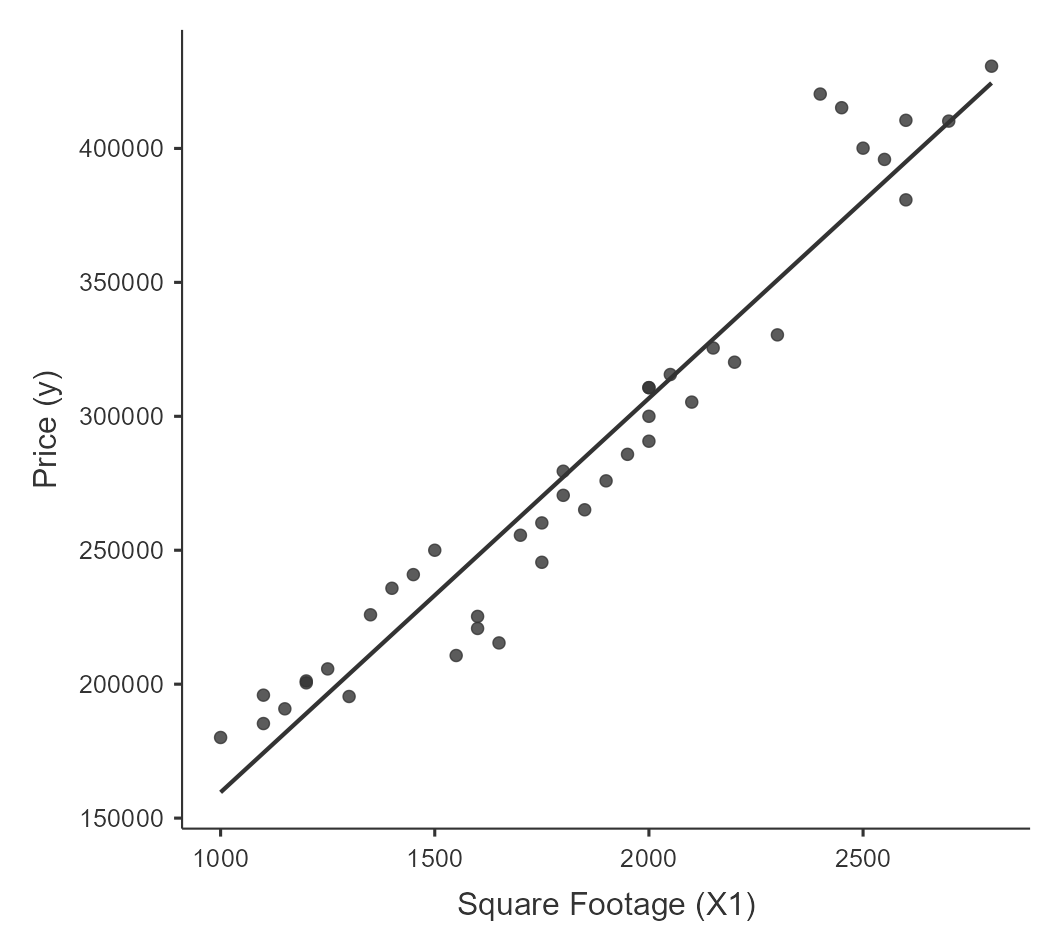
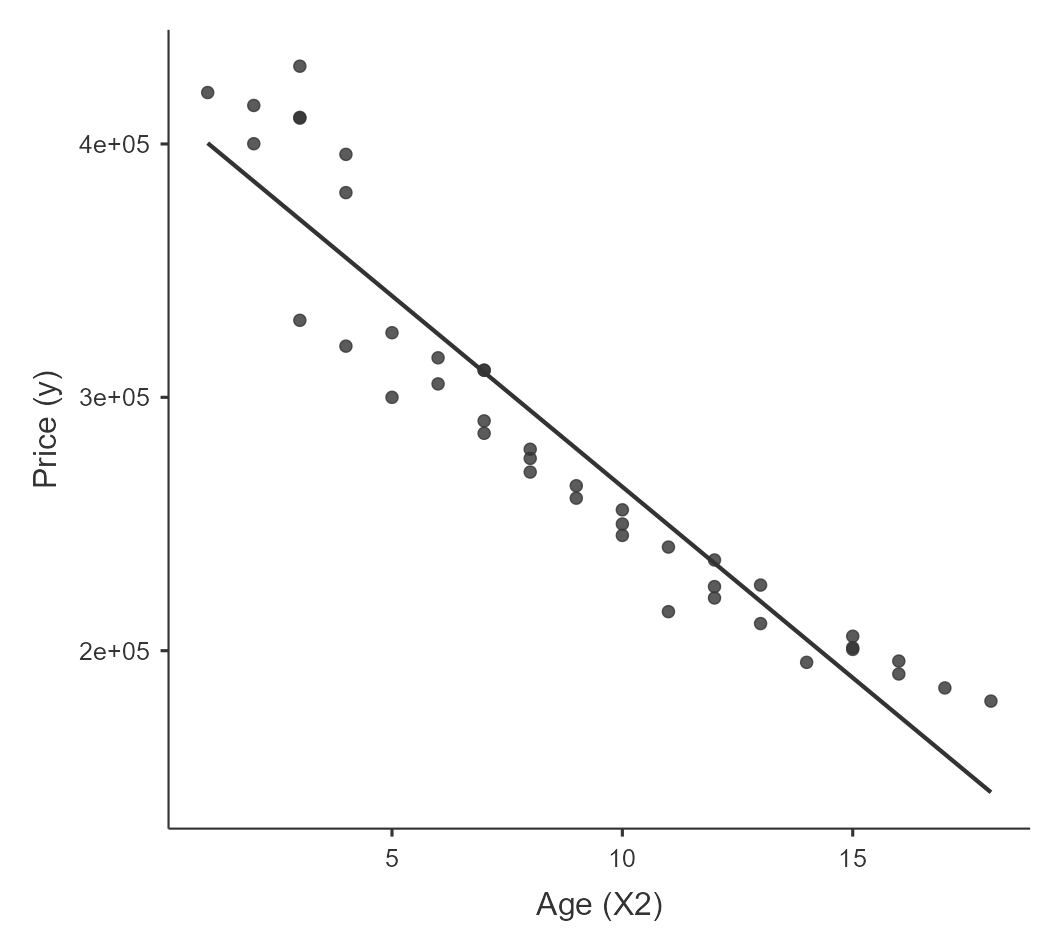
1. Linéarité
Évaluez l'hypothèse de linéarité en inspectant visuellement le nuage de points de la variable dépendante par rapport à chaque variable indépendante pour un motif linéaire perceptible.
2. Normalité des erreurs
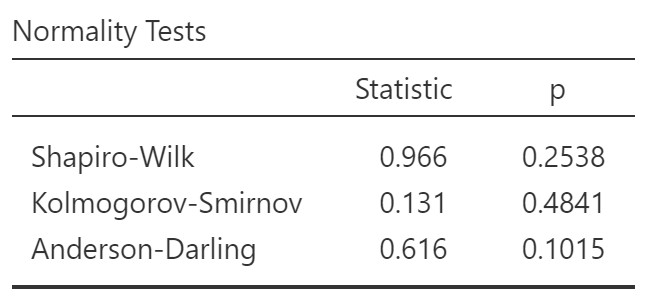
Évaluez l'hypothèse de normalité en effectuant le test de Shapiro-Wilk, qui évalue la distribution des résidus pour détecter les écarts significatifs par rapport à une distribution normale.
Dans le test de Shapiro-Wilk, une valeur p élevée (généralement supérieure à 0.05) indique que la distribution des résidus ne diffère pas significativement d'une distribution normale.
3. Homoscédasticité
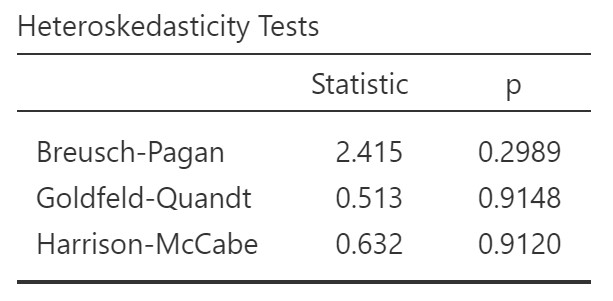
Évaluez l'hypothèse d'homoscédasticité en effectuant le test de Breusch-Pagan, qui vérifie la variance non constante des termes d'erreur.
Une valeur p élevée (généralement supérieure à 0.05) suggère que les données présentent une homoscédasticité, avec une variance constante entre différentes valeurs.
4. Indépendance des erreurs
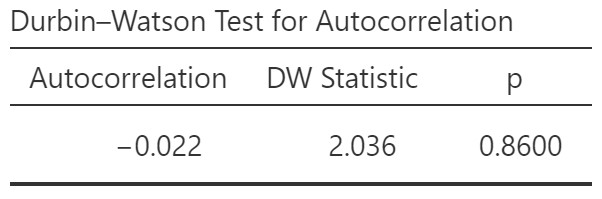
Une statistique de Durbin-Watson proche de 2 suggère que les erreurs sont indépendantes, avec une autocorrélation minimale.
Les valeurs inférieures ou supérieures à 2 indiquent respectivement une autocorrélation positive ou négative.
La valeur p signifie que la statistique DW n'est pas significativement différente de 2.
5. Absence de multicolinéarité
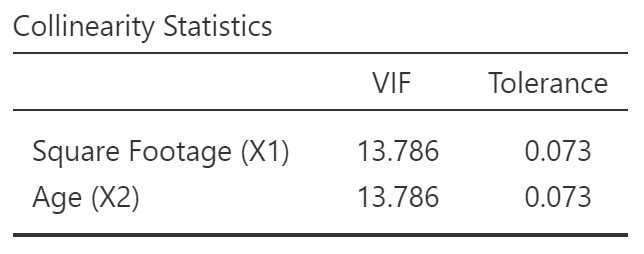
Évaluez l’absence de multicolinéarité à l’aide des mesures du facteur d’inflation de variance (VIF) et de tolérance. Des valeurs VIF faibles (généralement inférieures à 10) et des valeurs de tolérance élevées (supérieures à 0.1) indiquent que la multicolinéarité n'est pas une préoccupation significative dans le modèle de régression.
Nos données indiquent la présence d'une multicolinéarité entre les variables âge et superficie. Nous devrons en supprimer un. La variable à supprimer peut être déterminée de différentes manières, par exemple en testant avec de simples régressions linéaires pour voir laquelle correspond le mieux au modèle ou en décidant sur la base de la théorie sous-jacente.
6. Indépendance des observations
Pour éviter de violer l'hypothèse d'indépendance des observations, assurez-vous que vos points de données sont collectés de manière indépendante et ne présentent pas d'autocorrélation, qui peut être évaluée à l'aide du test de Durbin-Watson.
Conclusion
Il est crucial d'examiner et de prendre en compte ces hypothèses lors de la construction d'un modèle de régression linéaire pour garantir la validité, la fiabilité et l'interprétabilité.
En comprenant et en vérifiant les six hypothèses (linéarité, indépendance des erreurs, homoscédasticité, normalité des erreurs, indépendance des observations et absence de multicolinéarité), vous pouvez construire des modèles plus précis et plus fiables, conduisant à une meilleure prise de décision et à une meilleure compréhension des relations. entre les variables de vos données.
Saisissez l'opportunité d'accéder à des extraits GRATUITS de notre nouveau livre numérique et libérez votre potentiel.
Approfondissez vos connaissances sur les méthodes avancées l'analyse des données , la détermination de la taille d'échantillon idéale et la communication efficace, claire et concise des résultats.
Cliquez sur le lien pour découvrir une mine d'informations : Statistiques appliquées : analyse des données.