Analyse en composantes principales : transformer les données en informations véridiques
Vous apprendrez la puissance de l’analyse en composantes principales pour révéler des vérités cachées sur les données.
Introduction
Analyse en composantes principales (ACP)est une technique essentielle en statistique et en science des données. Elle offre une méthode sophistiquée pour réduire la dimensionnalité des grands ensembles de données tout en préservant au maximum leur variabilité. Ce processus simplifie la complexité inhérente aux données multidimensionnelles et améliore leur interprétabilité sans compromettre significativement l'intégrité des données originales. L'ACP vise essentiellement à identifier des tendances dans les données, à mettre en évidence des incohérences et à transformer des ensembles de données complexes en une forme plus simple, permettant ainsi aux analystes et aux scientifiques d'obtenir des informations pertinentes plus efficacement. Cet article a pour objectif de démystifierPCA, en guidant les lecteurs à travers ses fondements conceptuels, ses applications pratiques et son impact profond sur les stratégies l'analyse des données . En nous concentrant sur l'PCA, nous souhaitons éclairer le chemin des passionnés et des professionnels, en favorisant une compréhension et une maîtrise plus approfondies de cet outil analytique indispensable.
Points forts
- La PCA réduit la taille des données tout en préservant leurs caractéristiques essentielles.
- Historiquement, l’ACP a évolué de concepts simples vers des applications complexes en génomique et en finance.
- L’utilisation correcte de la PCA peut révéler des modèles de données qui n’étaient pas apparents au départ.
- Choisir le nombre correct de composants dans l’ACP est crucial pour une interprétation précise des données.
- Les outils et logiciels PCA rationalisent l’analyse, rendant les informations sur les données plus accessibles.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
L'essence de l'analyse en composantes principales
Analyse en composantes principales (ACP)est une méthode statistique qui utilise une transformation orthogonale pour convertir un ensemble d'observations de variables potentiellement corrélées en valeurs de variables linéairement non corrélées, appelées composantes principales. Cette technique est largement reconnue pour sa capacité à réduire la dimensionnalité des données tout en préservant la majeure partie de leur variance. L'ACP repose essentiellement sur sa capacité à extraire l'information essentielle du tableau de données, à réduire la taille de l'ensemble et à simplifier sa description, tout en préservant les composantes les plus pertinentes de chaque variable.
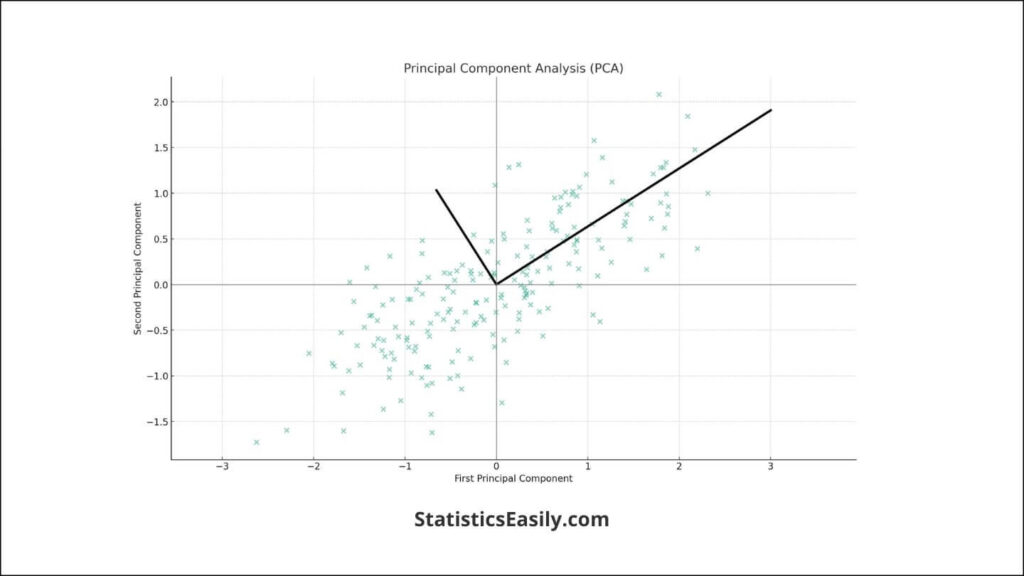
Les principes fondamentaux de l’ACP consistent à identifier les directions, ou axes, le long desquels la variabilité des données est maximisée. La première composante principale est la direction qui maximise la variance des données. La deuxième composante principale est orthogonale à la première. Il identifie la direction de la variance la plus élevée suivante, et ainsi de suite. Ce processus permet à PCA de réduire les ensembles de données complexes à une dimension inférieure, facilitant ainsi l'analyse et la visualisation des données sans perte significative d'informations.
La beauté de PCA dans la simplification d'ensembles de données complexes tout en conservant les informations essentielles est sans précédent. Il permet aux data scientists et aux statisticiens de découvrir des modèles cachés dans les données, facilitant ainsi une prise de décision plus éclairée. En se concentrant sur les composants les plus importants, la PCA permet de mettre en évidence la structure sous-jacente des données, fournissant ainsi un aperçu plus clair de la véritable nature des données analysées. Cette méthode améliore l’efficacité de l’analyse des données. Cela contribue à une compréhension plus véridique et plus approfondie des propriétés intrinsèques des données.
Contexte historique et fondements théoriques
Le parcours deAnalyse en composantes principales (ACP)remonte au début du XXe siècle, avec les travaux pionniers de Carl Pearson en 1901. Cherchant à comprendre la structure sous-jacente des données, Pearson a développé l'ACP pour décrire la variabilité observée dans un espace de données multidimensionnel grâce à des variables non corrélées. Cette technique a ensuite été formalisée mathématiquement par Harold Hotelling dans les années 1930, lui conférant un fondement statistique plus robuste et étendant son champ d'application à divers domaines scientifiques.
Les fondements mathématiques de l'ACP sont profondément liés à l'algèbre linéaire, en particulier les concepts de vecteurs propres et de valeurs propres. À la base, la PCA transforme les données d'origine en un nouveau système de coordonnées dans lequel les écarts les plus significatifs de toute projection de données se situent sur les premières coordonnées, appelées composantes principales. Cette transformation est réalisée grâce à la décomposition propre de la matrice de covariance des données ou à la décomposition en valeurs singulières (SVD) de la matrice de données. Ces méthodes garantissent la maximisation de la variance et préservent l'intégrité structurelle de l'ensemble de données.
La précision et la véracité de l’ACP résident dans sa rigueur mathématique. La PCA encapsule la variabilité inhérente aux données et les relations entre les variables à l'aide de la matrice de covariance, offrant une vue distillée mettant en évidence les modèles les plus significatifs. Ce processus simplifie non seulement la complexité des données, mais met également au premier plan la vérité essentielle – la structure sous-jacente et la variabilité des données –, permettant une analyse et une prise de décision éclairées.
L’ACP s’est imposée comme la pierre angulaire de l’analyse des données statistiques grâce à son développement et à ses fondements mathématiques. Sa capacité à réduire la dimensionnalité tout en préservant les informations essentielles en a fait un outil précieux pour les data scientists et les statisticiens, facilitant une compréhension plus approfondie des données dans de nombreux domaines.
Applications pratiques de l'analyse en composantes principales
Analyse en composantes principales (ACP)a dépassé son cadre académique pour devenir un outil analytique essentiel dans de nombreux domaines. Sa capacité à extraire des informations exploitables de vastes ensembles de données a révolutionné notre interprétation des informations complexes, la rendant indispensable dans des domaines aussi divers que la génomique, la finance et le traitement d'images numériques.
Engénomique, l'ACP simplifie les données génétiques, souvent composées de milliers de variables. En réduisant la dimensionnalité, l'ACP permet aux chercheurs d'identifier plus efficacement les marqueurs et les profils génétiques liés aux maladies, facilitant ainsi les avancées en médecine personnalisée et en études évolutives.
The secteur financierutilise l'ACP pour la gestion des risques et les stratégies d'investissement. L'ACP permet de mettre en évidence les principaux facteurs influençant les fluctuations du marché en analysant la matrice de covariance des rendements des actifs. Cette simplification facilite la diversification du portefeuille, en révélant des tendances sous-jacentes qui pourraient passer inaperçues lors d'analyses traditionnelles.
Encompression d'images, l'ACP réduit la redondance des données de pixels, permettant ainsi un stockage et une transmission efficaces des images sans perte de qualité significative. Cette application est cruciale dans les domaines où la bande passante est limitée, comme l'imagerie satellitaire et la télémédecine, et il est essentiel de trouver un équilibre entre la compression et la préservation de l'intégrité de l'image.
La PCA révèle des modèles sous-jacents dans les données grâce à ces applications et simplifie considérablement les processus de prise de décision. En distillant des ensembles de données complexes dans leurs composants les plus significatifs, la PCA reflète la qualité inhérente à l'analyse des données, transformant des volumes de données considérables en informations exploitables. Cette transition de la complexité à la clarté améliore notre compréhension des données. Cela nous permet de prendre des décisions éclairées dans un éventail de domaines critiques, démontrant ainsi la polyvalence et la pertinence durable de PCA.
Guide étape par étape pour effectuer une analyse en composantes principales sur Python
La réalisation d'une analyse en composantes principales (ACP) dans Python condense efficacement de grands ensembles de données en leurs composants les plus importants, simplifiant ainsi l'analyse des données. Ce guide décrit le processus depuis la préparation des données jusqu'à leur interprétation, en utilisant la bibliothèque scikit-learn, réputée pour ses puissants outils d'exploration et d'analyse de données.
1. Préparation des données
Avant de mettre en œuvre la PCA, assurez-vous que vos données sont adaptées au processus. Cela signifie gérer les valeurs manquantes, normaliser les données et réduire les fonctionnalités si elles sont fortement corrélées.
import pandas as pd
from sklearn.preprocessing import StandardScaler

# Load dataset
df = pd.read_csv('data_pca.csv')

# Preprocessing
## Handle missing values if any
df.fillna(method='ffill', inplace=True)

## Feature scaling
features = ['Feature1', 'Feature2', 'Feature3', 'Feature4', 'Feature5', 'Feature6']
x = df.loc[:, features].values
x = StandardScaler().fit_transform(x)  # Normalize data
2. Mise en œuvre de l'APC
Une fois les données préparées, vous pouvez appliquer la PCA. Décidez du nombre de composants principaux que vous souhaitez conserver ou laissez l'algorithme choisir en fonction de la variance.
from sklearn.decomposition import PCA

# PCA transformation
pca = PCA(n_components=2)  # n_components to specify desired reduction
principalComponents = pca.fit_transform(x)

# Convert to a DataFrame
principalDf = pd.DataFrame(data=principalComponents, columns=['Principal Component 1', 'Principal Component 2'])
3. Analyse des résultats
Après avoir transformé les données, analysez les principaux composants pour comprendre la structure sous-jacente de l'ensemble de données.
print(pca.explained_variance_ratio_)
Ceci imprime la variance expliquée par chacune des composantes principales sélectionnées, ce qui donne un aperçu de la quantité d'informations capturées par l'analyse.
4. Visualisation
La visualisation des principaux composants peut fournir des informations intuitives sur la structure des données et le clustering.
import matplotlib.pyplot as plt

plt.figure(figsize=(8,6))
plt.scatter(principalDf['Principal Component 1'], principalDf['Principal Component 2'])
plt.xlabel('Principal Component 1')
plt.ylabel('Principal Component 2')
plt.title('PCA on Dataset')
plt.show()
5. Interprétation
L’interprétation consiste à comprendre les principales composantes en termes d’originalités. Cela nécessite souvent une connaissance du domaine et un examen des pondérations des composants PCA.
# Accessing the components_
print(abs(pca.components_))
Cela montre le poids de chaque caractéristique d'origine dans les composants principaux, facilitant ainsi l'interprétation des composants.
Exemples de résultats d'ensemble de données
À l'aide d'un ensemble de données hypothétiques, l'ACP pourrait révéler que les deux premières composantes principales capturent une partie importante de la variance des données. La visualisation peut montrer un regroupement clair, suggérant des groupes distincts au sein de l'ensemble de données. Les pondérations des composants pourraient indiquer quelles caractéristiques influencent le plus ces regroupements.
Guide étape par étape pour effectuer une analyse en composantes principales sur R
L'analyse en composantes principales (ACP) réalisée avec R permet de condenser efficacement de grands ensembles de données en leurs composantes les plus significatives, simplifiant ainsi l'analyse. Ce guide décrit le processus, de la préparation des données à leur interprétation, en utilisant la panoplie d'outils performants et complets offerts par R pour le calcul statistique.
1. Préparation des données
Avant de mettre en œuvre la PCA, assurez-vous que vos données sont appropriées pour le processus. Cela implique de gérer les valeurs manquantes, de standardiser les données et de réduire les fonctionnalités si elles sont fortement corrélées.
# Load dataset
df <- read.csv('data_pca.csv')

# Preprocessing
## Handle missing values if any
df[is.na(df)] <- method = na.omit(df)

## Feature scaling
features <- df[, c('Feature1', 'Feature2', 'Feature3', 'Feature4', 'Feature5', 'Feature6')]
scaled_features <- scale(features) # Normalize data
2. Mise en œuvre de l'APC
Une fois les données préparées, l’ACP peut être appliquée. Vous pouvez décider du nombre de composants principaux que vous souhaitez conserver ou laisser l'algorithme choisir en fonction de la variance expliquée.
# PCA transformation
pca <- prcomp(scaled_features, rank. = 2, center = TRUE, scale. = TRUE)

# The rank. argument specifies the desired reduction
# prcomp automatically centers and scales the variables
3. Analyse des résultats
Après transformation des données, le résumé de l'objet PCA peut être utilisé pour comprendre la variance expliquée par les composantes principales.
# This prints the summary of the PCA object
summary(pca)
4. Visualisation
La visualisation des principaux composants peut offrir des informations intuitives sur la structure des données et le clustering possible.
# This creates a scatter plot of the first two principal components
plot(pca$x[, 1:2], col = df$YourGroupVariable, xlab = 'Principal Component 1', ylab = 'Principal Component 2', main = 'PCA on Dataset')
5. Interprétation
L'interprétation de la PCA implique de comprendre comment les fonctionnalités d'origine contribuent aux composants principaux, ce qui nécessite souvent une connaissance du domaine.
# This shows the loading of each original feature on the principal components
pca$rotation
Exemples de résultats d'ensemble de données
À l'aide d'un ensemble de données hypothétiques, l'ACP dans R pourrait révéler que les deux premières composantes principales capturent une partie importante de la variance des données. La visualisation peut montrer un regroupement apparent, suggérant des groupes distincts au sein de l'ensemble de données. L’examen de la rotation (chargements) peut indiquer quelles caractéristiques influencent le plus ces regroupements.
Meilleures pratiques et pièges courants
Il est essentiel d’adhérer aux meilleures pratiques et de rester vigilant face aux pièges courants pour interpréter des données significatives grâce à l’analyse en composantes principales (ACP). La précision et la représentation fidèle de l'essence de l'ensemble de données sont essentielles.
Assurer la précision
- Normalisation des données: Standardisez toujours vos données avant d'appliquer l'ACP, car l'analyse est sensible aux variances des variables initiales.
- Valeurs manquantes: corrigez toutes les valeurs manquantes ou infinies dans l'ensemble de données pour éviter les biais dans l'extraction des composants.
- Les valeurs aberrantes: Étudiez et comprenez les valeurs aberrantes avant l’ACP, car elles peuvent influencer de manière disproportionnée les résultats.
Éviter les mauvaises interprétations
- Interprétabilité des composants: Les composants principaux sont des constructions mathématiques qui n'ont pas toujours une interprétation directe du monde réel. Attention à ne pas les surinterpréter.
- Les écarts: Un rapport de variance élevé pour les premiers composants ne garantit pas qu'ils contiennent toutes les informations significatives. Des subtilités importantes peuvent exister dans les composants présentant une variance plus faible.
Choisir le bon nombre de composants
- Écart expliqué: Utilisez un graphique d'éboulis ou un rapport de variance expliquée cumulé pour identifier un point de coude ou le nombre de composants qui capturent des informations substantielles.
- Parcimonie: équilibrez complexité et interprétabilité, en sélectionnant le plus petit nombre de composants qui fournissent toujours une vue complète de la structure des données.
- Connaissance du domaine: Tirez parti de la compréhension de votre domaine pour décider du nombre de composants à conserver, en vous assurant qu'ils ont du sens pour votre contexte spécifique.
Rester fidèle à l'essence des données
- Cohérence avec les objectifs: Alignez le nombre de composants retenus avec les objectifs analytiques, qu'il s'agisse de simplification des données, de réduction du bruit ou de découverte de structures latentes.
- Examen complet: Combinez la PCA avec d’autres techniques d’exploration de données pour construire une compréhension holistique des données.
Le respect de ces directives orientera votre PCA vers une analyse fiable, préservant l'intégrité des données tout en extrayant des informations exploitables. En restant prudent quant aux subtilités impliquées dans l’ACP, on peut éviter les pièges qui conduisent à des interprétations erronées et garantir que l’analyse reste un reflet authentique de l’ensemble de données sous-jacent.
Sujets avancés en analyse en composantes principales
À mesure que le paysage des données continue de s'étendre et de se diversifier, l'analyse en composantes principales (ACP) évolue, embrassant ses racines classiques et ses extensions innovantes pour répondre à la complexité des structures de données modernes. Ce voyage dans les sujets avancés de la PCA révèle la polyvalence de la méthode et son adaptabilité durable en science des données.
Variations de l'ACP
- PCA du noyau: Cette extension de PCA est utilisée pour la réduction de dimensionnalité non linéaire. L'utilisation de méthodes de noyau capture efficacement la structure des données où la relation entre les variables n'est pas linéaire, révélant ainsi des modèles que l'ACP traditionnelle pourrait manquer.
- ACP clairsemée: Dans les ensembles de données où les caractéristiques sont plus nombreuses que les observations, Sparse PCA brille en produisant des composants principaux avec des chargements clairsemés. Il en résulte un modèle plus interprétable, mettant en évidence un sous-ensemble plus restreint de caractéristiques, ce qui est particulièrement utile dans les scénarios de données de grande dimension comme la génomique.
Extensions de l'APC
- ACP incrémentielle: Pour les ensembles de données volumineux qui ne peuvent pas tenir en mémoire, Incremental PCA propose une solution. Il décompose le calcul PCA en mini-lots gérables, mettant à jour les composants de manière incrémentielle, ce qui est également avantageux pour le streaming de données.
- PCA robuste: Les valeurs aberrantes peuvent affecter de manière significative les résultats de l’ACP. Une PCA robuste atténue ce problème en séparant les valeurs aberrantes clairsemées de la structure de bas rang, garantissant ainsi que les points anormaux ne faussent pas les données de base.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusion
L'analyse en composantes principales (ACP) est fermement établie comme une technique indispensable dans la boîte à outils d'analyse de données. Il facilite une compréhension plus approfondie des données en extrayant leurs éléments les plus informatifs. Ce guide a cherché à clarifier la méthodologie du PCA, depuis ses mathématiques fondamentales jusqu'à son application dans divers domaines. Nous avons souligné son utilité pour réduire la dimensionnalité tout en préservant la structure inhérente des données. Ce processus facilite considérablement la visualisation et les analyses ultérieures. Les chercheurs et les data scientists sont encouragés à intégrer la PCA dans leurs flux de travail pour améliorer l'interprétabilité d'ensembles de données complexes. Lorsqu’elle est mise en œuvre de manière réfléchie, la PCA donne un aperçu des modèles dominants au sein des données et rationalise la voie vers une prise de décision plus solide et plus éclairée.
Articles recommandés
Explorez la riche bibliothèque d'articles de notre blog sur des sujets connexes pour en savoir plus sur l'analyse des données.
- Technique Richard Feynman : une voie pour tout apprendre en analyse de données
- Comprendre les distributions des modèles linéaires généralisés
- Les écarts types peuvent-ils être négatifs ? (Récit)
- Box Plot : un outil puissant de visualisation de données
- Modèles linéaires généralisés (Récit)
Foire Aux Questions (FAQ)
L'ACP est une procédure quantitative conçue pour mettre l'accent sur la variation et extraire des modèles significatifs d'un ensemble de données, identifiant efficacement les principaux axes de variabilité.
La PCA joue un rôle essentiel dans la simplification des ensembles de données de grande dimension en conservant les principales tendances et modèles, améliorant ainsi l'interprétabilité sans perte significative d'informations.
PCA fonctionne en calculant les principaux composants qui maximisent la variance au sein de l'ensemble de données, transformant les données en un nouveau système de coordonnées avec ces axes principaux.
En effet, l’ACP est un outil précieux pour les modèles prédictifs car elle réduit la dimensionnalité, améliorant ainsi les performances du modèle en filtrant le bruit et les informations moins pertinentes.
La PCA est largement utilisée dans divers domaines analytiques, notamment la finance, la biostatistique et les sciences sociales, où elle aide à disséquer et à comprendre des données complexes.
Le choix des composants dans l'ACP doit correspondre à l'ampleur de la variance expliquée, généralement évaluée au moyen de tracés d'éboulis ou de variance cumulée, et mis en balance avec l'interprétabilité des données.
L'ACP pourrait être moins efficace avec des ensembles de données où les relations entre les variables sont non linéaires et sensibles à la mise à l'échelle des données.
La PCA est optimale pour les données numériques continues. Des étapes de prétraitement spécifiques sont nécessaires pour les données catégorielles afin de garantir l’application précise des techniques PCA.
PCA aide à l'anonymisation des données en transformant les variables originales en composants principaux, compliquant ainsi l'identification directe des enregistrements individuels.
Les bibliothèques pour PCA sont facilement disponibles dans des environnements logiciels tels que R et Python, notamment dans des packages comme scikit-learn, qui fournissent des outils complets pour l'exécution de PCA.