Random Forest en pratique : un guide essentiel
Vous apprendrez comment Random Forest exploite les arbres de décision pour améliorer la précision prédictive dans des ensembles de données complexes.
Introduction
Forêt aléatoireest un outil d'apprentissage automatique essentiel qui a acquis une grande popularité en science des données grâce à son efficacité pour les tâches de classification et de régression. Son succès repose sur sa capacité à construire plusieurs arbres de décision lors de l'entraînement et à fournir le mode des classes (classification) ou la moyenne des prédictions (régression) de chaque arbre. Ce guide d'introduction vise à démystifier Random Forest pour les débutants en proposant une explication claire et progressive de son fonctionnement, ainsi qu'un guide pratique pour son implémentation en Python. Notre objectif est de donner aux lecteurs les connaissances nécessaires pour comprendre les fondements théoriques de Random Forest et l'appliquer efficacement à leurs projets de science des données, en tirant parti des puissantes capacités de programmation de Python.
Points forts
- Random Forest surpasse les arbres de décision uniques en réduisant le surajustement.
- Le réglage des hyperparamètres dans Random Forest améliore considérablement la précision du modèle.
- Le prétraitement des données est essentiel au succès prédictif de Random Forest.
- Le guide Python étape par étape simplifie la mise en œuvre de Random Forest.
- L'évaluation des modèles Random Forest implique des mesures d'exactitude, de précision et de rappel.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Comprendre la forêt aléatoire
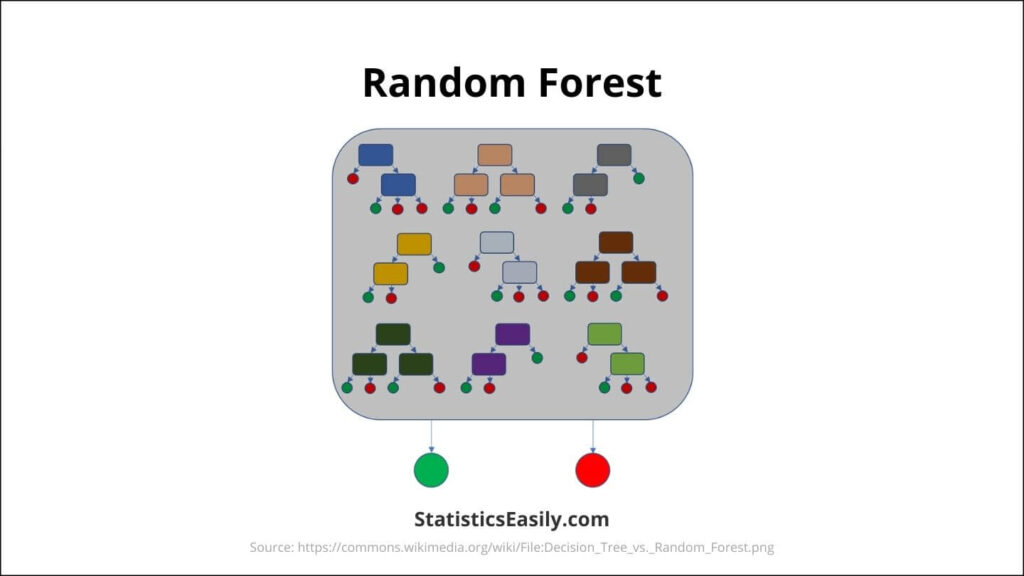
Forêt aléatoireest un algorithme d'apprentissage automatique qui s'appuie sur le concept d'arbres de décision pour fournir un modèle prédictif plus précis et robuste. Il crée de nombreux arbres de décision lors de l'entraînement. Il fournit en sortie la classe, c'est-à-dire le mode des classes (en classification) ou la prédiction moyenne (en régression) de chaque arbre.
Comment fonctionne la forêt aléatoire :
Arbres de décision: La méthode Random Forest repose sur des arbres de décision, modèles de prise de décision simples, organisés en arborescences. Chaque arbre d'une forêt aléatoire fournit une prédiction, et l'algorithme retient la prédiction majoritaire (ou la moyenne dans le cas d'une régression) comme résultat final.
Amorçage: Cette technique sélectionne aléatoirement un sous-ensemble des données pour chaque arbre, assurant ainsi la diversité entre les arbres et contribuant à la robustesse du modèle.
Agrégation (Bagging): L'algorithme agrège ensuite les prédictions des arbres individuels pour produire une prédiction plus précise et plus stable.
Avantages de la forêt aléatoire :
Réduction du surapprentissage: Contrairement aux arbres de décision individuels, souvent sujets au surapprentissage, la méthode Random Forest atténue ce risque grâce à son approche d'ensemble. La moyenne des prédictions de nombreux arbres garantit que la prédiction globale du modèle ne dépend pas excessivement d'une seule partie des données d'entraînement, ce qui permet d'obtenir des résultats plus généralisables.
Haute précision: La force de la méthode Random Forest réside dans l’agrégation des prédictions de plusieurs arbres de décision, chacun entraîné sur un sous-ensemble différent des mêmes données. Cette méthode d’ensemble améliore considérablement la précision des prédictions, surpassant de nombreuses approches à modèle unique sur divers ensembles de données et types de problèmes.
Polyvalence d'application: La conception de Random Forest lui permet d'exceller dans diverses tâches, de la prédiction de résultats catégoriels dans les problèmes de classification à l'estimation de variables continues dans les analyses de régression. Sa gestion robuste des ensembles de données comportant des valeurs manquantes et sa capacité à traiter des données numériques et catégorielles sans prétraitement complexe lui confèrent une flexibilité exceptionnelle.
Analyse de l'importance des variables: L'une des principales forces de Random Forest réside dans son mécanisme de sélection des variables intrinsèque. En analysant l'impact de chaque variable sur la précision des prédictions pour l'ensemble des arbres, Random Forest peut classer l'importance des variables au sein du jeu de données. Cette analyse est essentielle pour comprendre les facteurs déterminants des prédictions. Elle peut guider la sélection des variables lors de l'amélioration du modèle et de l' l'analyse des données processus.
Applications de la forêt aléatoire :
Finance: La méthode Random Forest est largement utilisée dans le secteur financier pour des tâches critiques telles que l'évaluation du risque de crédit par l'analyse des scores de crédit et la prévision des mouvements futurs du marché boursier, contribuant ainsi aux stratégies d'investissement.
Commerce électronique: Cet algorithme améliore l’expérience d’achat en ligne grâce à des systèmes de recommandation qui suggèrent des produits en fonction du comportement et des préférences des utilisateurs. Il joue également un rôle essentiel dans la segmentation des clients en groupes distincts, permettant ainsi des stratégies marketing et promotionnelles ciblées.
Santé: Dans le domaine médical, la méthode des forêts aléatoires contribue au dépistage précoce des maladies en analysant les données des patients afin d’identifier les symptômes révélateurs d’affections spécifiques. Elle permet également de classer les patients en groupes de risque, facilitant ainsi l’élaboration de plans de traitement personnalisés.
Cybersécurité: Face à la sophistication croissante des cybermenaces, Random Forest contribue à la détection et à la prédiction rapides des fraudes et des atteintes à la sécurité potentielles, en tirant parti de la détection d'anomalies dans les modèles de données pour protéger les actifs numériques.
Fondements théoriques des forêts aléatoires
Forêt aléatoirefonctionne selon le principe de l'apprentissage d'ensemble, où plusieurs classificateurs, en l'occurrence des arbres de décision, sont combinés pour résoudre un problème complexe et améliorer les performances du modèle.
Explication détaillée de l'algorithme :
Ensemble d'arbres de décision: Random Forest crée une forêt d'arbres de décision non corrélés, chacun entraîné sur des sous-ensembles aléatoires des données d'entraînement, à l'aide d'une technique de réamorçage.
Sélection aléatoire de caractéristiques: à chaque division, chaque arbre sélectionne un sous-ensemble de caractéristiques aléatoire. Cette aléatoire contribue à diversifier les arbres et à améliorer la précision globale du modèle.
Agrégation: La prédiction finale de la forêt aléatoire est obtenue en agrégeant les prédictions des arbres individuels. Cette agrégation réduit la variance, limite le surapprentissage et améliore la précision prédictive du modèle.
Hyperparamètres et leur impact :
Nombre d'arbres (n_estimateurs): Augmenter le nombre d'arbres améliore généralement les performances du modèle, mais augmente le coût de calcul.
Profondeur maximale (max_depth): contrôle la profondeur de chaque arbre. Des arbres plus profonds peuvent capturer des modèles plus complexes, mais peuvent entraîner un surapprentissage.
Nombre minimal d'échantillons pour la division (min_samples_split): détermine le nombre minimal d'échantillons requis pour diviser un nœud interne. Des valeurs élevées empêchent le modèle d'apprendre des schémas trop spécifiques.
Nombre maximal de caractéristiques (max_features): Taille des sous-ensembles aléatoires de caractéristiques à prendre en compte lors de la division d’un nœud. Ce paramètre influence la diversité des arbres dans la forêt.
Mesurer l'efficacité :
Exactitude: Proportion d’observations correctement prédites par rapport au nombre total d’observations. C’est une mesure précieuse pour les problèmes de classification équilibrée.
Matrice de confusion: Analyse détaillée des performances du modèle, incluant les vrais positifs, les vrais négatifs, les faux positifs et les faux négatifs.
Précision, rappel et score F1: La précision correspond au rapport entre les observations positives correctement prédites et le nombre total d’observations positives prédites. Le rappel (ou sensibilité) mesure le rapport entre les observations positives correctement prédites et l’ensemble des observations de la classe réelle. Le score F1 est la moyenne pondérée de la précision et du rappel. Ces indicateurs sont essentiels pour les jeux de données déséquilibrés.
Préparation de vos données
Un prétraitement efficace des données est une étape cruciale de l'apprentissage automatique qui a un impact significatif sur les performances de modèles comme Random Forest. Cette section décrit les étapes essentielles de nettoyage et de préparation des données, garantissant que les données sont structurées de manière optimale pour la modélisation des forêts aléatoires.
Importance du prétraitement des données :
Le prétraitement des données transforme les données brutes en un ensemble de données propre qui peut être utilisé directement pour les modèles d'apprentissage automatique. Ce processus est vital car il influence directement la capacité du modèle à apprendre et à faire des prédictions précises. Pour Random Forest, où plusieurs arbres de décision sont impliqués, le prétraitement garantit la cohérence et la qualité de l'ensemble de données, permettant à l'algorithme d'identifier les modèles plus efficacement.
Étapes de nettoyage et de préparation des données :
1. Gestion des valeurs manquantes: Random Forest peut gérer les valeurs manquantes dans une certaine mesure. Toutefois, il est généralement recommandé d’imputer ces valeurs manquantes à l’aide de stratégies telles que l’imputation par la moyenne pour les variables numériques et l’imputation par le mode pour les variables catégorielles.
2. Encodage des variables catégorielles: Convertissez les variables catégorielles au format numérique grâce à des techniques d'encodage telles que l'encodage one-hot ou l'encodage par étiquette, car Random Forest ne peut pas traiter les données textuelles brutes.
3. Mise à l'échelle des caractéristiques: Bien que Random Forest ne soit pas aussi sensible à la mise à l'échelle des caractéristiques que des algorithmes comme SVM ou KNN, s'assurer que toutes les caractéristiques sont à la même échelle peut contribuer à améliorer la convergence du modèle et l'interprétabilité des scores d'importance des caractéristiques.
4. Suppression des variables non pertinentes: Éliminez les variables qui ne contribuent pas à la prédiction ou qui risquent d’introduire du bruit. Bien que Random Forest sélectionne les variables aléatoirement lors de l’entraînement, réduire la dimensionnalité en amont permet de diminuer le temps et la complexité de l’entraînement.
Fractionner l'ensemble de données :
Ensembles d'entraînement et de test: Divisez vos données en ensembles d'entraînement et de test afin d'évaluer les performances du modèle sur des données non vues lors de l'entraînement. Un ratio de division typique est de 70/30 ou 80/20, la partie la plus importante étant utilisée pour l'entraînement.
Validation croisée: Envisagez d’utiliser des techniques de validation croisée, notamment la validation croisée à k plis, afin de garantir la cohérence des performances du modèle sur différents sous-ensembles de données.
Application pratique de forêt aléatoire avec Python
L'utilisation efficace de Random Forest enPythonpermet d'allier la compréhension théorique de l'algorithme à des compétences pratiques en programmation. Cette section vous guide dans la configuration de votre environnement Python, l'implémentation de Random Forest à l'aide de la bibliothèquescikit-learnet son application à un jeu de données réel.
Un exemple pratique : prédire les espèces d'iris
L'ensemble de données Iris contient 150 plantes d'iris, classées en trois espèces en fonction de quatre caractéristiques : la longueur des sépales, la largeur des sépales, la longueur des pétales et la largeur des pétales. Le modèle Random Forest apprend des données d’entraînement et prédit avec précision les espèces d’iris.
En suivant les étapes ci-dessous, vous pouvez implémenter des forêts aléatoires en Python pour divers ensembles de données, pas seulement l'ensemble de données Iris. Ajustez les hyperparamètres du modèle, tels que n_estimators et max_degree, pour améliorer les performances en fonction de votre ensemble de données et de votre tâche spécifiques.
Les extraits de code fournis sont conçus pour être simples à suivre, avec des explications pour chaque étape afin de faciliter la compréhension et la mise en œuvre. Cette application pratique démontre la puissance des forêts aléatoires dans la modélisation prédictive. Il fournit une base solide pour explorer des projets de science des données plus complexes.
Configuration de votre environnement Python
Pour travailler avec Random Forest en Python, assurez-vous que Python est installé sur votre ordinateur. Utilisez les packages suivants :
- NumPy: Pour gérer les tableaux et les matrices.
- Pandas: Pour la manipulation et l’analyse des données.
- Scikit-learn (sklearn): Fournit l'algorithme Random Forest et des fonctionnalités supplémentaires pour créer des modèles prédictifs.
- Matplotlib/Seaborn: Pour visualiser les données et les résultats du modèle.
Installez ces packages en utilisant pip :
pip install numpy pandas scikit-learn matplotlib seaborn
Implémentation de Random Forest avec sklearn
Le module sklearn.ensemble comprend RandomForestClassifier pour les tâches de classification et RandomForestRegressor pour les tâches de régression. Voici un guide étape par étape pour utiliser RandomForestClassifier :
1. Importez les bibliothèques nécessaires :
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
2. Chargez votre jeu de données :nous utiliserons le jeu de données Iris, un classique des exemples d’apprentissage automatique, pour cet exemple.
from sklearn.datasets import load_iris
iris = load_iris()
X = iris.data
y = iris.target
3. Divisez l'ensemble de données :divisez vos données en ensembles d'entraînement et de test pour évaluer les performances du modèle.
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
4. Initialiser et entraîner le modèle :Créez une instance de RandomForestClassifier et ajustez-la à vos données d’entraînement.
clf = RandomForestClassifier(n_estimators=100, random_state=42)
clf.fit(X_train, y_train)
5. Effectuer des prédictions et évaluer le modèle :utiliser le modèle entraîné pour prédire l’ensemble de test et évaluer la précision.
y_pred = clf.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, y_pred)}")
Résultats du modèle et interprétation
Après avoir entraîné le modèle et effectué des prédictions, il est crucial d’interpréter les résultats pour comprendre ses performances et comment les améliorer.
Évaluation des performances du modèle :Commencez par examiner la précision du modèle, puis explorez des indicateurs plus descriptifs.
# Model Accuracy
print(f"Model Accuracy: {accuracy_score(y_test, y_pred):.2f}")
Matrice de confusion :Une matrice de confusion permet de mieux comprendre les prédictions correctes et incorrectes de chaque classe.
cm = confusion_matrix(y_test, y_pred)
sns.heatmap(cm, annot=True, fmt="d", cmap="viridis", xticklabels=iris.target_names, yticklabels=iris.target_names)
plt.xlabel('Predicted')
plt.ylabel('Actual')
plt.title('Confusion Matrix')
plt.show()
Rapport de classification :Le rapport de classification comprend des indicateurs tels que la précision, le rappel et le score F1 pour chaque classe.
print(classification_report(y_test, y_pred, target_names=iris.target_names))
Importance des caractéristiques :Comprendre quelles caractéristiques ont le plus d’impact sur les décisions de votre modèle peut fournir des informations précieuses sur l’ensemble de données.
feature_importance = clf.feature_importances_
sns.barplot(x=feature_importance, y=iris.feature_names)
plt.title('Feature Importance')
plt.show()
Interprétation du modèle
Le score de précision, la matrice de confusion et le rapport de classification offrent collectivement une vue complète des performances du modèle. La grande précision indique l'efficacité du modèle dans la classification des espèces d'iris, tandis que la matrice de confusion et le rapport de classification détaillent sa précision, son rappel et ses scores f1 dans toutes les classes.
Le graphique de l'importance des caractéristiques révèle quelles caractéristiques des fleurs d'iris (comme la longueur ou la largeur des pétales) influencent les décisions de classification du modèle. Ces informations sont précieuses pour comprendre le processus de prise de décision du modèle Random Forest et les futurs efforts d'ingénierie ou de sélection de fonctionnalités.
En interprétant ces résultats, nous pouvons conclure que le classificateur Random Forest est très efficace pour cet ensemble de données, fournissant une base solide pour les tâches de modélisation prédictive. Expérimenter différents ensembles de données ou ajuster les hyperparamètres pourrait améliorer les performances du modèle ou son adaptabilité à divers problèmes.
Interprétation des arbres de décision individuels dans une forêt aléatoire
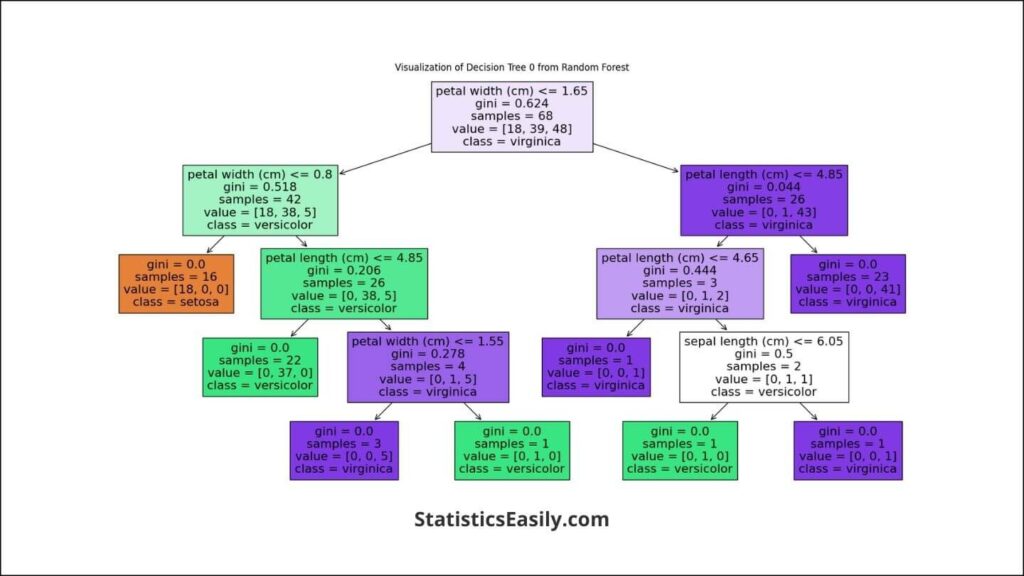
Bien que Random Forest soit une collection d’arbres de décision, chaque arbre contribue au résultat. La visualisation d'arbres individuels peut fournir un aperçu du processus de prise de décision à un niveau plus granulaire. Examinons un de ces arbres de notre modèle Random Forest :
Visualisation d'un arbre de décision de la forêt aléatoire :
# Visualize the first decision tree from the Random Forest
tree_index = 0
plt.figure(figsize=(20,10))
plot_tree(clf.estimators_[tree_index],
          feature_names=iris.feature_names,
          class_names=iris.target_names,
          filled=True,
          rounded=True)
plt.title(f'Decision Tree Visualization: Tree {tree_index}')
plt.show()
Cette visualisation montre comment un arbre de décision unique au sein de Random Forest effectue des classifications. Il commence en haut par un nœud racine, puis se divise en branches et nœuds de décision en fonction des valeurs des caractéristiques, et se termine enfin par des nœuds feuilles représentant les prédictions de classe.
Analyse de la structure arborescente :
Chaque nœud de l'arborescence représente une décision basée sur la valeur d'une fonctionnalité particulière. Par exemple, un nœud peut diviser les données en fonction de la longueur ou de la largeur des pétales d'une fleur d'iris. Les branches représentent le résultat de cette décision, conduisant à de nouveaux nœuds de décision ou nœuds feuilles. Les nœuds feuilles fournissent les prédictions de classe finales lorsqu'un ensemble de critères déterminés par le chemin depuis la racine est rempli.
La profondeur et la complexité de cet arbre indiquent la stratégie de classification du modèle. En pratique, Random Forest combine les prédictions de plusieurs de ces arbres pour établir une classification finale plus précise, exploitant ainsi les forces de chaque arbre tout en compensant leurs faiblesses.
L'inclusion d'une visualisation d'arbre de décision telle que celle générée ci-dessus peut enrichir votre article en permettant aux lecteurs de visualiser le processus prédictif. Il démystifie le fonctionnement du modèle et fournit un exemple concret de la manière dont Random Forest exploite plusieurs chemins de décision pour parvenir à une décision de classification.
Évaluation de votre modèle
Après avoir implémenté le modèle Random Forest à l'aide de Python, la prochaine étape cruciale consiste à évaluer ses performances. Cela implique l’utilisation de mesures spécifiques pour comprendre dans quelle mesure le modèle prédit les résultats sur de nouvelles données invisibles. Cette section couvre les mesures d'évaluation critiques et propose des conseils d'amélioration et de réglage du modèle.
Comment évaluer les performances de votre modèle de forêt aléatoire :
Les mesures d'évaluation sont essentielles pour évaluer l'exactitude et l'efficacité de votre modèle Random Forest. Voici les métriques les plus couramment utilisées :
Exactitude: Il s’agit de la mesure la plus simple, calculée en divisant le nombre de prédictions correctes par le nombre total de prédictions. Bien qu’utile, l’exactitude seule peut être trompeuse, notamment dans les ensembles de données comportant des classes déséquilibrées.
Précision et rappel: La précision (la proportion de vrais positifs parmi toutes les prédictions positives) et le rappel (la proportion de vrais positifs parmi tous les positifs réels) sont essentiels lorsque les coûts des faux positifs et des faux négatifs sont élevés, par exemple dans les scénarios de diagnostic médical ou de détection de fraude.
F1 Score: Le score F1 est la moyenne harmonique de la précision et du rappel, offrant une mesure unique pour évaluer leur équilibre. Un score F1 atteint sa valeur optimale à 1 (précision et rappel parfaits) et sa valeur minimale à 0.
Matrice de confusion: Tableau permettant de décrire les performances d'un modèle de classification sur un ensemble de données de test dont les valeurs réelles sont connues. Elle permet de visualiser les prédictions du modèle, notamment les vrais positifs, les faux positifs, les vrais négatifs et les faux négatifs.
Interprétation des résultats :
Comprendre ces métriques vous permet d'évaluer avec précision les performances du modèle. Par exemple, un taux de précision élevé peut sembler excellent à première vue. Cependant, une inspection plus approfondie via la précision, le rappel et le score F1 pourrait révéler des domaines dans lesquels le modèle a du mal, comme par exemple l'incapacité à prédire avec précision une classe particulière.
Conseils pour l'amélioration et le réglage du modèle :
Réglage des hyperparamètres: Les modèles de forêts aléatoires possèdent plusieurs hyperparamètres, tels que le nombre d’arbres (n_estimators) et leur profondeur (max_depth), qui peuvent avoir un impact significatif sur leurs performances. L’utilisation de méthodes de recherche par grille ou de recherche aléatoire permet de trouver la combinaison optimale de ces hyperparamètres pour votre jeu de données.
Sélection des caractéristiques: Les forêts aléatoires peuvent hiérarchiser l’importance des caractéristiques. En analysant et en éliminant les caractéristiques les moins importantes, vous pouvez réduire la complexité du modèle et améliorer ses performances.
Validation croisée: La mise en œuvre de la validation croisée, comme la validation croisée k-fold, permet de garantir que les performances de votre modèle sont cohérentes sur différents sous-ensembles de vos données, augmentant ainsi la robustesse de votre modèle.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusion
Cet article a fourni un guide complet pour comprendre et appliquer Random Forest en Python, couvrant ses fondements théoriques, la préparation des données, la mise en œuvre pratique et l'évaluation du modèle. Grâce à sa capacité à gérer efficacement les tâches de classification et de régression, Random Forest reste un outil puissant dans l'arsenal des data scientists, offrant une grande précision et une robustesse contre le surapprentissage. L'encouragement à expérimenter différents ensembles de données et à confronter divers problèmes de modélisation prédictive souligne la polyvalence et l'adaptabilité de Random Forest. En suivant les étapes détaillées, depuis la configuration de l'environnement Python jusqu'à l'évaluation des performances du modèle, les lecteurs sont bien équipés pour exploiter Random Forest dans leurs projets de science des données, repoussant ainsi les limites de l'analyse prédictive.
Articles recommandés
Découvrez plus d’informations et de didacticiels sur des sujets liés à la science des données en consultant nos autres articles.
- Arbres de décision : de la théorie à la pratique en Python pour les futurs data scientists
- Comprendre l'échantillonnage aléatoire : techniques essentielles en analyse de données
- Échantillonnage aléatoire sur Excel : une analyse approfondie
- Régression logistique à l'aide de Scikit-Learn (Récit)
- Générer un nombre aléatoire
Foire Aux Questions (FAQ)
Q1 : Qu’est-ce que Random Forest ?C’est une méthode d’apprentissage automatique polyvalente capable d’effectuer des tâches de régression et de classification, en utilisant plusieurs arbres de décision et en faisant la moyenne de leurs prédictions pour améliorer la précision et contrôler le surapprentissage.
Q2 : Comment fonctionne une forêt aléatoire ?Une forêt aléatoire crée une « forêt » d’arbres de décision aléatoires pour rendre ses prédictions plus précises que n’importe quel arbre de décision unique en faisant la moyenne des résultats ou en utilisant le vote majoritaire.
Q3 : Pourquoi la forêt aléatoire est-elle préférée à d’autres algorithmes ?Elle est préférée en raison de sa polyvalence, de sa capacité à traiter de grands ensembles de données à haute dimensionnalité et de sa capacité à gérer les valeurs manquantes, ce qui la rend robuste face au surapprentissage.
Q4 : Quelles sont les principales applications de Random Forest ?Il est largement utilisé dans divers domaines, tels que la banque, la médecine, le marché boursier et le commerce électronique, pour la détection des fraudes, la prédiction des maladies, la prédiction du cours des actions et la segmentation de la clientèle.
Q5 : Comment prépare-t-on les données pour Random Forest ?La préparation des données comprend le nettoyage, la gestion des valeurs manquantes, l’encodage des variables catégorielles et la division de l’ensemble de données en ensembles d’entraînement et de test.
Q6 : Que sont les hyperparamètres dans Random Forest et comment affectent-ils le modèle ?Les hyperparamètres influencent la complexité et les performances du modèle, notamment le nombre d’arbres, leur profondeur et le nombre minimal d’échantillons à diviser. Leur optimisation peut améliorer considérablement la précision.
Q7 : Comment évaluer l’efficacité d’un modèle Random Forest ?Les indicateurs d’évaluation standard comprennent l’exactitude, la précision, le rappel, le score F1 et la matrice de confusion, qui permettent d’évaluer les performances prédictives et l’exactitude du modèle.
Q8 : Quels sont les défis liés à l’utilisation des forêts aléatoires ?Bien que puissantes, les forêts aléatoires peuvent être gourmandes en ressources de calcul et difficiles à interpréter par rapport à des modèles plus simples, et leurs performances peuvent être sensibles aux données bruitées.
Q9 : Comment optimiser un modèle Random Forest pour de meilleures performances ?L’optimisation du modèle consiste à ajuster les hyperparamètres tels que le nombre d’arbres, la profondeur maximale et le nombre minimal d’échantillons répartis à l’aide de techniques de recherche par grille ou aléatoire afin de trouver les paramètres les plus performants.
Q10 : L’algorithme Random Forest peut-il traiter des données catégorielles et numériques ?Oui, Random Forest peut traiter un mélange de données catégorielles et numériques. Il utilise des techniques comme l’encodage one-hot pour les variables catégorielles afin de rendre les données compatibles avec la modélisation.