Arbres de décision : de la théorie à la pratique en Python pour les futurs data scientists
Vous apprendrez les principes fondamentaux des arbres de décision et leur application pratique en Python pour des informations basées sur les données.
Introduction
Arbres de décisionsont une pierre angulaire de l'analyse des données, de la science des données et de l'apprentissage automatique. Grâce à leur structure intuitive, ils offrent un cadre qui simplifie les processus décisionnels complexes. Ces modèles décomposent les données en segments compréhensibles, permettant ainsi aux experts chevronnés comme aux novices d'identifier clairement les tendances et les informations pertinentes. L'élégance desArbres de décisionréside dans leur capacité à transformer des ensembles de données complexes en informations visuellement compréhensibles et organisées logiquement, facilitant ainsi la prise de décisions éclairées et la réalisation de prédictions. Cette introduction posera les bases de l'utilisationArbres de décisiondans Python, guidant les futurs data scientists de la théorie à la pratique.
Points forts
- Les arbres de décision classent les données avec une simplicité et une précision inégalées.
- Le scikit-learn de Python facilite la mise en œuvre des arbres de décision.
- Les arbres de décision éclairent des données complexes, offrant des voies claires vers la prise de décision.
- Les techniques d'optimisation améliorent la précision des arbres de décision sans surajustement.
- La visualisation des arbres de décision en Python démystifie les processus d'analyse des données.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Comprendre les arbres de décision
Arbres de décisionconstituent une méthode d'analyse de données qui présente une structure hiérarchique des décisions et de leurs conséquences possibles, incluant les résultats aléatoires, les coûts des ressources et l'utilité. Cette méthode est particulièrement pertinente en science des données pour sa clarté et son interprétabilité, qui facilitent la prise de décision.
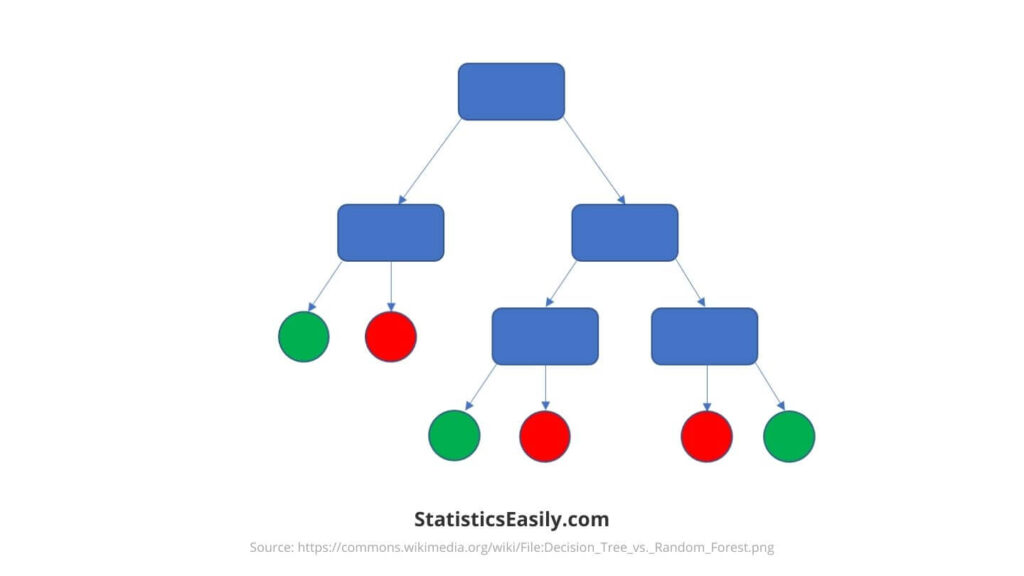
Au cœur de cela,Arbres de décision, par essence, divisent les données en branches selon des critères de décision issus des caractéristiques de l'ensemble de données. Ces divisions s'effectuent au niveau des nœuds, le premier nœud constituant la racine de l'arbre. Chaque nœud représente un point de décision, et les branches représentent le résultat de cette décision, ce qui conduit à des divisions successives jusqu'à ce que les nœuds feuilles représentent les résultats ou prédictions.
La création d'unarbre de décisionimplique de déterminer le critère de division le plus pertinent à chaque étape. Ce choix repose sur des mesures telles que l'impureté de Gini ou l'entropie dans les tâches de classification, et la réduction de la variance dans les tâches de régression. Ces critères permettent de sélectionner les divisions qui purifient le plus efficacement les nœuds enfants.
La profondeur d'unarbre de décisionmesure le chemin le plus long entre la racine et une feuille. Un arbre plus profond peut modéliser les données d'entraînement avec une plus grande précision, mais risque également de surapprendre (le modèle fonctionne alors bien sur les données d'entraînement, mais mal sur les données inconnues). À l'inverse, un arbre peu profond peut être trop simpliste pour saisir la structure sous-jacente des données, ce qui conduit à un sous-apprentissage.
Arbres de décisionsont appréciés pour leur capacité à modéliser des processus décisionnels complexes grâce à une combinaison de simplicité et de robustesse. Ils peuvent traiter des données numériques et catégorielles, ce qui les rend polyvalents pour un large éventail d'applications. De plus, leur structure facilite la visualisation et l'interprétation, ce qui en fait un outil accessible aux data scientists pour communiquer leurs résultats.
Le fondement théorique desArbres de décisionmet l'accent sur la mise en œuvre technique et la présentation claire des décisions fondées sur les données. Ceci s'inscrit dans la quête de vérité et de compréhension propre à la science des données, illustrant comment les données peuvent être analysées en profondeur pour révéler des informations permettant de prendre des décisions éclairées et pertinentes. Grâce à cette méthode, les data scientists peuvent appréhender la complexité de leurs ensembles de données, identifier des tendances et prédire les résultats avec un juste équilibre entre précision et simplicité.
L'importance des arbres de décision dans l'analyse des données
L'application deArbres de décisiondépasse largement le cadre d'un seul domaine, démontrant une polyvalence inégalée dans divers secteurs, tels que l'analyse de données, la santé, la finance, etc. En matière de prise de décision, ils permettent par exemple d'évaluer les conséquences potentielles des choix stratégiques, d'analyser les risques et de segmenter la clientèle. Les professionnels de santé utilisentArbres de décisionpour la prédiction des diagnostics, l'évaluation des risques pour les patients et l'analyse de l'efficacité des traitements, ouvrant ainsi la voie à une médecine personnalisée et à une meilleure prise en charge des patients.
L'un des principaux avantages desArbres de décisionréside dans leur interprétabilité. Contrairement à de nombreux modèles complexes qui fonctionnent comme des « boîtes noires »,Arbres de décisionvisualisent le processus décisionnel, permettant ainsi aux utilisateurs de comprendre comment les conclusions sont tirées. Cette transparence est précieuse dans des domaines où la compréhension du raisonnement sous-jacent à une prédiction est aussi cruciale que la prédiction elle-même, comme la santé et la finance.
De plus, la simplicité d'utilisation desArbres de décisionest remarquable. Ils ne nécessitent pas de préparation poussée des données ; les données catégorielles et numériques peuvent être traitées directement, et les relations non linéaires entre les paramètres n'affectent pas leurs performances. Cette convivialité garantit l' accessibilitéArbres de décisionrester accessible à un large public, y compris ceux ayant une expertise statistique ou en programmation limitée.
L'atout majeur desArbres de décisionen analyse de données réside dans leur capacité à allier simplicité et puissance prédictive. Applicables aux problèmes de régression et de classification, ils constituent un outil polyvalent pour le data scientist. De plus, leur structure facilite l'application de techniques telles que l'élagage, qui permet d'éviter le surapprentissage et garantit la robustesse et la fiabilité du modèle.
Préparation de vos données pour un modèle d'arbres de décision
La préparation des données est une étape cruciale de la modélisation, notamment avecArbres de décision. Cette section détaille les étapes essentielles de la préparation de votre jeu de données : son nettoyage et sa division en ensembles d’entraînement et de test. Chaque étape garantit l’intégrité de votre modèle et témoigne de la recherche rigoureuse de la vérité en science des données.
Le nettoyage des donnéesconsiste à identifier et corriger les erreurs ou incohérences dans votre ensemble de données. Cela peut impliquer de traiter les valeurs manquantes, de supprimer les doublons ou de corriger les erreurs de saisie. PourArbres de décision, il est crucial de garantir l'exactitude des données, car ces modèles interprètent directement la structure et le contenu des données. Des données propres constituent le fondement de modèles fiables et interprétables.
La division de vos donnéesen ensembles d'entraînement et de test est une étape cruciale pour évaluer l'efficacité de votre modèlearbre de décision. Les données sont généralement réparties aléatoirement, selon une proportion standard de 70 % pour l'entraînement et 30 % pour le test. L'ensemble d'entraînement sert à construire le modèle, tandis que l'ensemble de test évalue ses performances sur des données inédites. Cette étape est essentielle pour évaluer la capacité de généralisation du modèle et garantir qu'il peut effectuer des prédictions précises sur de nouvelles données. Elle est au cœur de la création de modèles qui reflètent la réalité et auxquels on peut se fier pour prendre des décisions.
Construire vos premiers arbres de décision en Python
La création d'unarbre de décisionen Python simplifie l'analyse de données et l'apprentissage automatique, les rendant accessibles même aux débutants. Cette section vous guide pas à pas dans la création de votre premierarbre de décisionen Python, en privilégiant la pratique et la clarté.
Configuration de votre environnement Python
1. Assurez-vous d'avoir Python installé sur votre ordinateur. Vous pouvez le télécharger surpython.org.
2. Installez les bibliothèques nécessaires à l'aide de pip, le programme d'installation du package Python. Ouvrez votre terminal ou votre invite de commande et exécutez :
pip install numpy pandas scikit-learn matplotlib
Ces commandes installent NumPy et pandas pour la manipulation des données, scikit-learn pour l'apprentissage automatique et matplotlib pour la visualisation.
Chargement et préparation de votre ensemble de données
1. Importez les bibliothèques et chargez votre ensemble de données. Pour ce didacticiel, utilisons l'ensemble de données Iris, un ensemble de données simple mais perspicace disponible directement dans scikit-learn.
from sklearn.datasets import load_iris
import pandas as pd

iris = load_iris()
data = pd.DataFrame(data=iris.data, columns=iris.feature_names)
data['target'] = iris.target
2. Nettoyez votre ensemble de données en recherchant et en traitant les valeurs manquantes ou les valeurs aberrantes. L'ensemble de données Iris est déjà propre, aucune autre action n'est donc nécessaire ici.
3. Divisez votre ensemble de données en ensembles d'entraînement et de test pour évaluer avec précision les performances de votre modèle.
from sklearn.model_selection import train_test_split

X = data.drop('target', axis=1)
y = data['target']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
Implémentation d'un modèle d'arbre de décision avec Scikit-learn
1. Importez le DecisionTreeClassifier depuis scikit-learn et créez une instance du classificateur.
from sklearn.tree import DecisionTreeClassifier

dtree = DecisionTreeClassifier(random_state=42)
2. Adaptez le modèle à vos données d'entraînement.
dtree.fit(X_train, y_train)
Visualiser l'arbre de décision
1. Visualisez l'arbre de décisionentraîné pour comprendre comment il prend ses décisions.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

plt.figure(figsize=(20,10))
plot_tree(dtree, filled=True, feature_names=iris.feature_names, class_names=iris.target_names)
plt.show()
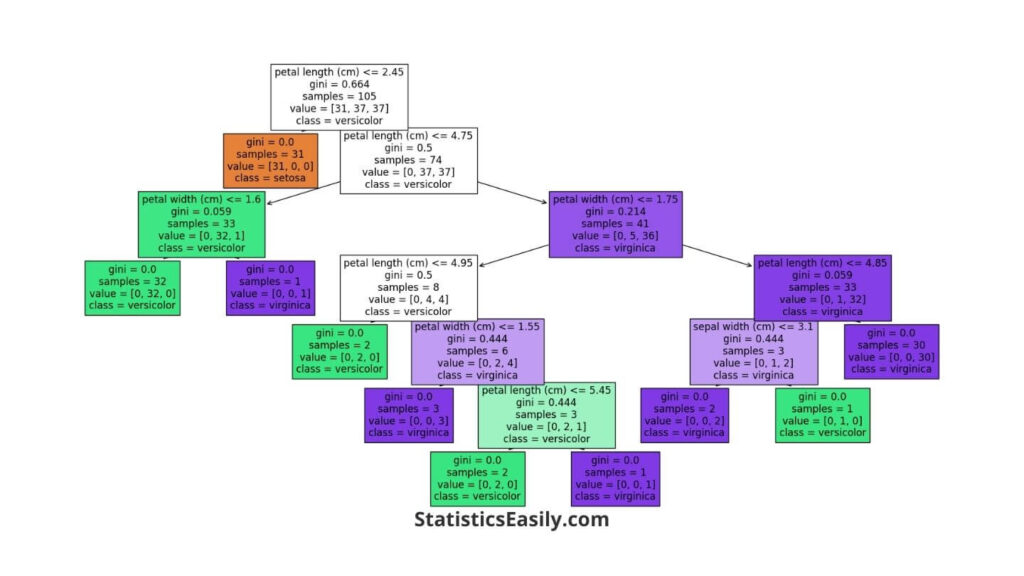
Cette image représente un modèle d'arbre de décision formé pour classer les fleurs d'iris dans l'une des trois espèces. Il est basé sur l'ensemble de données Iris, qui comprend des mesures telles que la longueur et la largeur des pétales. Voici un aperçu de ce que nous voyons dans cet arbre de décision :
- Nœuds (Rectangles) :Chaque rectangle est un nœud qui prend une décision. L'arborescence commence par le nœud racine en haut et se termine par le nœud feuille. Les nœuds testent les données sur la base de critères spécifiques, par exemple si la longueur des pétales est inférieure à une valeur particulière.
- Branches (lignes reliant les nœuds) :Ces lignes guident le chemin d'une décision à la suivante en fonction des critères fixés par les nœuds.
- Nœuds feuilles (rectangles de fin) :Les nœuds finaux (feuilles) nous donnent la classe prédite (type de fleur d'iris). Ils ne se divisent pas davantage car ils représentent la prédiction la plus éclairée que le modèle puisse faire avec les données fournies.
- Gini (métrique en nœuds) :Le score de Gini mesure la pureté : 0 est entièrement pur (tous les échantillons d'un nœud appartiennent à la même classe) et des scores plus élevés indiquent un mélange de classes au sein d'un nœud.
- Exemples (dans les nœuds) :Cela nous indique combien d'exemples tirés des données sont pris en compte à ce stade de l'arborescence.
- Valeur (En nœuds) :Ce tableau montre la distribution des classes dans les échantillons sur ce nœud. Par exemple, [0, 34, 2] signifie 0 setosas, 34 versicolors et 2 virginicas.
- Classe (dans les nœuds) :Il s'agit de la prédiction du modèle à ce nœud. L'arbre de décision étiquettera n'importe quel point de données de ce nœud avec cette classe.
En regardant cet arbre de décision, nous pouvons retracer le cheminement décisionnel de haut en bas. Par exemple, supposons que nous ayons une fleur d’iris dont les pétales mesurent moins de 2.45 cm. Dans ce cas, l'arbre de décision le classera comme setosa (comme on le voit dans le nœud feuille le plus à gauche). L'arborescence fournit un moyen transparent de voir exactement comment le modèle arrive à une conclusion en fonction des fonctionnalités d'entrée.
Exemple pratique
L'utilisation du jeu de données Iris vous permet d'explorer les subtilités desArbres de décisionsans être submergé par des données complexes. Grâce à sa simplicité et à son applicabilité concrète, ce jeu de données garantit clarté et intérêt, vous aidant ainsi à maîtriser les bases desArbres de décisionen Python.
Vous avez créé et visualisé votre premierarbre de décisionen suivant ces étapes. Ce processus, de la configuration de votre environnement à l'analyse d'un jeu de données simple, illustre la puissance et l'accessibilité de l'apprentissage automatique en Python.Arbres de décisionoffrent une méthode robuste et interprétable aux data scientists de tous niveaux, que ce soit pour l'analyse prédictive, l'exploration de données ou l'interprétation de jeux de données complexes.
Évaluation et optimisation de votre modèle d'arbres de décision
Après avoir créé votre modèle d'arbre de décision en Python, les prochaines étapes critiques sont l'évaluation et l'optimisation. Ces processus garantissent que votre modèle fonctionne efficacement et fait des prédictions précises.
Évaluation de votre modèle d'arbre de décision
Les performances de votre modèle d'arbre de décision peuvent être évaluées à l'aide de mesures telles que l'exactitude, la précision et le rappel. L'exactitude mesure la proportion de prédictions correctes, la précision reflète la capacité du modèle à identifier uniquement les instances pertinentes et le rappel indique la capacité du modèle à trouver tous les cas pertinents dans l'ensemble de données.
from sklearn.metrics import accuracy_score, precision_score, recall_score

predictions = dtree.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, predictions)}")
print(f"Precision: {precision_score(y_test, predictions, average='macro')}")
print(f"Recall: {recall_score(y_test, predictions, average='macro')}")
Techniques d'optimisation des arbres de décision
L'optimisation de votre arbre de décision implique d'ajuster les paramètres pour améliorer les performances et éviter le surajustement. Les techniques clés comprennent :
Élagage: Réduction de la taille de l’arbre pour supprimer les sections peu pertinentes pour la classification des instances. L’élagage peut être réalisé en définissant des paramètres tels que `max_depth`, qui limite la profondeur de l’arbre, et `min_samples_split`, qui spécifie le nombre minimal d’échantillons requis pour diviser un nœud interne.
dtree_optimized = DecisionTreeClassifier(max_depth=3, min_samples_split=5, random_state=42)
dtree_optimized.fit(X_train, y_train)
Profondeur maximale: Limiter la profondeur de l’arbre permet d’éviter que le modèle ne devienne trop complexe et ne surapprenne les données d’entraînement.
Nombre minimal d'échantillons pour la division d'un nœud: Définir un nombre minimal d'échantillons pour qu'un nœud soit divisé permet de rendre le modèle plus général et moins susceptible de s'adapter au bruit dans l'ensemble d'entraînement.
Considérations éthiques dans l'optimisation des modèles
L'optimisation d'un modèle va au-delà de simples ajustements techniques ; cela implique des considérations éthiques, notamment pour garantir que les prédictions du modèle sont justes et ne perpétuent pas les biais. Le surajustement affecte la précision du modèle sur les données invisibles. Cela peut conduire à des décisions qui pourraient ne pas refléter la véritable nature des données ou la réalité. Il est crucial d'équilibrer la complexité du modèle avec son interprétabilité et son équité, en garantissant que les décisions prises par le modèle sont justifiables et éthiques.
Veiller à ce que les modèles reflètent fidèlement la réalité souligne notre engagement envers la vérité. Cela implique des tests rigoureux sur divers ensembles de données pour détecter et atténuer les biais. Les data scientists ont la responsabilité éthique de garantir que leurs modèles servent le bien, en évitant les dommages qui pourraient provenir de prédictions inexactes.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusion
L'exploration des subtilitésArbres de décisiona révélé leur formidable potentiel pour rendre la science des données à la fois accessible et percutante. Alliant simplicité et profondeur,Arbres de décisionoffrent une perspective unique sur les ensembles de données complexes, facilitant ainsi la prise de décisions éclairées. Cette exploration, des concepts théoriques à l'application pratique en Python, met en lumière la polyvalence et la puissance desArbres de décision. Elle témoigne de la beauté même de la science des données.
Articles recommandés
Découvrez d’autres techniques et informations de pointe en science des données sur notre blog. Plongez plus profondément dans les arbres de décision et au-delà pour une compréhension complète et une application pratique dans vos projets. Explorez maintenant !
- Statistiques descriptives et statistiques inférentielles : simplifier l'analyse des données
- Modèles linéaires généralisés en Python : un guide complet
- Régression linéaire avec Scikit-Learn : un guide complet
- P-hacking : une menace cachée pour une analyse fiable des données
- Régression logistique à l'aide de Scikit-Learn (Récit)
- Top 5 des outils gratuits pour l’analyse des données en 2024
Foire Aux Questions (FAQ)
Q1 : Que sont les arbres de décision ?Les arbres de décision sont des modèles prédictifs non linéaires utilisés pour les tâches de classification et de régression en science des données.
Q2 : Pourquoi les arbres de décision sont-ils importants dans l’analyse des données ?Ils offrent une vision intuitive et claire des ensembles de données complexes, ce qui les rend essentiels pour des processus de prise de décision éclairés.
Q3 : Comment fonctionnent les arbres de décision en Python ?Les bibliothèques Python, comme scikit-learn, permettent une implémentation et une visualisation faciles des arbres de décision.
Q4 : Les arbres de décision peuvent-ils être utilisés à la fois pour la classification et la régression ?Oui, les arbres de décision peuvent gérer efficacement les deux types de tâches, ce qui en fait des outils polyvalents en science des données.
Q5 : Qu’est-ce qui rend les arbres de décision si précieux ?Leur simplicité et leur interprétabilité, sans sacrifier la précision, les rendent inestimables pour les analystes et les scientifiques.
Q6 : Comment évaluer les performances d’un arbre de décision ?En utilisant des métriques comme l’exactitude, la précision et le rappel, ainsi qu’une inspection visuelle de l’arbre lui-même.
Q7 : Quels sont les principaux défis posés par les arbres de décision ?Le surapprentissage peut s’avérer problématique et nécessite des techniques comme l’élagage pour gérer la complexité de l’arbre.
Q8 : Comment les arbres de décision gèrent-ils les données catégorielles et numériques ?Ils peuvent intrinsèquement gérer les deux types, en divisant les nœuds en fonction du type de données afin d’optimiser les décisions.
Q9 : Qu’est-ce que l’élagage dans les arbres de décision ?L’élagage réduit la taille des arbres de décision en supprimant les sections de l’arbre qui n’apportent que peu de puissance pour classifier les instances.
Q10 : Comment visualiser les arbres de décision en Python ?Grâce à des bibliothèques comme matplotlib et Graphviz, les arbres de décision peuvent être représentés visuellement pour une interprétation plus simple.