

Corrélation vs causalité : comprendre la différence
Corrélation vs causalité est cruciale en analyse de données : la corrélation indique une association entre des variables, tandis que la causalité démontre une relation de cause à effet.
Introduction
En l'analyse des données et en recherche scientifique, la distinction entre corrélation vs causalité est fondamentale pour une interprétation et une compréhension précises. Cette distinction cruciale constitue le socle de méthodologies de recherche rigoureuses et garantit la validité des conclusions tirées des données empiriques.
La corrélation, la mesure statistique qui décrit le degré de déplacement de deux variables l'une par rapport à l'autre, sert souvent d'indicateur préliminaire d'une relation potentielle. Cependant, le concept de causalité, l’affirmation selon laquelle un changement dans une variable est responsable d’un changement dans une autre, résume l’essence de la dynamique de cause à effet. L’amalgame de ces deux concepts peut conduire à des conclusions erronées, à des politiques, des recherches et une compréhension générale erronées.
Cet article vise à élucider la distinction nuancée entre corrélation et causalité, à mettre en évidence les idées fausses courantes et à donner un aperçu des méthodologies permettant de déterminer plus précisément les relations causales. Grâce à cette exploration, nous cherchons à doter les lecteurs des outils analytiques nécessaires pour naviguer dans le paysage complexe des informations basées sur les données, favorisant ainsi une appréciation plus profonde des subtilités de l'investigation scientifique et de la recherche de la vérité dans le monde empirique.
Points forts
- La corrélation montre une association entre les variables mais n'implique pas de causalité.
- La causalité fait référence à une relation de cause à effet entre des variables.
- Des facteurs de confusion peuvent conduire à de fausses corrélations et à des conclusions trompeuses.
- La causalité inverse peut donner lieu à des hypothèses erronées sur le sens de la causalité.
- Une généralisation excessive à partir d’un ensemble de données limité peut conduire à de fausses conclusions.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Corrélation vs causalité
Comprendre la différence entre corrélation vs causalité est essentiel pour tirer des conclusions précises en matière d'analyse de données et de statistiques.
La corrélationdésigne la relation entre deux variables, où les variations de l'une sont associées aux variations de l'autre. Lorsque deux variables sont corrélées, elles tendent à évoluer dans une direction particulière, positivement ou négativement. Une corrélationpositive indique que les deux variables augmentent ou diminuent simultanément. À l'inverse, une corrélationnégatifsignifie que lorsqu'une variable diminue, l'autre augmente, et inversement. Il est essentiel de préciser quecorrélation n'implique pas de causalité, mais désigne simplement une association entre les variables.
La causalité, en revanche, désigne une relationde cause à effetentre deux variables. Dans une relation causale, les variations d'une variable entraînent directement des variations de l'autre. Établir la causalité ne se limite pas à identifier une corrélation ; cela exige de démontrer clairement qu'une variable influence l'autre, en excluant la possibilité que des facteurs externes ou de simples coïncidences soient à l'origine de l'association observée.
En résumé, corrélation et causalité sont des concepts liés mais non synonymes. La corrélation décrit l'association entre deux variables, tandis que la causalité démontre une relation de cause à effet.
Corrélation vs causalité Idées fausses courantes
Corrélation n'implique pas causalité :une idée fausse très répandue est de croire que si deux variables sont corrélées, l'une est forcément la cause de l'autre. Si la corrélation peut suggérer une relation causale potentielle, elle ne prouve pas pour autant la causalité. La corrélation met en évidence une relation entre deux variables, qui peut résulter d'une coïncidence, de facteurs de confusion ou d'une causalité inverse.
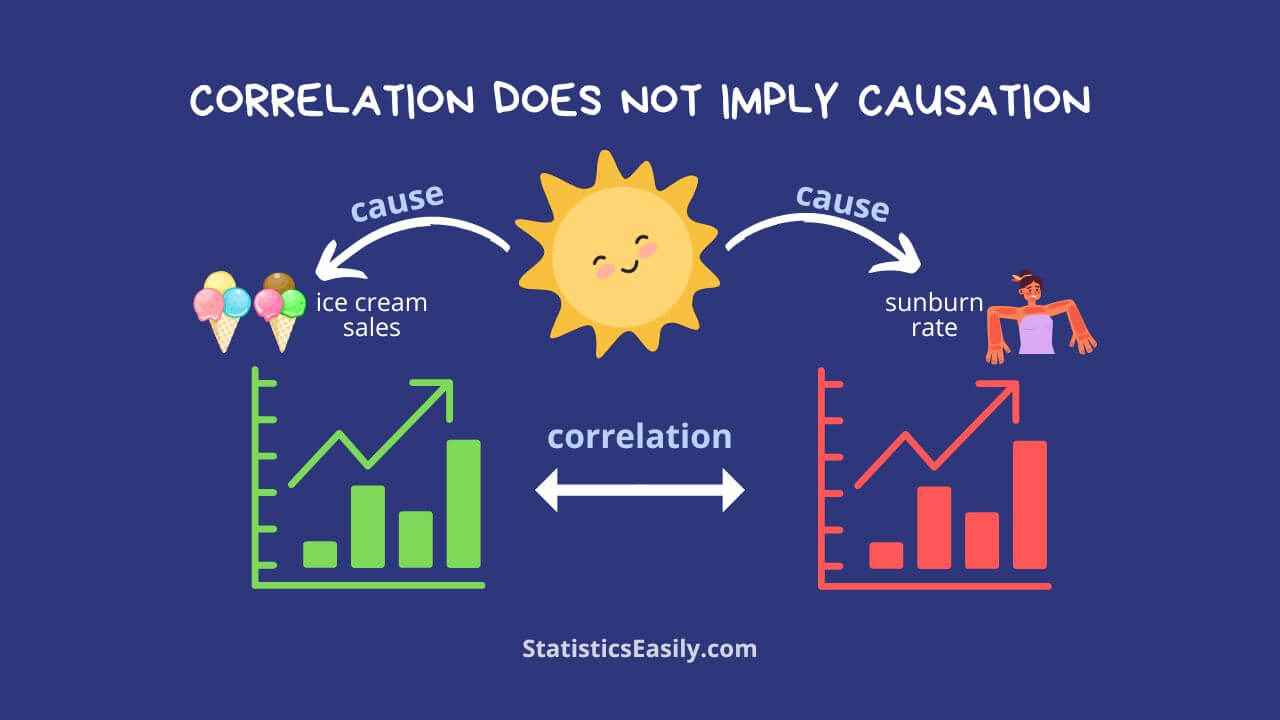
Ignorer les facteurs de confusion :Un facteur de confusion est une variable tierce qui influence à la fois les variables indépendantes et dépendantes, induisant une corrélation fallacieuse. Négliger les facteurs de confusion peut conduire à des conclusions erronées quant à la relation causale entre les variables étudiées. Par conséquent, il est essentiel de contrôler les facteurs de confusion potentiels dans l’analyse afin d’établir la causalité.
Causalité inverse :Un autre écueil lié à la corrélation et à la causalité est la causalité inverse, où la relation causale entre deux variables est opposée à celle supposée. Cela peut se produire lorsque la variable dépendante présumée influence la variable indépendante présumée, et non l’inverse. Être conscient de cette possibilité permet aux analystes d’éviter de tirer des conclusions erronées quant au sens de la causalité.
Généralisation abusive :Il arrive que les analystes généralisent à tort la relation entre deux variables à partir d’un ensemble de données limité ou d’un contexte spécifique. Le fait qu’une corrélation ou une relation causale soit observée dans une situation donnée ne signifie pas qu’elle se vérifiera dans tous les contextes. Il est donc essentiel de faire preuve de prudence lorsqu’on généralise les résultats et de tenir compte des limites et des conditions particulières de l’étude.
Faute de considération pour la signification statistique : Bien que la signification statistique soit un élément essentiel de l’analyse des données, elle ne doit pas constituer le seul critère pour déterminer l’existence d’une relation entre des variables. Une corrélation statistiquement significative n’implique pas nécessairement une relation de cause à effet. Il est donc crucial de prendre en compte d’autres facteurs, tels que la taille de l’effet, la taille de l’échantillon et la plausibilité de la relation, à la lumière des connaissances et des théories existantes.
Exemples de corrélation et de causalité
Ventes de glaces et noyades :Il existe une corrélation positive entre les ventes de glaces et le nombre de noyades. Cependant, cela ne signifie pas que les ventes de glaces causent les noyades. Le facteur sous-jacent est la chaleur, qui entraîne une augmentation de la consommation de glaces et, par conséquent, une hausse du nombre de personnes se baignant, ce qui accroît le risque de noyade. Dans ce cas, la chaleur agit comme un variable confondante.
Nombre de pompiers et dégâts causés par les incendies :Dans certains cas, les données peuvent révéler une corrélation positive entre le nombre de pompiers présents sur les lieux d’un incendie et les dégâts qu’il a causés. Cette corrélation ne signifie pas que les pompiers causent plus de dégâts ; les incendies de grande ampleur nécessitent davantage de pompiers et ont tendance à causer plus de dégâts. Ici, la taille de l’incendie constitue la variable confondante.
Niveau d'études et revenus :les données révèlent souvent une corrélation positive entre le niveau d'études et les revenus. Si cette corrélation peut laisser penser qu'un niveau d'études supérieur engendre des revenus plus élevés, il est essentiel de prendre en compte d'autres facteurs susceptibles d'influencer cette relation, tels que les aptitudes individuelles, l'expérience professionnelle et le réseau social. La corrélation entre études et revenus n'implique pas nécessairement une relation de cause à effet.
Population pirate et température mondiale : un exemple souvent cité avec humour pour illustrer la différence entre corrélation et causalité est celui de la diminution du nombre de pirates au cours des derniers siècles et de l’augmentation de la température mondiale. Bien que les données puissent montrer une corrélation inverse entre la population pirate et la température mondiale, il est absurde de suggérer que le déclin de la piraterie provoque le réchauffement climatique.
Stratégies pour identifier la causalité dans l'analyse des données
L'établissement de la causalité est essentiel à l'analyse des données, car il permet aux chercheurs de déduire des relations de cause à effet entre les variables. Identifier la causalité peut s’avérer difficile, mais plusieurs stratégies peuvent aider les analystes à déterminer s’il existe une relation causale. Cette section présente quelques stratégies clés pour identifier la causalité dans l’analyse des données.
- Expériences contrôlées :Ces expériences impliquent de manipuler une variable indépendante et de mesurer son impact sur une variable dépendante pour établir la causalité. L'assignation aléatoire et le contrôle des facteurs de confusion aident à isoler l'effet causal.
- Expériences naturelles :Lorsque les expériences contrôlées ne sont pas possibles ou éthiques, les expériences naturelles peuvent estimer les effets causals en comparant des groupes exposés à des conditions naturelles qui ressemblent à une expérience contrôlée.
- Études longitudinales:Ces études collectent des données sur des sujets au fil du temps, examinant les relations entre les changements de variables. La préséance temporelle est cruciale pour établir la causalité.
- Causalité Granger :Une approche d'analyse de séries chronologiques déterminant si une série temporelle peut en prédire une autre, fournissant des preuves de causalité par le biais de relations décalées entre les variables, mais ne garantissant pas la cause à effet.
- Variables instrumentales :Cette technique estime les relations causales en présence de facteurs de confusion en identifiant un instrument lié à la variable indépendante mais non affecté par les facteurs de confusion.
- Plan de discontinuité de régression :Une méthode quasi-expérimentale estimant les effets causals en comparant les observations proches d'un seuil, évaluant l'impact du traitement tout en tenant compte des facteurs de confusion.
- Méta-analyse :Combine les résultats de plusieurs études pour estimer l’ampleur globale de l’effet, en examinant la cohérence et la force des relations causales entre les études et en identifiant les modérateurs potentiels.
- Correspondance du score de propension :Contrôle les biais de sélection dans les études observationnelles en faisant correspondre les groupes de traitement et les groupes témoins sur la base de covariables prédisant la probabilité d'attribution du traitement et en estimant les effets causals tout en contrôlant les facteurs de confusion.
- Différence de différences :Une méthode quasi-expérimentale comparant les changements de résultats variables entre les groupes de traitement et les groupes témoins au fil du temps, estimant les effets causals tout en contrôlant les facteurs de confusion.
- Analyse de médiation :Examine comment une variable indépendante affecte une variable dépendante via des variables médiatrices, établissant ainsi une voie causale.
- Analyse de modération :Étudie les conditions dans lesquelles les relations entre les variables changent, en identifiant quand les relations causales sont plus fortes ou plus faibles.
- Analyse contrefactuelle :Estimation des effets causals en déterminant ce qui se serait passé si un traitement n'avait pas été appliqué ou si un traitement différent avait été appliqué, en contrôlant les facteurs de confusion.
- Modèles à effets fixes :Contrôle les facteurs invariants dans le temps non observés dans l'analyse des données de panel, en estimant l'effet causal de la variable indépendante sur la variable dépendante.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusion
La distinction entre corrélation et causalité est fondamentale pour une analyse de données solide et une pensée critique. Cet article a montré que les corrélations indiquent des associations entre variables mais n'impliquent pas nécessairement une relation causale. Comprendre cette distinction évite les pièges courants liés à une mauvaise interprétation des données, tels que la négligence des facteurs de confusion, la causalité inverse et les dangers d'une généralisation excessive et d'une dépendance excessive à l'égard de la signification statistique.
Les exemples, allant des ventes de glaces et des noyades à la corrélation humoristique entre les pirates et le réchauffement climatique, illustrent la complexité et les nuances impliquées dans la distinction de relations causales authentiques à partir de simples corrélations. De plus, les stratégies décrites pour identifier la causalité, y compris les expériences contrôlées, les expériences naturelles et les études longitudinales, offrent aux chercheurs des méthodologies précieuses pour établir des relations de cause à effet plus définitives.
Alors que nous naviguons dans une époque inondée de données, la capacité de faire la différence entre corrélation et causalité devient une compétence de recherche scientifique et une culture fondamentale pour une prise de décision éclairée et une analyse critique dans divers domaines de la connaissance et de la vie quotidienne.
lecture recommandée
- Variables confondantes dans les statistiques : stratégies d'identification et d'ajustement
- Crème glacée et polio : comprendre la corrélation et la causalité
- Corrélation en statistiques (Récit)
- Stratégies pour identifier la causalité (Récit)
- Corrélation vs causalité : la fracture critique (Récit)
- Comment distinguer la corrélation de la causalité (Lien externe)
FAQ : corrélation vs causalité
La corrélation décrit l'association entre les variables, tandis que la causalité démontre une relation de cause à effet.
Non, la corrélation n'implique pas la causalité. La corrélation montre une relation entre les variables, mais cela ne peut pas être dû à une relation de cause à effet.
Un facteur de confusion est une troisième variable qui affecte les variables indépendantes et dépendantes, conduisant à une fausse corrélation.
La causalité inverse fait référence à une condition dans laquelle la relation causale supposée entre deux variables est inversée, ce qui signifie que l'effet influence la cause au lieu que la cause influence l'effet. Cela peut conduire à des conclusions erronées sur le sens de la causalité.
Une généralisation excessive peut conduire à de fausses conclusions si la relation entre les variables est supposée être vraie dans tous les contextes sans tenir compte des limitations potentielles ou des conditions aux limites.
Les stratégies comprennent des expériences contrôlées, des expériences naturelles, des études longitudinales, la causalité de Granger, des variables instrumentales et un plan de discontinuité de régression.
Les expériences contrôlées manipulent une variable indépendante et mesurent son effet sur une variable dépendante, isolant l'effet causal en contrôlant les facteurs de confusion potentiels.
Une expérience naturelle est une étude qui s'appuie sur des événements ou des situations naturels qui imitent les conditions d'une expérience contrôlée, permettant aux chercheurs d'estimer les effets causals.
Les études longitudinales collectent des données sur les mêmes sujets au fil du temps, examinant comment les changements dans une variable sont associés aux changements dans une autre, aidant ainsi à établir une préséance temporelle dans la causalité.
Une variable instrumentale est une variable liée à la variable indépendante mais non affectée par les facteurs de confusion utilisés pour isoler l'effet causal de la variable indépendante sur la variable dépendante.

Appréciables, monsieur.
Excellent article, enfoque très bien détaillé, compréhensible et pratique pour l'application. Très complaisant.
Merci beaucoup, Nicolás. J'apprécie vraiment vos aimables paroles. Je suis ravi d'apprendre que l'article était détaillé, pratique et facile à comprendre. C'est exactement notre objectif : rendre les statistiques accessibles et applicables. Bonne chance dans vos études et votre travail !