Le rôle du Cherry Picking dans l’analyse statistique
Le « triage à la carte » fait référence à la pratique biaisée consistant à choisir sélectivement des données ou des ensembles de données qui soutiennent une conclusion ou un point de vue particulier tout en ignorant les informations contradictoires. Cela peut conduire à des résultats trompeurs dans l’analyse des données.
Qu’est-ce que la cueillette des cerises ?
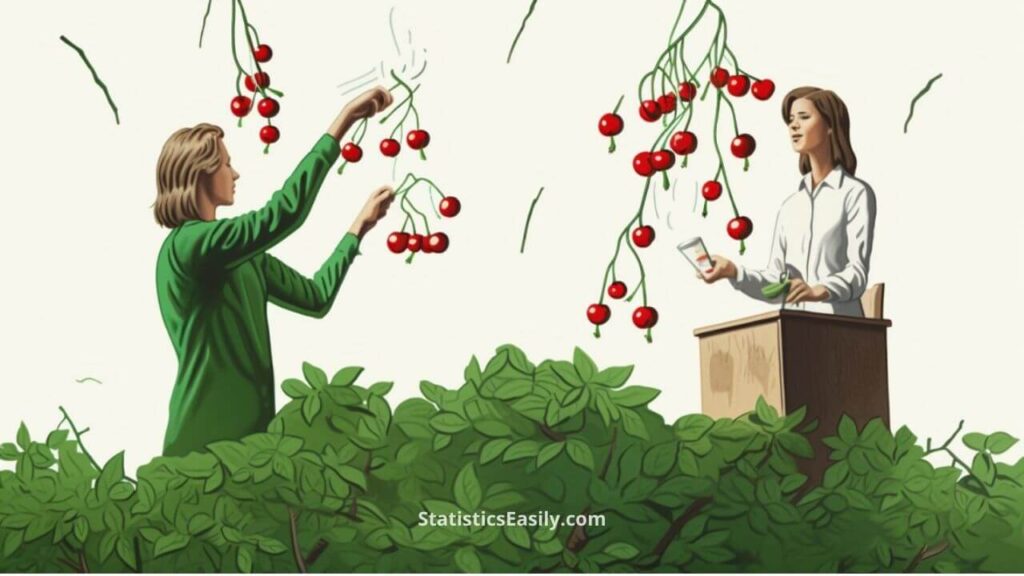
Le terme « Cherry Picking », qui tire son sens de l'action littérale de cueillir les meilleures cerises d'un arbre, désigne le choix sélectif de données ou d'ensembles de données qui soutiennent une conclusion ou un point de vue particulier, tout en ignorant ceux qui pourraient le contredire.
En analyse statistique, le biais de sélection des données est fréquent lorsque des individus, consciemment ou non, privilégient les données confirmant leurs idées préconçues ou hypothèses. Cette sélection biaisée conduit souvent à des erreurs statistiques, compromettant l'objectivité de l'analyse. Il ne s'agit pas toujours d'une manipulation délibérée ; parfois, c'est une conséquence du biais de confirmation, les analystes étant attirés par les données qui correspondent à leurs attentes.
Points forts
- Le triage fait référence au choix sélectif des données étayant une conclusion tout en ignorant les données contradictoires.
- La sélection sélective des statistiques peut conduire à des erreurs statistiques et compromettre l’objectivité de l’analyse.
- Une fausse représentation des données due à une sélection sélective peut conduire à des conclusions erronées et à des actions peu judicieuses.
- Le tri sélectif peut éroder la confiance dans les études statistiques, affectant ainsi leur crédibilité.
- La transparence dans le processus de collecte et d’analyse des données contribue à atténuer l’impact de la sélection sélective.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conséquences potentielles de la cueillette des cerises
Les conséquences d'picoragedonnées en statistiques peuvent être désastreuses, notamment dans les domaines où une interprétation précise des données est essentielle, comme la recherche scientifique ou l'élaboration des politiques publiques. Une présentation erronée des données, même involontaire, peut mener à des conclusions erronées et à des actions inappropriées.
Une conclusion erronée tirée de données triées sur le volet peut induire en erreur les recherches futures et conduire les scientifiques sur une mauvaise voie. Dans l’élaboration des politiques, des statistiques triées sur le volet peuvent alimenter de mauvaises décisions, affectant les sociétés et les économies. En outre, des cas de sélection répétés peuvent éroder la confiance dans les études statistiques et mettre en doute leur crédibilité.
Exemples du monde réel
Le biais de sélection des résultatsne se limite pas aux discussions théoriques ; il se manifeste dans des études statistiques concrètes, parfois avec des conséquences importantes. Par exemple, en recherche médicale, le fait de sélectionner les résultats favorables d'une série d'essais cliniques tout en ignorant les résultats moins prometteurs peut donner une impression trompeusement positive de l'efficacité d'un médicament.
Un exemple notoire de sélection sélective se trouve dans les rapports historiques publiés par l’industrie du tabac. Malgré de nombreuses études liant le tabagisme au cancer du poumon, l’industrie a mis l’accent de manière sélective sur les recherches suggérant d’autres causes, niant les effets nocifs du tabagisme. Cette présentation de données triées sur le volet a finalement été révélée, entraînant des changements importants dans la politique de santé publique et dans la perception des produits du tabac.
Un autre exemple peut être observé dans le domaine financier, où la sélection de résultats d'investissement rentables peut présenter une perspective faussée du succès d'une stratégie d'investissement. De telles fausses déclarations peuvent conduire à une prise de décision mal informée, entraînant des conséquences financières préjudiciables.
Techniques pour atténuer la cueillette des cerises
S'il est difficile d'éliminer complètementpicorage, certaines pratiques peuvent contribuer à en atténuer les effets. Premièrement, il est essentiel d'adopter une approche transparente dans le processus de collecte et d'analyse des données. Cela implique de définir clairement les critères de sélection des données et de maintenir un dialogue ouvert sur les limites de l'étude.
Deuxièmement, effectuer une analyse de sensibilité peut être bénéfique. Cela implique de tester la robustesse des résultats par rapport aux changements dans les ensembles de données ou dans les techniques analytiques utilisées. Enfin, les examens par les pairs et les études de réplication protègent efficacement contre le triage. Ils assurent un contrôle externe garantissant la validité et l’intégrité de l’analyse statistique.
Surmonter la cueillette des cerises
Lutter contrepicorageest essentiel pour préserver l'intégrité et la crédibilité des analyses statistiques. Il s'agit de corriger les erreurs d'analyse et de promouvoir une culture d'honnêteté, de transparence et d'intégrité dans la recherche fondée sur les données.
La lutte contre la sélection biaisée des données commence par la sensibilisation et l'éducation. La compréhension de ce concept, de ses implications et des techniques permettant de l'atténuer devrait faire partie intégrante de l'enseignement des statistiques. De plus, les politiques institutionnelles favorisant la transparence dans l'analyse des données et sanctionnant le mésusage des statistiques sont essentielles pour décourager cette pratique.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Remarques finales
Le triage est un problème omniprésent dans l’analyse statistique, capable de fausser les résultats et de induire en erreur. Bien qu'il soit difficile de l'éradiquer, un effort concerté impliquant l'éducation, des pratiques transparentes et des processus d'examen rigoureux peut atténuer considérablement son impact. Le chemin vers des statistiques impartiales pourrait être ardu. Il s’agit néanmoins d’une étape nécessaire à l’avancement des connaissances et à la prise de décision basées sur les données.
Articles recommandés
Vous souhaitez en savoir plus sur les biais statistiques ? Parcourez notre blog pour plus d'articles sur les statistiques et l'analyse des données qui vous intéressent.
- Démêler les biais d’échantillonnage
- Échantillonnage aléatoire sur Excel
- Biais de sélection dans l'analyse des données
- Comprendre l'échantillonnage de commodité
- Échantillonnage aléatoire : techniques essentielles
- Leçons rapides sur les données : sélection sélective (Lien externe)
- P-hacking : une menace cachée pour une analyse fiable des données
- Biais de survie : un piège caché dans la science des données et les statistiques
- Comment les erreurs statistiques ont influencé la perception de l'effet Mozart
Foire Aux Questions (FAQ)
Il fait référence à la sélection biaisée de données qui soutiennent des idées préconçues, conduisant à des conclusions potentiellement trompeuses.
On peut en trouver des exemples dans la recherche en santé, où des résultats sélectifs peuvent surestimer l'efficacité d'un médicament, ou dans le domaine financier, avec des résultats d'investissement trompeurs.
Les effets incluent des données déformées, des conclusions erronées, des actions malavisées et une confiance érodée dans les études statistiques.
La transparence dans la collecte de données, l’analyse de sensibilité, les examens par les pairs et les études de réplication peuvent contribuer à réduire la sélection sélective.
Cela peut conduire à des impressions faussement positives sur l'efficacité d'un médicament, induisant ainsi en erreur les recherches futures et les politiques de santé.
Une sélection de résultats rentables peut donner une fausse idée du succès d'une stratégie d'investissement, conduisant à une prise de décision mal informée.
La transparence dans le processus de collecte et d’analyse des données garantit des critères de sélection clairement définis, contribuant ainsi à éviter la sélection sélective.
Les examens par les pairs fournissent un contrôle externe de la validité et de l’intégrité de l’analyse statistique, protégeant ainsi contre la sélection sélective.
C'est crucial pour maintenir l'intégrité et la crédibilité de l'analyse statistique et favoriser une culture d'honnêteté dans la recherche basée sur les données.
Les politiques qui favorisent la transparence de l’analyse des données et pénalisent l’utilisation abusive des statistiques sont essentielles pour empêcher la sélection sélective.