Analyse de régression linéaire : tracer des lignes dans R
Vous apprendrez les étapes essentielles pour interpréter visuellement les données avec le tracé de régression linéaire de R.
Introduction
L'analyse de régression linéaire est un outil statistique fondamental qui modélise et analyse les relations entre une variable dépendante et une ou plusieurs variables indépendantes. Cela nous permet de prédire les résultats et de comprendre les modèles sous-jacents de nos données. En ajustant une équation linéaire aux données observées, la régression linéaire estime les coefficients de l'équation, qui sont utilisés pour prédire la variable dépendante à partir des variables indépendantes.
L'importance de la représentation visuelle en analyse statistique est capitale. Les graphiques et les diagrammes permettent de visualiser immédiatement les tendances, les valeurs aberrantes et les relations potentielles entre les variables. Dans R, la création de graphiques fait partie intégrante du processus l'analyse des données , contribuant à la compréhension de relations complexes de manière accessible et instructive.
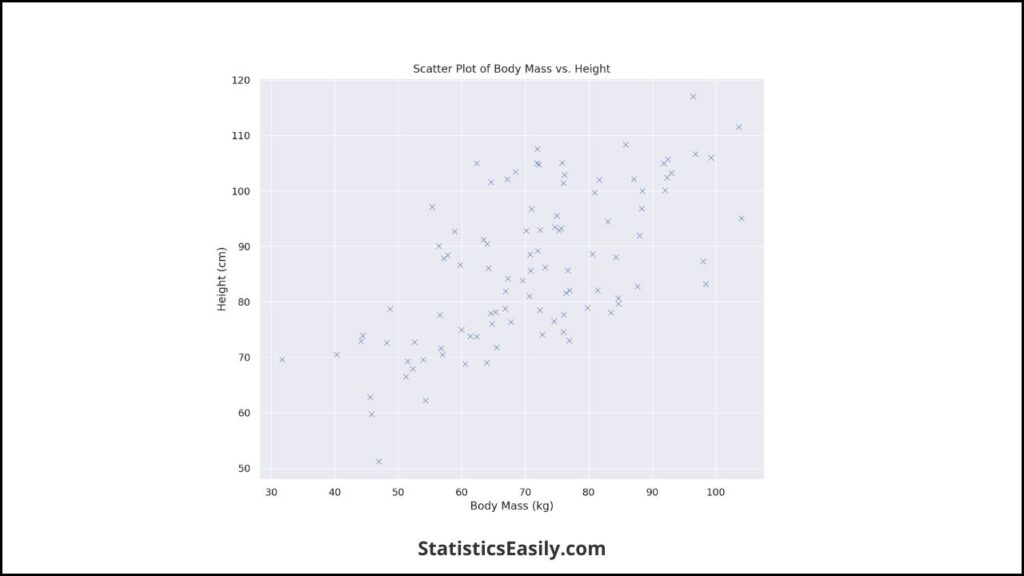
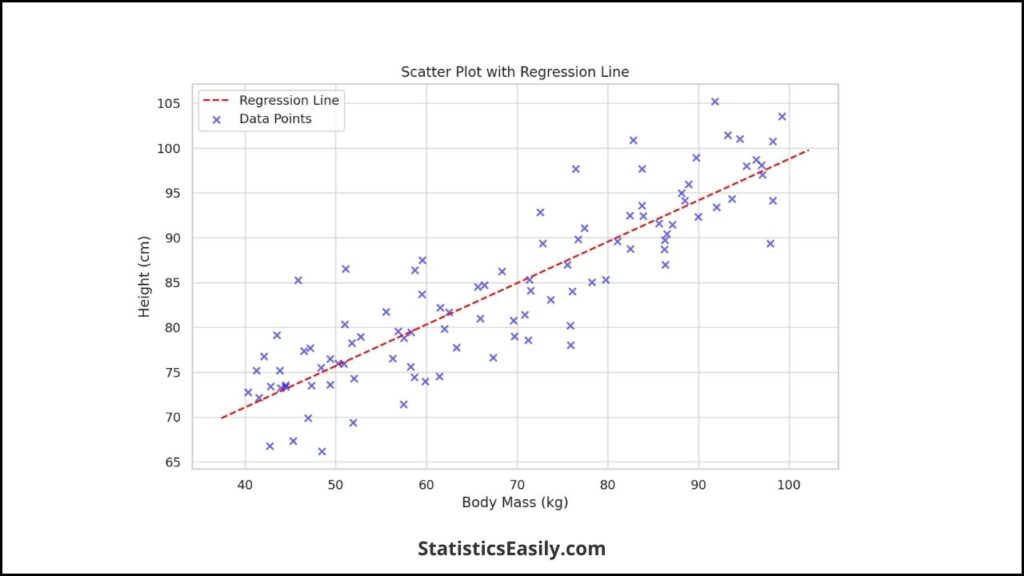
Le nuage de points ci-dessus, créé à partir d’un ensemble de données simulant la relation entre la masse corporelle et la taille, constitue un point de départ idéal pour une analyse de régression linéaire. Il fournit une base visuelle pour appliquer un modèle linéaire et extraire des informations, illustrant à quel point les outils visuels sont essentiels pour une analyse statistique pratique. La visualisation de nos données nous permet de mieux communiquer les résultats, de partager des informations et de prendre des décisions éclairées.
Points forts
- Découvrez comment la fonction 'lm()' de R calcule des modèles linéaires précis.
- Visualisez les relations entre les données avec des tracés personnalisés dans R.
- Maîtrisez l'interprétation des résultats de régression de R pour l'analyse appliquée.
- Apprenez à améliorer les tracés avec les packages graphiques avancés de R.
- Obtenez un aperçu de la fonction « abline() » de R pour la représentation des lignes de régression.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Fondement conceptuel
La régression linéaire consiste à trouver la relation linéaire entre la variable dépendante et une ou plusieurs variables indépendantes. Le concept principal de la régression linéaire consiste à déterminer la ligne droite la mieux ajustée passant par les points de données. L'équation de régression représente cette droite :
y = β0 + β1x1 + β2x2 + … + βnxn + ϵ
où y est la variable dépendante, β0 est l'ordonnée à l'origine, β1, …, βn sont les coefficients, x1, …, xn sont les variables indépendantes et ϵ représente le terme d'erreur.
The importance de la relation entre les variables dépendantes et indépendantesen régression linéaire est capitale. La variable dépendante, également appelée variable réponse ou variable prédite, est celle que l'on cherche à prédire ou à expliquer. Les variables indépendantes, aussi appelées variables explicatives ou prédicteurs, sont les données d'entrée utilisées pour la prédiction. L'intensité et la forme de cette relation sont déterminées par les coefficientsβ1, …, βn, qui indiquent comment une variation unitaire de la variable indépendante affecte la variable dépendante.
Comprendre cette relation est essentiel car elle constitue la base des informations que nous pouvons tirer du modèle. Par exemple, si nous analysons la relation entre la masse corporelle (variable indépendante) et la taille (variable dépendante), le coefficient nous indique dans quelle mesure nous nous attendons à ce que la taille change, en moyenne, avec chaque kilogramme supplémentaire de masse corporelle.
En analyse de données et en science, ces concepts ne sont pas de simples abstractions mathématiques. Ils représentent la profonde interconnectivité des variables dans les phénomènes naturels et la recherche centrée sur l’humain. En dévoilant ces liens grâce à l'analyse de régression linéaire, nous contribuons à un ensemble de connaissances qui reflète la nature ordonnée et systématique de l'univers, en phase avec notre quête de ce qui est authentique et significatif.
Configuration de l'environnement
Avant de se lancer dans l'analyse, la mise en place d'un environnement approprié dans R est cruciale pour un traçage efficace et efficient des données. Voici un guide étape par étape pour préparer votre environnement R pour l'analyse et le traçage de régression linéaire :
1. Installez R et RStudio :
- Téléchargez et installez R à partir du Comprehensive R Archive Network (CRAN).
- En option, téléchargez et installez RStudio, une interface puissante et conviviale pour R.
2. Ouvrez RStudio et définissez votre répertoire de travail :
- Utilisez le 'setwd("votre_chemin_répertoire")' pour définir votre environnement de travail dans lequel vos données et scripts seront stockés.
3. Mettez à jour R et installez les packages :
- Mettez à jour R vers la dernière version en utilisant 'update.packages(ask=FALSE)'.
- Installez les packages nécessaires en utilisant 'install.packages()'. Pour le tracé de régression linéaire, commencez par ‘ggplot2’, ‘dplyr’et 'rangement' pour la manipulation des données et ‘ggplot2’ pour des capacités de traçage avancées.
4. Chargez les packages :
- Chargez les packages installés dans la bibliothèque avec ‘bibliothèque (nom_paquet)'.
5. Vérifiez régulièrement les mises à jour :
- Vérifiez et mettez à jour régulièrement vos packages pour garantir la compatibilité et l'accès aux dernières fonctionnalités.
# Setting up the Working Directory
# Replace 'your_directory_path' with the path where you want to store your data and scripts
setwd("your_directory_path")

# Updating R packages
update.packages(ask = FALSE)

# Installing necessary packages for linear regression plotting
# ggplot2 for plotting, dplyr and tidyr for data manipulation
install.packages("ggplot2")
install.packages("dplyr")
install.packages("tidyr")

# Loading the packages into R
library(ggplot2)
library(dplyr)
library(tidyr)

# Check for updates regularly - This is just a reminder, as you'll run this when needed
# update.packages(ask = FALSE)
Préparation des données
La préparation des données est une étape critique de l'analyse de régression linéaire, où les données sont collectées, nettoyées et transformées dans un format approprié pour l'analyse. Ce processus comporte souvent plusieurs étapes pour garantir l'intégrité des données et leur pertinence par rapport à la question de recherche.
1. Collecte de données:
- Recueillir des données auprès de sources fiables pour garantir leur exactitude et leur validité.
- Assurez-vous que les données collectées sont pertinentes par rapport aux variables d’intérêt dans le modèle de régression linéaire.
2. Nettoyage des données :
- Identifiez et traitez les valeurs manquantes de manière appropriée, que ce soit par imputation ou suppression.
- Détectez et corrigez les erreurs ou les valeurs aberrantes susceptibles de fausser l’analyse.
3. Transformation des données :
- Convertissez les données dans le format approprié pour l'analyse, par exemple en modifiant les types de données ou en normalisant les échelles.
- Créez des variables factices pour les données catégorielles à utiliser dans le modèle de régression.
4. Exploration des données:
- Effectuer une analyse exploratoire des données (EDA) pour comprendre la distribution des données et identifier des modèles ou des anomalies.
- Utilisez des visualisations pour repérer les tendances, les clusters et les valeurs aberrantes susceptibles d'affecter le modèle de régression.
5. Fractionnement des données :
- Le cas échéant, divisez les données en ensembles de formation et de test pour valider les performances prédictives du modèle.
Pour notre ensemble de données, nous considérons la relation entre la masse corporelle (variable indépendante) et la taille (variable dépendante). L'ensemble de données comprend des mesures de masse corporelle en kilogrammes et de taille en centimètres pour un échantillon de population. Cet ensemble de données est idéal pour démontrer la régression linéaire, car il présente probablement une relation linéaire, car la masse corporelle et la taille sont généralement corrélées dans les études biologiques.
Tracer avec R
Le tracé dans R combine l'art et la science, offrant des outils pour représenter visuellement les données à des fins d'analyse et de communication. En utilisant le système de traçage de base de R, ggplot2, ou d'autres packages de visualisation, vous pouvez créer des tracés informatifs et esthétiques. Explorons les techniques de traçage de base dans R et comment personnaliser efficacement ces tracés.
1. Traçage de base R :
R de base propose des fonctions de tracé simples mais très performantes. La fonction « plot() » est l'une des plus couramment utilisées :
# Basic scatter plot with R's base plotting system
plot(x = dataset$body_mass, y = dataset$height,
     main = "Scatter Plot of Body Mass vs. Height",
     xlab = "Body Mass (kg)", ylab = "Height (cm)",
     pch = 19, col = "blue")
Ici, « x‘ et ‘y‘ sont les variables à représenter, ‘main‘ est le titre du graphique, ‘xlab‘ et ‘ylab‘ sont les étiquettes des axes x et y, ‘pch‘ définit le type de point à utiliser et ‘col‘ détermine la couleur des points.
2. Personnalisation des tracés
La personnalisation implique de modifier les paramètres par défaut pour que l'intrigue transmette les informations plus efficacement et la rende plus attrayante visuellement.
# Customizing the plot with additional arguments
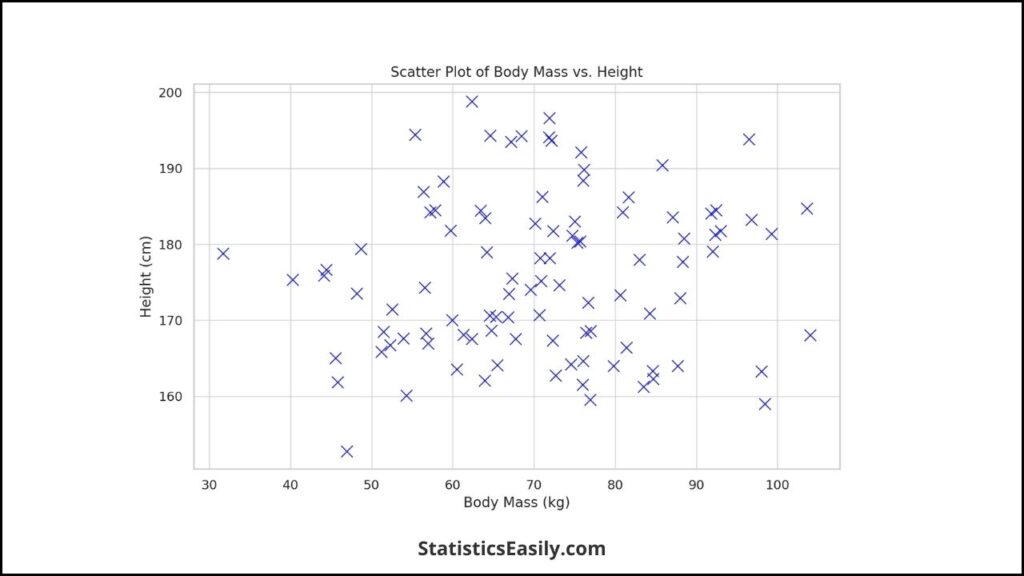
plot(x = dataset$body_mass, y = dataset$height,
     main = "Scatter Plot of Body Mass vs. Height",
     xlab = "Body Mass (kg)", ylab = "Height (cm)",
     pch = 19, col = "blue", cex = 1.5,
     xlim = c(40, 100), ylim = c(140, 200))
Ici, 'cex‘ contrôle la taille des points, tandis que 'xlim‘ et 'ylim‘ définissent respectivement les limites des axes x et y.
3. Traçage avancé avec ‘ggplot2‘
‘ggplot2’ est un système puissant de création de graphiques qui offre un meilleur contrôle sur l'esthétique du graphique.
# Advanced plotting with ggplot2
library(ggplot2)

ggplot(data = dataset, aes(x = body_mass, y = height)) +
  geom_point(color = "blue") +
  ggtitle("Scatter Plot of Body Mass vs. Height") +
  xlab("Body Mass (kg)") +
  ylab("Height (cm)") +
  theme_minimal()
Dans cet 'ggplot‘ syntaxe, ‘aes‘ définit les correspondances esthétiques, ‘geom_point‘ ajoute la couche de nuage de points, ‘ggtitle‘, ‘xlab‘et ‘ylab‘ fournissent les titres et les étiquettes, et ‘theme_minimal()‘ applique un thème minimaliste au graphique.
Calcul de régression linéaire
Le calcul d'un modèle de régression linéaire dans R s'effectue principalement à l'aide de la fonction `lm()` fonction, qui signifie 'modèle linéaire'. Le `lm()‘ qui signifie « modèle linéaire ». Cette
Voici comment la fonction ‘lm()‘ est généralement utilisée :
# Fit a linear model to the data
linear_model <- lm(height ~ body_mass, data = dataset)

# Summarize the model to view the coefficients
summary(linear_model)
In the `lm()‘ fonction, ‘height ~ body_mass`‘ le modèle avec ‘la taille‘ comme variable dépendante et ‘masse corporelle‘ indépendante. L' argument ‘data = dataset`‘ l'argument indique à R quel cadre de données utiliser pour les variables.
The ‘summary()’ fournit ensuite un rapport détaillé, incluant les coefficients estimés (ordonnée à l'origine et pente), essentiels à la compréhension de l'équation de régression. Ce rapport comprend également des mesures statistiques telles que le coefficient de détermination (R²), qui indique la proportion de variance de la variable dépendante pouvant être prédite à partir de la variable indépendante.
L’interprétation des coefficients est simple :
- Interception (β0): C'est la moyenne attendue 'hauteur‘ valeur quand 'masse corporelle‘ est zéro. C'est là que la ligne de régression croise l'axe Y.
- Pente (β1): Cela représente la variation estimée de ‘la taille‘ pour un changement d'une unité ‘masse corporelle‘. Si ‘β1‘ est positif, cela signifie que comme ‘masse corporelle‘ augmente, ‘la taille‘ tend à augmenter.
Comprendre l'équation de régression est essentiel car cela nous permet de faire des prédictions et de comprendre la relation entre les variables. Par exemple, si β0‘ 100 et β1‘ 0.5, l'équation de régression serait : « taille = 100 + 0.5 × masse_corporelle ». Pour chaque kilogramme supplémentaire de masse corporelle, la taille devrait augmenter d'un demi-centimètre.
Visualiser la ligne de régression
La visualisation de la droite de régression est une étape cruciale pour comprendre la relation que représente votre modèle linéaire. La ligne de régression représente visuellement l'équation linéaire adaptée à vos données. Voici comment ajouter une droite de régression à vos tracés dans R :
1. Utilisation de la fonction abline() :
The ‘abline()’ est un outil pratique du système de tracé de base de R qui permet d'ajouter des lignes droites à un graphique. Après avoir ajusté un modèle linéaire à l'aide de la fonction `lm()` , ajoutez une droite de régression en utilisant l'ordonnée à l'origine et la pente du modèle.
# Assuming linear_model is your lm object from fitting the data
linear_model <- lm(height ~ body_mass, data = dataset)

# Basic scatter plot
plot(dataset$body_mass, dataset$height,
     main = "Scatter Plot with Regression Line",
     xlab = "Body Mass (kg)", ylab = "Height (cm)",
     pch = 19, col = "blue")

# Add the regression line
abline(linear_model, col = "red")
Dans ce code, 'abline(linear_model, col = "red")' extrait automatiquement l'ordonnée à l'origine et la pente de votre objet 'linear_model' et ajoute une ligne de régression rouge à votre graphique.
2. Utiliser lm() directement avec abline() :
Vous pouvez également ignorer la création d'un objet de modèle linéaire et saisir directement la formule et l'ensemble de données dans ‘abline()’.
# Directly adding a regression line without storing the lm object
abline(lm(height ~ body_mass, data = dataset), col = "red")
Cette ligne de code effectue le calcul de régression linéaire. Il ajoute la ligne de régression au tracé existant en une seule étape.
Techniques de visualisation avancées
L'amélioration de vos visualisations de données va au-delà des tracés de base. Cela implique d’exploiter la puissance de packages R supplémentaires et de capacités de traçage interactif. Ces techniques avancées peuvent améliorer considérablement l’engagement et l’interprétabilité de vos visualisations de données.
1. Utilisation de « ggplot2 » pour la personnalisation avancée :
‘ggplot2’est un package polyvalent qui permet de créer des graphiques complexes et personnalisables dans R. Grâce à son approche par couches, vous pouvez construire des graphiques élément par élément, en ajoutant des éléments esthétiques et des transformations statistiques.
library(ggplot2)

# Start with the basic plot
ggplot(dataset, aes(x = body_mass, y = height)) +
  geom_point() +  # Add points
  geom_smooth(method = "lm", se = FALSE, color = "red") +  # Add a linear regression line
  theme_bw() +  # Use a minimalistic theme
  labs(title = "Body Mass vs. Height with Regression Line",
       x = "Body Mass (kg)", y = "Height (cm)") +
  scale_color_manual(values = c("Points" = "blue", "Line" = "red"))
Dans cet exemple,`geom_smooth(method = “lm”)`ajoute directement une droite de régression linéaire au graphique, et`theme_bw()`applique un thème minimaliste.`labs()`ajoute des étiquettes au graphique et aux axes, améliorant ainsi la clarté et la lisibilité.
2. Création de tracés interactifs avec « plotly » :
Pour une expérience plus immersive, notamment dans les environnements web,« plotly »offre des fonctionnalités de traçage interactives permettant aux utilisateurs de survoler les points de données, de zoomer/dézoomer et de se déplacer sur les graphiques.
library(plotly)

# Convert ggplot2 to plotly
p <- ggplot(dataset, aes(x = body_mass, y = height)) +
  geom_point() +
  geom_smooth(method = "lm", se = FALSE, color = "red") +
  labs(title = "Interactive Plot of Body Mass vs. Height",
       x = "Body Mass (kg)", y = "Height (cm)")

# Convert to plotly object
ggplotly(p)
La conversion d'un objet‘ggplot2’en un objet« plotly »est simple et conserve les calques et les personnalisations ajoutés dans‘ggplot2’. Le graphique interactif ainsi obtenu permet aux utilisateurs d'explorer les données de manière plus dynamique, faisant de la visualisation un outil de présentation et d'exploration.
3. Amélioration des tracés avec « gganimate » pour les visualisations dynamiques :
'gganimate'étend‘ggplot2’en ajoutant des fonctionnalités d'animation, permettant d'illustrer les changements de données au fil du temps ou des conditions de manière dynamique et convaincante.
library(gganimate)

# Assuming 'time' is a variable in your dataset
p <- ggplot(dataset, aes(x = body_mass, y = height, group = time)) +
  geom_line() +
  transition_reveal(time)

# Render the animation
animate(p, renderer = gifski_renderer())
Cet extrait de code montre la création d'un tracé linéaire qui se révèle au fil du temps, montrant de manière captivante la progression, les tendances ou l'évolution des modèles.
Interprétation des résultats
L'interprétation des résultats de R, notamment d'une analyse de régression linéaire, nécessite la compréhension des résumés statistiques fournis par des fonctions comme‘summary()’lorsqu'elles sont appliquées à un objet`lm`. Ces résultats comprennent plusieurs éléments essentiels qui éclairent la relation entre les variables et la qualité globale de l'ajustement du modèle.
1. Coefficients :
- Interception (β0) :Représente la valeur attendue de la variable dépendante lorsque toutes les variables indépendantes sont nulles. C'est le point où la droite de régression coupe l'axe Y.
- Pente (β1, β2, …) :Chaque coefficient associé à une variable indépendante représente la variation attendue de la variable dépendante pour une variation d'une unité de cette variable indépendante, en maintenant toutes les autres variables constantes.
2. Niveaux de signification :
- Les étoiles ou valeurs p à côté des coefficients indiquent leurs niveaux de signification. Une valeur p inférieure (<0.05) suggère que la variable correspondante prédit de manière significative la variable dépendante.
3. R au carré (R²) :
- Cette valeur indique la proportion de variance de la variable dépendante qui est prévisible à partir des variables indépendantes. Il va de 0 à 1, les valeurs plus élevées indiquant une meilleure adéquation du modèle aux données.
4. Statistique F :
- Ce test évalue la signification globale du modèle de régression et détermine si au moins une variable prédictive a un coefficient non nul.
Implications dans le monde réel :
Comprendre ces résultats permet aux chercheurs et aux analystes de prendre des décisions éclairées et de faire des prédictions basées sur le modèle. Par exemple, dans une étude examinant la relation entre la masse corporelle et la taille :
- Un coefficient positif significatif pour la masse corporelle suggère que la taille devrait également augmenter à mesure que la masse corporelle augmente, reflétant une relation directe entre ces variables.
- Une valeur R au carré élevée indiquerait qu’une grande partie de la variabilité de la taille peut s’expliquer par des variations de la masse corporelle, ce qui suggère que la masse corporelle est un bon prédicteur de la taille.
- La signification globale du modèle, comme l'indique la statistique F, soutient l'utilisation de la masse corporelle pour prédire la taille de la population étudiée.
L'interprétation va au-delà des chiffres pour considérer l'applicabilité du modèle dans des contextes du monde réel. Par exemple, comprendre la relation entre la masse corporelle et la taille peut s’avérer crucial dans les domaines de la santé et de la nutrition, où ces informations éclairent les lignes directrices et les interventions. Cependant, il est essentiel de prendre en compte les limites du modèle et les hypothèses de régression linéaire, afin de garantir que les résultats sont appliqués de manière appropriée et réfléchie dans la pratique et l'élaboration des politiques.
En résumé, l’interprétation des résultats de l’analyse de régression linéaire de R implique :
- Un examen attentif des résultats statistiques.
- Comprendre la signification et les implications des coefficients.
- Niveaux de signification.
- Mesures d’ajustement du modèle.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusion
Alors que nous concluons notre exploration de l’analyse de régression linéaire et du traçage de lignes dans R, plusieurs points essentiels renforcent les meilleures pratiques d’analyse et de représentation des données. Ce voyage à travers le paysage statistique nous a doté de compétences techniques et a approfondi notre appréciation de l'art méticuleux de la science des données.
Premièrement, la puissance de la régression linéaire en tant qu’outil statistique est indéniable. Il ouvre une fenêtre sur les modèles sous-jacents de nos données, nous permettant de prédire les résultats et de discerner les relations entre les variables avec précision. Cette technique, fondée sur les principes de simplicité et de clarté, reflète notre quête de compréhension de phénomènes complexes d'une manière à la fois accessible et approfondie.
La création de graphiques avec R, que ce soit à l'aide des fonctions graphiques de base ou de packages avancés comme‘ggplot2’, transforme nos analyses, passant de simples chiffres à des récits captivants. Ces représentations visuelles servent d'outils d'analyse et font le lien entre les données et leurs applications concrètes. Elles nous permettent d'aller au-delà des apparences, révélant des tendances et des schémas qui pourraient rester insoupçonnés.
The `lm()`, pierre angulaire de la modélisation linéaire dans R, incarne l'élégance du calcul statistique. La simplification des relations complexes en équations simples réaffirme notre engagement envers une connaissance précise et pertinente. L'interprétation de ses résultats — coefficients, valeurs de R² et valeurs p — nous guide vers des prédictions et des décisions éclairées, fondées sur une compréhension approfondie des données.
Les techniques de visualisation avancées, notamment les tracés et animations interactifs, repoussent les limites de la présentation conventionnelle des données. Ils invitent à l'engagement et à la curiosité, transformant l'observation passive en une exploration active. Cette approche dynamique de la visualisation des données améliore non seulement la compréhension, mais s'aligne également sur notre engagement à favoriser une connexion plus profonde avec le public.
En interprétant les résultats de nos modèles linéaires, nous nous rappelons l’importance du contexte et de la pensée critique. La signification statistique et le pouvoir prédictif de nos modèles doivent être mis en balance avec leur pertinence dans le monde réel et leur applicabilité pratique. Cet équilibre entre rigueur statistique et impact réel e
Articles recommandés
Explorez plus en profondeur l'analyse des données : lisez notre sélection d'articles sur la régression linéaire et la programmation R pour plus d'informations d'experts !
- Comment calculer les résidus dans l’analyse de régression ?
- Hypothèses de régression linéaire : un guide complet
- Comment rapporter les résultats de la régression linéaire simple dans le style APA
- Qu’est-ce que l’analyse de régression ? Un guide complet pour les débutants
Foire Aux Questions (FAQ)
Q1 : Qu’est-ce que l’analyse de régression linéaire dans R ?C’est une méthode statistique permettant de modéliser la relation entre une réponse scalaire et une ou plusieurs variables explicatives.
Q2 : Comment tracer une droite de régression dans R ?Utilisez la fonction abline() après avoir calculé un modèle linéaire avec lm() pour ajouter une droite de régression à votre graphique.
Q3 : Que fait la fonction lm() dans R ?La fonction lm() ajuste des modèles linéaires en calculant les coefficients qui représentent l’équation de la droite de régression.
Q4 : R peut-il gérer l’analyse de régression multiple ?R peut effectuer une régression multiple à l’aide de la fonction lm(), ce qui permet d’utiliser plusieurs variables explicatives.
Q5 : Comment interpréter les coefficients d’un modèle linéaire ?Les coefficients d’un modèle linéaire indiquent dans quelle mesure la variable dépendante varie pour une variation d’une unité d’une variable indépendante.
Q6 : Quelles sont les techniques de tracé avancées en R ?Les techniques avancées incluent les graphiques interactifs avec ggplot2 et plotly, et la personnalisation des graphiques avec des packages R supplémentaires.
Q7 : Pourquoi la visualisation des données est-elle importante dans l’analyse de régression ?La visualisation aide à comprendre les tendances, les schémas et la force des relations entre les variables.
Q8 : Quelle est l’importance de l’ordonnée à l’origine dans une droite de régression ?L’ordonnée à l’origine est la valeur moyenne attendue de Y lorsque toutes les variables X sont nulles. C’est le point de départ de la droite de régression sur l’axe des ordonnées.
Q9 : Comment puis-je personnaliser les graphiques dans R ?Utilisez les arguments de la fonction plot comme pch, cex et col pour modifier l’apparence des points, leur taille et leur couleur.
Q10 : Quelle est la meilleure pratique pour préparer des données en vue d’une régression linéaire dans R ?Assurez la qualité des données en les nettoyant, en les normalisant et en explorant leur structure afin de comprendre leur fonctionnement avant d’appliquer l’analyse de régression.