Régression logistique utilisant R : le guide définitif
Vous apprendrez le rôle central de la régression logistique utilisant R dans l'analyse prédictive et la prise de décision basée sur les données.
Introduction
Dans le domaine dynamique de la science des données,régression logistiqueest un outil essentiel pour les problèmes de classification binaire, offrant une analyse approfondie des données grâce à la modélisation prédictive. Cette technique statistique, notamment lorsqu'elle est utilisée avecR, un outil polyvalent reconnu pour ses capacités d'analyse et de modélisation statistiques, permet aux analystes et aux chercheurs de révéler des tendances cachées et de prendre des décisions éclairées. La synergie entre la régression logistique et R offre aux praticiens un cadre robuste pour relever les défis complexes liés aux données, jetant ainsi les bases d'une innovation fondée sur les données et d'analyses stratégiques. Ce guide a pour objectif d'éclairer le chemin vers la maîtrise de la régression logistique avec R, en veillant à ce que les lecteurs disposent des connaissances nécessaires pour exploiter pleinement le potentiel de cette puissante approche analytique.
Points forts
- R simplifie les modèles de régression logistique complexes pour une meilleure précision prédictive.
- La régression logistique dans R aide à distinguer efficacement les résultats binaires.
- Le prétraitement des données dans R améliore la fiabilité du modèle de régression logistique.
- La syntaxe de R facilite la mise en œuvre intuitive de l'analyse de régression logistique.
- Des exemples concrets illustrent la valeur pratique de la régression logistique utilisant R.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Comprendre la régression logistique
La régression logistique est un pilier de la science des données, notamment pour résoudre les problèmes de classification à résultats dichotomiques, comme spam ou non-spam, victoire ou défaite, santé ou maladie. Contrairement à la régression linéaire, qui prédit des résultats continus,régression logistiqueattribue une probabilité à un ensemble donné de caractéristiques ou d'entrées d'appartenir à une catégorie spécifique. Elle s'avère ainsi indispensable dans des domaines tels que la médecine pour prédire la probabilité d'une maladie, la finance pour évaluer le risque de défaut de paiement et le marketing pour prédire le comportement des consommateurs.
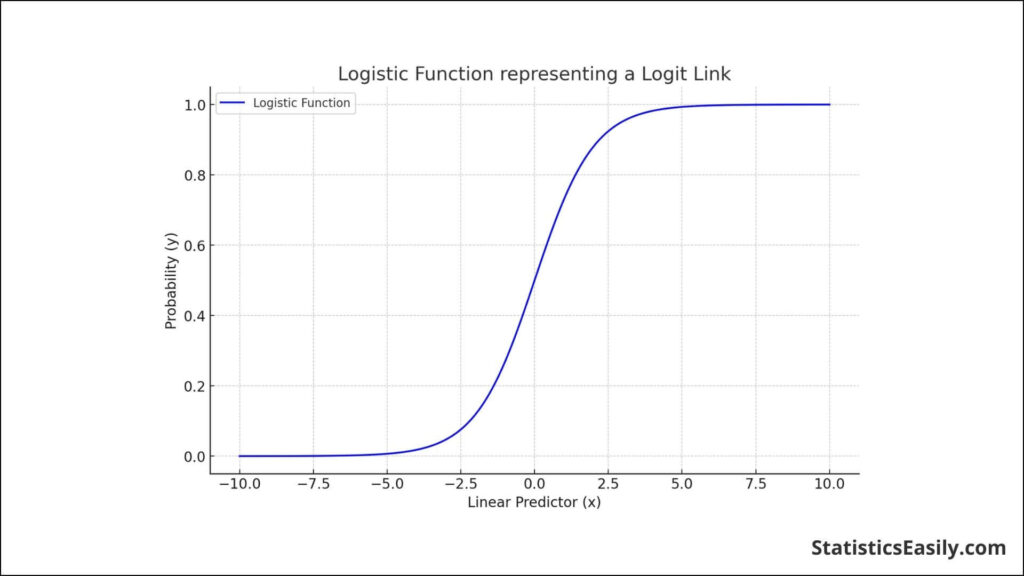
Le fondement mathématique de la régression logistique réside dans la fonction logistique, souvent appelée fonction sigmoïde. Cette courbe en forme de S peut mapper n'importe quel nombre à valeur réelle en une valeur comprise entre 0 et 1, ce qui la rend parfaite pour modéliser les scores de probabilité dans les tâches de classification binaire. L'équation de régression logistique contraste avec celle de régression linéaire principalement par son utilisation de la fonction logistique pour modéliser la variable dépendante. Le modèle de régression logistique estime ainsi la probabilité qu'un point d'entrée donné appartienne à une certaine classe, qui peut être exprimée mathématiquement comme suit :
P(Y=1∣X)=1/1+e−(β0+β1X)
où P(Y=1∣X) est la probabilité que la variable dépendante Y soit égale à un étant donné les variables indépendantes X, e est la base du logarithme naturel, β0 est le terme d'interception et β1 représente le(s) coefficient(s) de la ou des variables indépendantes qui influencent la variable dépendante.
En R, la régression logistique peut être implémentée à l'aide de fonctions telles que `glm()` (modèles linéaires généralisés), en spécifiant l'option `--binomial` pour indiquer qu'il s'agit d'une régression logistique binomiale. La simplicité de cette implémentation, combinée à la richesse des outils de R pour la manipulation et l'analyse des données, fait de la régression logistique avec R une approche puissante pour la modélisation prédictive. Grâce aux capacités de R, les data scientists peuvent prétraiter les données, construire des modèles de régression logistique, évaluer leurs performances et les utiliser pour la prédiction avec une relative facilité, confirmant ainsi la polyvalence de R dans l'arsenal de l' analyse et de la modélisation l'analyse des données et de modélisation.
Premiers pas avec R
Pour débuter avec R, un langage et un environnement de programmation reconnus pour le calcul statistique et la création de graphiques, il est essentiel de mettre en place les bases nécessaires. Pour les débutants, la première étape consiste à installer R, une opération simple et accessible depuis leComprehensive R Archive Network (CRAN). Il est fortement recommandé d'installer égalementRStudio, un environnement de développement intégré (IDE) puissant qui améliore l'expérience utilisateur de R grâce à son interface intuitive et ses fonctionnalités supplémentaires.
Lors de l'installation, il est primordial de se familiariser avec la syntaxe de R pour une analyse pratique des données. La syntaxe de R est unique mais intuitive, permettant aux utilisateurs d'effectuer des manipulations et des analyses de données complexes avec un code concis. Les concepts clés incluent :
- Variables et types de données :Comprenez comment attribuer des valeurs aux variables et aux différents types de données dans R, tels que numériques, caractères et logiques.
- Vecteurs et trames de données :Maîtrisez la création et la manipulation de vecteurs et de trames de données, l'épine dorsale de l'analyse des données dans R.
- Fonctions et forfaits :Apprenez à utiliser les fonctions intégrées et à installer et charger des packages, étendant ainsi les capacités de R bien au-delà de ses fonctionnalités de base. Des packages tels que « glmnet » et « caret » sont inestimables pour la régression logistique.
- Structures de contrôle:Apprenez les structures de contrôle telles que les instructions if-else et les boucles, qui vous permettent de contrôler le flux d'exécution de vos scripts.
Un exemple simple mais illustratif de la syntaxe de R en action est la création et la manipulation d'un bloc de données, qui pourrait ressembler à ceci :
# Create a data frame
my_data <- data.frame(
  Outcome = c("Success", "Fail", "Success", "Fail"),
  Age = c(22, 45, 33, 29),
  Score = c(85, 47, 76, 62)
)

# View the data frame
print(my_data)

# Calculate the mean Score
mean_score <- mean(my_data$Score)
print(paste("Average Score:", mean_score))
Cet extrait montre l'affectation de variables, la création de blocs de données et l'utilisation des fonctions principales. La puissante suite d'outils de R et son approche globale de la manipulation et de l'analyse des données en font une compétence essentielle aussi bien pour les data scientists que pour les statisticiens.
Préparer vos données pour la régression logistique
Avant d'appliquer une régression logistique dans R, une étape cruciale consisteà nettoyer et à prétraiter les données. Ce processus garantit que l'ensemble de données est correctement formaté, exempt d'erreurs ou d'informations non pertinentes, et structuré de manière à optimiser les performances et la précision de votre modèle de régression logistique.
Nettoyage des donnéescomprend plusieurs tâches essentielles :
- Gestion des valeurs manquantes :Utilisez des fonctions telles que « na.omit() » pour supprimer ou « impute() » du package mouse pour remplir les valeurs manquantes avec des estimations.
- Suppression des valeurs aberrantes :Les valeurs aberrantes peuvent fausser les résultats. Des techniques telles que la méthode Interquartile Range (IQR) peuvent aider à identifier et à éliminer ces anomalies.
- Assurer la cohérence des données :Standardisez le formatage de vos données, comme les formats de date et les valeurs catégorielles, pour éviter les incohérences.
Prétraitement des donnéescomprend :
- Sélection des variables :Identifiez les variables les plus pertinentes par rapport au résultat prévu. Cela peut impliquer des techniques statistiques telles que l'analyse de corrélation ou l'expertise de domaine.
- Transformation des Données:Convertissez les variables catégorielles en variables factices ou en facteurs avec des fonctions telles que « factor() » ou « model.matrix() », car la régression logistique nécessite une entrée numérique.
- Mise à l'échelle des fonctionnalités :Bien que cela ne soit pas toujours nécessaire pour la régression logistique, la standardisation des fonctionnalités à l'aide de fonctions de mise à l'échelle peut parfois améliorer les performances du modèle.
Un exemple illustratif de préparation de vos données pourrait impliquer la transformation d'une variable catégorielle dans un format adapté à la régression logistique :
# Assuming 'Gender' is a categorical variable with levels 'Male' and 'Female'
my_data$Gender <- factor(my_data$Gender, levels = c("Male", "Female"))

# Transforming 'Gender' into a dummy variable
my_data <- model.matrix(~ Gender + Age + Score - 1, data = my_data)
Cet extrait montre la conversion de la variable catégorielle « Sexe » en une variable fictive, une étape standard dans la préparation des données pour la régression logistique. Cela permet au modèle d’intégrer efficacement ces informations.
The importance du choix des variables appropriéesest capitale. Inclure des variables qui prédisent fortement le résultat peut améliorer la précision du modèle, tandis que des variables non pertinentes risquent d'en diluer le pouvoir prédictif. Des techniques telles que l'élimination rétrograde, la sélection progressive ou encore des algorithmes d'apprentissage automatique comme Random Forest peuvent être utilisées pour identifier les prédicteurs significatifs.
En résumé, une préparation minutieuse des données ouvre la voie à un modèle de régression logistique robuste. Il approfondit votre compréhension de l'ensemble de données, conduisant à une analyse de données plus perspicace et plus percutante.
Implémentation de la régression logistique à l'aide de R
La mise en œuvre de la régression logistique dans R implique une approche claire et structurée. Cette section vous guidera à travers les étapes à suivre pour effectuer une régression logistique, y compris des extraits de code pour plus de clarté. L'accent sera mis sur la manière de construire le modèle, d'interpréter ses résultats et de comprendre l'importance des coefficients et de l'ajustement du modèle.
Guide étape par étape
1. Chargement du package requis :Pour effectuer une régression logistique, assurez-vous d’avoir le package « stats », préinstallé avec R. Ce package inclut la fonction « glm() », essentielle pour la régression logistique.
# Ensure the stats package is loaded (it should be by default)
library(stats)
2. Construction du modèle de régression logistique :Utilisez la fonction « glm() » en spécifiant la famille binomiale pour indiquer une régression logistique. Supposons que « my_data » représente votre jeu de données, « Outcome » la variable dépendante binaire et « Predictor1 » et « Predictor2 » vos variables indépendantes.
# Building the logistic regression model as before
logistic_model <- glm(Outcome ~ Predictor1 + Predictor2, family = binomial, data = my_data)

# Performing a Likelihood Ratio Test
anova(logistic_model, test = "Chisq")
3. Résumé du modèle :Pour comprendre les coefficients du modèle et leur signification, utilisez la fonction « summary() ».
# Summarizing the logistic regression model
summary(logistic_model)
Interprétation du résultat
- Coefficients :La sortie récapitulative fournit des coefficients pour chaque prédicteur. Ces coefficients représentent le log des probabilités pour la variable de résultat. Un coefficient positif indique qu'à mesure que la variable prédictive augmente, les chances logarithmiques que le résultat se produise augmentent, ce qui rend l'événement plus probable.
- Niveaux de signification :Regardez la colonne « Pr(>|z|) » dans le résultat récapitulatif. Les valeurs ici représentent la valeur p pour chaque coefficient. En règle générale, une valeur p inférieure à 0.05 indique que le prédicteur est associé de manière significative à la variable de résultat.
- Modèle adapté :Le résumé comprend également des mesures d'adéquation. L'écart nul et résiduel indique dans quelle mesure le modèle s'adapte aux données. Une déviance résiduelle inférieure à la déviance nulle suggère un bon ajustement. De plus, le critère d'information Akaike (AIC) mesure la qualité du modèle, un AIC inférieur indiquant un modèle qui s'adapte mieux aux données sans surajustement.
Exemple d’interprétation sommaire
Considérez l'extrait de sortie ci-dessous d'un résumé de régression logistique :
Coefficients:
            Estimate Std. Error z value Pr(>|z|)
(Intercept)  -1.2345     0.2079  -5.939  3.00e-09 ***
Predictor1     0.4456     0.1102   4.045  5.25e-05 ***
Predictor2    -0.5678     0.1456  -3.900  9.68e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 234.83  on 170  degrees of freedom
Residual deviance: 144.57  on 168  degrees of freedom
AIC: 150.57
- Les valeurs « Intercept » et « Predictor1 » et « Predictor2 » sont significatives (p < 0.05).
- « Predictor1 » a un coefficient positif, ce qui suggère que l'augmentation de « Predictor1 » augmente le log des chances du résultat.
- « Predictor2 » a un coefficient négatif, indiquant qu'une augmentation de « Predictor2 » diminue le log des chances du résultat.
- La baisse substantielle de la déviance et de la valeur AIC suggère un bon ajustement du modèle.
En suivant ces étapes et en comprenant les résultats du modèle, vous pouvez implémenter efficacement la régression logistique dans R, ouvrant ainsi la voie à une analyse de données approfondie et à une modélisation prédictive.
Améliorer votre régression logistique à l'aide de R
L'amélioration de la précision et du pouvoir prédictif d'un modèle de régression logistique dans R implique plusieurs étapes stratégiques, depuis la sélection réfléchie des fonctionnalités jusqu'aux techniques avancées d'évaluation du modèle. Voici quelques conseils et méthodes pour améliorer votre modèle de régression logistique :
Sélection et transformation des fonctionnalités
1. Importance des variables :Utilisez des techniques comme la régression pas à pas ou des algorithmes d’apprentissage automatique (par exemple, Random Forest) pour identifier les variables les plus prédictives de votre modèle. Cela permet de simplifier le modèle en ne conservant que les prédicteurs significatifs.
library(MASS)
stepwise_model <- stepAIC(logistic_model, direction = "both")
summary(stepwise_model)
2. Gestion de la multicolinéarité :Une forte corrélation entre les prédicteurs peut fausser la signification des variables. Utilisez le facteur d’inflation de la variance (VIF) pour détecter la multicolinéarité et envisagez de supprimer ou de combiner les variables fortement corrélées.
library(car)
vif(logistic_model)
3. Transformation des données :Les relations non linéaires entre les prédicteurs et le logarithme des cotes peuvent être capturées grâce à des transformations telles que des termes polynomiaux ou des effets d'interaction.
logistic_model <- glm(Outcome ~ poly(Predictor1, 2) + Predictor2 + Predictor1:Predictor2, family = binomial, data = my_data)
Techniques d'évaluation des modèles
1. Validation croisée :Mettre en œuvre une validation croisée à k plis pour évaluer les performances prédictives du modèle sur des données non vues, ce qui contribue à atténuer le surapprentissage.
library(caret)
control <- trainControl(method = "cv", number = 10)
cv_model <- train(Outcome ~ Predictor1 + Predictor2, data = my_data, method = "glm", family = "binomial", trControl = control)
2. Métriques de performance du modèle :Au-delà des contrôles AIC et de déviance, considérez l’analyse ROC (Receiver Operating Characteristic) et calculez l’AUC (Area Under the Curve) pour évaluer la capacité de discrimination du modèle entre les classes de résultats.
library(pROC)
roc_response <- roc(response = my_data$Outcome, predictor = fitted(logistic_model))
auc(roc_response)
3. Analyse des résidus :Examiner les résidus du modèle pour s'assurer qu'aucun schéma ne suggère un mauvais ajustement du modèle, comme des tendances ou des regroupements.
plot(residuals(logistic_model, type = "deviance"))
L'amélioration de votre modèle de régression logistique implique d'équilibrer soigneusement l'ingénierie des fonctionnalités, l'évaluation méthodique du modèle et le raffinement continu basé sur des mesures de performances. En employant ces techniques, vous pouvez créer un modèle plus précis, plus robuste et interprétable qui capture mieux la complexité de vos données et fournit des prédictions plus fiables.
Applications réelles de la régression logistique utilisant R
La régression logistique, principalement lorsqu'elle est utilisée dans l'environnement R, s'est révélée inestimable dans un large éventail d'applications du monde réel. Sa polyvalence dans la gestion des résultats binaires en fait une méthode incontournable pour divers domaines cherchant à prendre des décisions éclairées basées sur l'analyse prédictive. Nous examinons ici des exemples pratiques où la régression logistique a été appliquée avec succès, mettant en lumière les enseignements et les implications de ses résultats.
Santé et médecine
Dans le domaine médical, la régression logistique a été largement utilisée pour prédire la probabilité d’apparition d’une maladie sur la base des données des patients. Par exemple, en analysant les attributs des patients tels que l’âge, l’IMC et la tension artérielle, les modèles de régression logistique peuvent prédire la probabilité d’apparition du diabète. Ce pouvoir prédictif aide les professionnels de la santé à identifier les patients à haut risque, permettant ainsi une intervention précoce et des stratégies de prise en charge.
# Predicting diabetes occurrence
diabetes_model <- glm(Diabetes ~ Age + BMI + BloodPressure, family = binomial, data = patient_data)
Services financiers
Les secteurs bancaire et financier exploitent la régression logistique pour évaluer le risque de crédit. En évaluant les données des clients telles que les revenus, les antécédents de crédit et les niveaux d’endettement, la régression logistique aide à prédire la probabilité de défaut de paiement du prêt. Cette information est cruciale pour que les institutions financières puissent prendre des décisions de prêt éclairées, minimisant ainsi les risques et optimisant les processus d’approbation des prêts.
# Credit risk assessment
credit_risk_model <- glm(Default ~ Income + CreditHistory + DebtLevel, family = binomial, data = customer_data)
Analyses de marketing
En marketing, la régression logistique prédit le comportement des clients, comme la probabilité d'acheter un produit ou de répondre à une campagne. Les modèles de régression logistique permettent aux spécialistes du marketing d'adapter leurs campagnes plus efficacement en analysant les données d'achat historiques et les informations démographiques, en améliorant l'engagement des clients et en optimisant les stratégies marketing.
# Predicting customer purchase behavior
purchase_model <- glm(Purchase ~ Age + Gender + PreviousPurchases, family = binomial, data = sales_data)
Sciences sociales
La régression logistique est également utilisée dans la recherche en sciences sociales, en particulier dans des domaines tels que l'analyse du comportement électoral ou la compréhension des tendances sociales. En examinant des facteurs tels que l'âge, l'éducation et le statut socio-économique, les modèles de régression logistique donnent un aperçu de la probabilité de certains comportements sociaux, contribuant ainsi à l'élaboration des politiques et à la compréhension sociologique.
# Analyzing voting behavior
voting_model <- glm(Voted ~ Age + EducationLevel + SocioEconomicStatus, family = binomial, data = survey_data)
Implications et perspectives
L'application réussie de la régression logistique dans ces domaines souligne son importance dans la modélisation prédictive. Quantifier les probabilités de résultats binaires sur la base de variables prédictives permet aux parties prenantes de prendre des décisions fondées sur des preuves, améliorant ainsi l'efficience et l'efficacité dans leurs domaines respectifs.
De plus, les enseignements des analyses de régression logistique peuvent conduire à des mesures proactives, à des formulations de politiques et à des ajustements stratégiques dans tous les secteurs. Les organisations et les professionnels peuvent mettre en œuvre des interventions ciblées en identifiant les prédicteurs clés et en comprenant leur impact sur les résultats, favorisant ainsi des résultats positifs et atténuant les risques.
La régression logistique utilisant R facilite une compréhension plus approfondie des relations complexes au sein des ensembles de données. Il permet à divers secteurs d'exploiter l'analyse prédictive pour une prise de décision éclairée, démontrant ainsi son rôle inestimable dans l'avancement des initiatives basées sur les données dans le monde entier.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusion
Dans ce voyage complet à travers la régression logistique utilisant R, nous avons dévoilé l'impact profond et la polyvalence de cette technique statistique dans divers domaines. Des soins de santé à la finance et aux sciences sociales, la régression logistique constitue un phare pour ceux qui cherchent à éclairer les modèles cachés dans leurs données. Il offre une lentille prédictive à travers laquelle les résultats binaires peuvent être prévus avec précision. La maîtrise de la régression logistique dans R fournit non seulement aux analystes et aux chercheurs un outil puissant pour la prise de décision basée sur les données, mais favorise également une appréciation plus profonde de l'art et de la science de la modélisation prédictive. Au fur et à mesure que nous sommes passés des concepts fondamentaux aux applications avancées, la valeur de la régression logistique dans l’élaboration de stratégies et d’interventions éclairées est devenue tout à fait claire.
Articles recommandés
Explorez plus profondément le monde de la science des données avec nos articles connexes. Plongez dans d'autres sujets pour élargir votre expertise en matière d'analyse.
- Régression logistique Scikit-Learn : un guide complet pour les scientifiques des données
- Comprendre les distributions des modèles linéaires généralisés
- Quelles sont les hypothèses de régression logistique ?
- Quels sont les 3 types de régression logistique ?
- Régression logistique à l'aide de Scikit-Learn (Récit)
- Maîtriser la régression logistique (Récit)
Foire Aux Questions (FAQ)
Q1 : Qu’est-ce que la régression logistique dans R ?C’est une méthode statistique permettant de prédire des résultats binaires à partir de variables indépendantes.
Q2 : Pourquoi utiliser R pour la régression logistique ?R fournit des packages complets comme glm() pour une analyse de régression logistique efficace et détaillée.
Q3 : En quoi la régression logistique diffère-t-elle de la régression linéaire ?Contrairement à la régression linéaire, qui prédit des valeurs continues, la régression logistique prédit des résultats binaires (0 ou 1).
Q4 : Quels sont les prérequis pour effectuer une régression logistique avec R ?Une connaissance de base de la programmation R et des concepts statistiques est essentielle pour l’analyse de régression logistique.
Q5 : Comment interpréter les résultats d’une régression logistique dans R ?Les résultats comprennent des coefficients, qui indiquent la relation entre chaque prédicteur et le logarithme des cotes de l’événement.
Q6 : Quel est le rôle du prétraitement des données dans la régression logistique ?Le prétraitement consiste à nettoyer et à transformer les données afin d’améliorer la précision et l’efficacité du modèle.
Q7 : La régression logistique peut-elle gérer les variables catégorielles ?La régression logistique peut inclure des variables catégorielles grâce au codage binaire ou aux variables factorielles dans R.
Q8 : Comment améliorer la précision d’un modèle de régression logistique dans R ?La précision du modèle peut être améliorée par la sélection de caractéristiques, la gestion de la multicolinéarité et l’utilisation de techniques de régularisation.
Q9 : Quels sont les défis courants de la régression logistique ?Les défis comprennent la gestion des ensembles de données déséquilibrés, la sélection des caractéristiques pertinentes et le diagnostic de l’adéquation du modèle.
Q10 : Où peut-on appliquer la régression logistique avec R ?Elle est largement utilisée dans des domaines comme la médecine, le marketing, la finance et les sciences sociales pour la prédiction de résultats binaires.