Détection et traitement des valeurs aberrantes : un guide complet
Vous apprendrez les techniques essentielles de détection et de traitement des valeurs aberrantes, en affinant les données pour obtenir des informations véridiques.
Introduction
En science des données,détection et traitement des valeurs aberrantesconstituent un processus essentiel qui garantit l'intégrité et la fiabilité des l'analyse des données. Ces valeurs aberrantes — des points de données qui s'écartent sensiblement de la norme — posent des problèmes importants, faussant les résultats et conduisant à des conclusions erronées. Détecter et traiter les valeurs aberrantes ne se limite pas à l'amélioration des données ; il s'agit de respecter les principes d'exactitude et de fiabilité propres à la démarche scientifique. Ce guide vise à fournir aux data scientists les connaissances et les outils nécessaires pour appréhender la complexité des valeurs aberrantes, afin que leurs travaux reflètent les plus hautes exigences d'intégrité statistique et contribuent à l'avancement des connaissances dans ce domaine.
Points forts
- Les valeurs aberrantes peuvent fausser considérablement l’analyse des données, conduisant à des conclusions trompeuses.
- Les méthodes statistiques telles que le score Z et l'IQR sont fondamentales pour détecter les valeurs aberrantes.
- Les approches d'apprentissage automatique offrent des solutions avancées pour l'identification des valeurs aberrantes dans des ensembles de données complexes.
- Un traitement approprié des valeurs aberrantes peut améliorer considérablement la précision du modèle et les performances prédictives.
- Les considérations éthiques liées au traitement des valeurs aberrantes soulignent l’intégrité de la science des données.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Comprendre les valeurs aberrantes
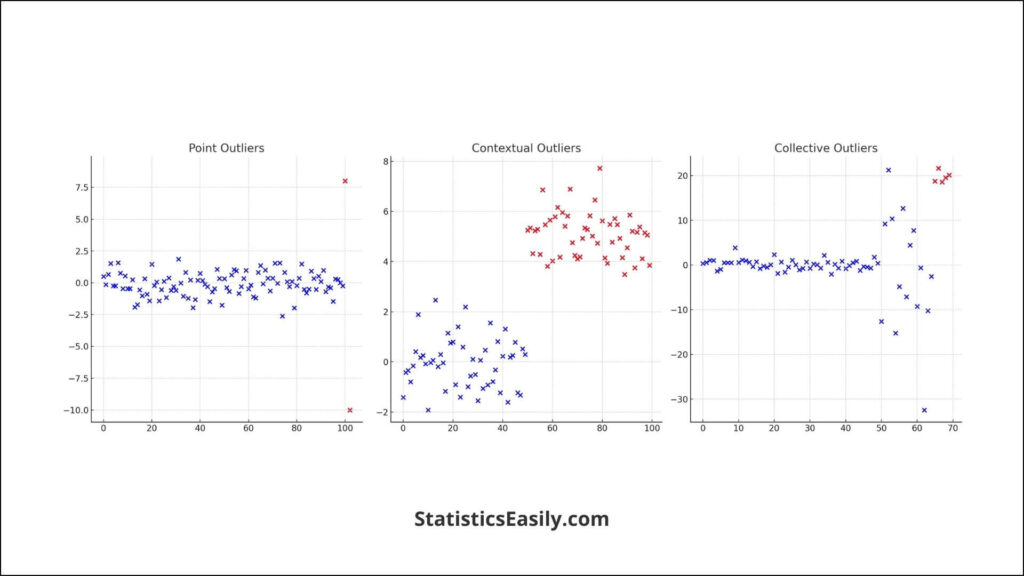
En science des données,valeurs aberrantessont des points de données qui s'écartent nettement de la tendance générale d'un ensemble de données. Ces anomalies peuvent impacter significativement l'analyse globale, entraînant des résultats faussés et des conclusions potentiellement trompeuses. On distingue principalement trois types de valeurs aberrantes : lesvaleurs aberrantes ponctuelles, qui sont des points de données isolés très éloignés du reste des données ;les valeurs aberrantes contextuelles, qui sont des points de données considérés comme anormaux dans un contexte spécifique ; etles valeurs aberrantes collectives, lorsqu'un ensemble de points de données est inhabituel par rapport à l'ensemble des données.
Le fondement théorique de l’analyse des valeurs aberrantes souligne le rôle essentiel que jouent la détection et le traitement des valeurs aberrantes dans le maintien de l’intégrité de l’analyse des données. Les valeurs aberrantes peuvent fausser les mesures statistiques, telles que la moyenne et l'écart type, affectant ainsi le résultat de l'analyse des données. Par exemple, une seule valeur aberrante peut modifier considérablement la moyenne, ce qui pourrait conduire à des conclusions erronées sur les tendances et les comportements des données.
Comprendre et identifier ces valeurs aberrantes est crucial pour tout processus d’analyse de données robuste. En reconnaissant et en traitant les valeurs aberrantes de manière appropriée, les data scientists peuvent garantir que les conclusions tirées de l'analyse des données sont exactes et reflètent la véritable nature des données sous-jacentes. Cette étape ne consiste pas seulement à nettoyer les données, mais également à préserver l’essence de ce que les données sont censées représenter, adhérant ainsi aux principes de vérité et d’intégrité du processus scientifique.
Causes des valeurs aberrantes
Les valeurs aberrantes dans les ensembles de données peuvent provenir de nombreuses sources, chacune nécessitant une analyse approfondie pour une précision optimale.Les erreurs de mesuresont une cause fréquente : les instruments ou les erreurs humaines produisent des points de données très éloignés de la valeur réelle.Les erreurs de saisieconstituent une autre source importante, souvent dues à des fautes de frappe ou à une mauvaise interprétation des unités, ce qui conduit à des valeurs anormalement élevées ou faibles. Par ailleurs,la variabilité naturelledes données peut également générer des valeurs aberrantes, notamment dans les systèmes complexes où apparaissent des valeurs extrêmes inattendues mais réelles.
Prenons le cas d’une expérience scientifique mesurant une concentration chimique particulière. Un spectromètre défectueux pourrait signaler une concentration anormalement élevée, une valeur aberrante résultant d’une erreur de mesure. Dans un autre scénario, une erreur de saisie de données pourrait introduire une valeur aberrante lorsqu'un chiffre supplémentaire est accidentellement ajouté à une lecture. Enfin, dans un ensemble de données documentant la taille humaine, un individu exceptionnellement grand représente une variabilité naturelle, introduisant une valeur aberrante vraie et reflétant la diversité de la population.
Ces exemples soulignent l’importance de discerner la nature des valeurs aberrantes. Même si l’instinct peut être de les supprimer, comprendre leurs causes peut offrir des perspectives plus approfondies. Par exemple, la valeur aberrante dans les données de concentration chimique incite à vérifier l’équipement, garantissant ainsi l’exactitude future. L’individu anormalement grand dans l’ensemble de données sur la taille pourrait intéresser les chercheurs qui étudient les facteurs génétiques influençant la taille.
Par conséquent, l’élimination des valeurs aberrantes ne devrait pas être un processus réflexif mais un processus réfléchi, prenant en compte le contexte et la cause. Cette approche garantit que l’analyse des données reste fondée sur la vérité, reflétant fidèlement la réalité sous-jacente et incarnant les principes d’intégrité et de rigueur de la recherche scientifique.
Techniques de détection
La détection des valeurs aberrantes est une étape essentielle de l’analyse des données, garantissant l’exactitude et la fiabilité des modèles statistiques. Diverses méthodes ont été développées pour identifier efficacement ces anomalies.
Méthodes statistiques:
Le score Zest l'une des méthodes les plus courantes pour détecter les valeurs aberrantes. Cette technique mesure le nombre d'écarts types séparant une donnée de la moyenne. Généralement, les données dont le score Z dépasse ±3 sont considérées comme des valeurs aberrantes.
Intervalle interquartile (IQR)consiste à calculer la distance entre le premier (25e percentile) et le troisième quartile (75e percentile) des données. Les valeurs aberrantes sont alors identifiées comme étant les points de données qui se situent en dessous du premier quartile ou au-dessus du troisième quartile d'au moins 1.5 fois l'EIQ.
Le test de Grubbs, ou test du résidu normalisé maximal, détecte une valeur aberrante unique dans un ensemble de données. Ce test suppose une distribution normale et est particulièrement adapté lorsqu'on soupçonne la présence d'une seule valeur aberrante.
Approches d’apprentissage automatique :
L'apprentissage automatique offre des techniques avancées pour identifier les valeurs aberrantes dans les grands ensembles de données. Des algorithmes tels queles forêts d'isolationetDBSCAN (regroupement spatial d'applications avec bruit basé sur la densité)sont particulièrement efficaces pour détecter les anomalies en tenant compte de la distribution et de la densité des données.
Études de cas:
Une application notable de la détection des valeurs aberrantes estla détection des fraudes. Les institutions financières utilisent des modèles d'apprentissage automatique pour identifier les transactions inhabituelles qui s'écartent significativement des habitudes de dépenses d'un client et qui pourraient indiquer une fraude.
Ensoins de santé, les méthodes de détection des valeurs aberrantes permettent de surveiller les réponses inhabituelles aux traitements. Par exemple, une réaction indésirable inattendue à un médicament lors d'un essai clinique pourrait constituer une valeur aberrante, signalant la nécessité d'investigations complémentaires.
Le domaine desscience de l'environnementbénéficie également de la détection des valeurs aberrantes. Les chercheurs peuvent identifier et étudier les variations anormales des données climatiques, telles que les pics soudains de température ou de précipitations, afin de mieux comprendre la dynamique du changement climatique.
Stratégies de traitement et de manipulation
L'identification des valeurs aberrantes n'est que la première étape de l'analyse des données. La manière dont nous traitons et traitons ces valeurs aberrantes est une décision cruciale qui influence considérablement les résultats et l’intégrité de notre étude. Les stratégies de traitement des valeurs aberrantes comprennent la suppression, la transformation et l'imputation, chacune avec son contexte d'application et ses implications.
La suppressionest l'approche la plus simple, mais elle doit être utilisée avec prudence. Éliminer des points de données peut entraîner une perte d'informations précieuses ou un biais dans les résultats. Cette méthode est généralement réservée aux erreurs manifestes ou lorsque l'influence d'une valeur aberrante est disproportionnée par rapport à sa pertinence.
Transformationconsiste à appliquer des fonctions mathématiques pour réduire l'asymétrie introduite par les valeurs aberrantes. Les transformations courantes incluent les transformations logarithmiques, racine carrée ou inverses. Cette méthode permet de normaliser la distribution des données, ce qui rend l'analyse plus efficace sans supprimer directement les points de données.
L'imputationconsiste à remplacer les valeurs aberrantes par des valeurs estimées, généralement à l'aide de la médiane, de la moyenne ou de méthodes de régression. Cette stratégie est appropriée lorsque la donnée est considérée comme erronée mais révélatrice d'une tendance sous-jacente qu'il convient de corriger.
Considérations éthiques:
L’intégrité de la prise de décision en cas de traitement des cas aberrants doit être équilibrée. Chaque stratégie a sa place, mais le choix doit être justifié éthiquement et scientifiquement. La suppression d'un point de données parce qu'il est peu pratique remet en question la recherche de la vérité, tout comme la transformation ou l'imputation aveugle sans comprendre la nature des données. La pratique éthique exige de la transparence sur la manière dont les valeurs aberrantes sont traitées et la reconnaissance de l'impact potentiel sur les conclusions de l'analyse.
Par exemple, supprimer les valeurs aberrantes des données sur la pollution sans enquêter sur leur cause dans les sciences de l’environnement pourrait masquer d’importantes menaces écologiques. De même, les réponses aberrantes des patients au traitement dans le cadre des soins de santé pourraient révéler des informations cruciales sur les effets secondaires ou sur de nouvelles voies thérapeutiques.
En fin de compte, le traitement et la gestion des valeurs aberrantes ne devraient pas seulement viser à obtenir des données plus claires ou des voies d’analyse plus confortables, mais devraient refléter un engagement à découvrir et à comprendre les vérités sous-jacentes au sein des données. Cet engagement garantit que notre travail fait progresser les connaissances avec intégrité et respect des phénomènes que nous cherchons à comprendre.
Outils et logiciels pour la détection des valeurs aberrantes
Divers outils et logiciels sont devenus des alliés indispensables pour les data scientists dans leur quête d’identification et de gestion des valeurs aberrantes. Ces outils, équipés d'algorithmes sophistiqués et d'interfaces conviviales, améliorent la précision de la détection des valeurs aberrantes et rationalisent le processus de traitement, soutenant ainsi la recherche scientifique de la vérité.
Bibliothèques Python :
- Scikit-learn: Réputé pour ses capacités complètes d'apprentissage automatique, scikit-learn propose des méthodes pratiques de détection des valeurs aberrantes, telles que Isolation Forest et Local Outlier Factor (LOF). Sa polyvalence et sa facilité d'intégration en font un incontournable dans la boîte à outils du data scientist.
- PyOD: Bibliothèque spécialisée dédiée à la détection des valeurs aberrantes, PyOD comprend un large éventail d'algorithmes de détection, depuis les approches classiques comme ABOD (Angle-Based Outlier Detection) jusqu'aux modèles contemporains basés sur des réseaux de neurones. L'API cohérente de PyOD et l'intégration avec scikit-learn facilitent une expérience d'analyse transparente.
Forfaits R :
- Détection des valeurs aberrantes: Ce package fournit des outils pour détecter et gérer les valeurs aberrantes dans les données univariées et multivariées. Il est particulièrement apprécié pour ses techniques statistiques robustes et son adaptabilité à différents types de données.
- mvoutlier: Spécialisé dans les données multivariées, mvoutlier propose des méthodes graphiques et statistiques pour identifier les valeurs aberrantes. Il s’agit d’un outil essentiel pour les ensembles de données complexes où les valeurs aberrantes peuvent mettre du temps à être évidentes.
Plateformes logicielles :
- KNIME:Un logiciel basé sur une interface utilisateur graphique qui permet des flux de travail d'analyse de données sophistiqués, y compris la détection des valeurs aberrantes. Sa structure modulaire intègre des méthodes statistiques classiques et des algorithmes avancés d'apprentissage automatique.
- Tableau: Connu pour ses prouesses en matière de visualisation de données, Tableau inclut également des fonctionnalités de détection des valeurs aberrantes, principalement via l'analyse visuelle. Cette fonctionnalité permet aux utilisateurs d'identifier rapidement les anomalies au sein de grands ensembles de données en observant les écarts dans les représentations graphiques.
—
Le rôle des valeurs aberrantes dans la modélisation prédictive et l'apprentissage automatique
Les valeurs aberrantes occupent une position nuancée dans la modélisation prédictive et l’apprentissage automatique, impactant de manière significative la précision du modèle et les performances prédictives. Comprendre leur rôle est crucial pour développer des modèles robustes et alignés avec la vérité des données qu'ils représentent.
Impact sur la précision et les performances du modèle
Les valeurs aberrantes peuvent influencer considérablement le processus de formation des modèles prédictifs. Par exemple, les valeurs aberrantes peuvent fausser la droite de régression dans les modèles de régression linéaire, entraînant de mauvaises performances du modèle sur l'ensemble de données général. Dans les algorithmes de clustering, les valeurs aberrantes peuvent modifier les centres du cluster, affectant ainsi la capacité du modèle à regrouper avec précision les points de données.
Gestion des valeurs aberrantes dans la formation de modèles
L'approche de gestion des valeurs aberrantes doit être soigneusement étudiée lors de la formation du modèle. Les options incluent :
- Exclusion: Suppression des valeurs aberrantes de l'ensemble de données avant la formation, ce qui peut être approprié lorsque les valeurs aberrantes sont des erreurs confirmées sans signification sous-jacente.
- Transformation: L'application de transformations mathématiques pour réduire la plage de points de données rend les valeurs aberrantes moins prononcées et améliore potentiellement la robustesse du modèle sans suppression pure et simple.
- Méthodes robustes: Utiliser des modèles et des algorithmes conçus pour être moins sensibles aux valeurs aberrantes, telles que les forêts aléatoires ou les méthodes de régression robustes.
S'assurer que les modèles sont robustes et véridiques
L'intégrité de la formation des modèles réside dans l'équilibre entre l'élimination du bruit et la préservation des données précieuses. Les véritables valeurs aberrantes liées à la variabilité ne doivent pas être supprimées à la hâte, mais plutôt comprises pour les informations qu'elles peuvent offrir. Cette compréhension peut conduire à des modèles plus précis et reflétant mieux la complexité et la vérité des phénomènes sous-jacents.
Conseils pour gérer les valeurs aberrantes
- Analyse et documentation: Analyser en profondeur les valeurs aberrantes pour déterminer leur cause et documenter les décisions prises concernant leur traitement.
- Validation: Utilisez des techniques de validation croisée pour garantir que le modèle fonctionne bien sur des données invisibles et que les stratégies de gestion des valeurs aberrantes améliorent la généralisabilité du modèle.
- Contrôle continu: Même après le déploiement, les modèles doivent être surveillés en permanence pour garantir qu'ils restent efficaces à mesure que de nouvelles données sont introduites, qui peuvent contenir de nouvelles valeurs aberrantes informatives.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusion
Le parcours de détection et de traitement des valeurs aberrantes est essentiel en science des données, car il garantit l’intégrité et la fiabilité de l’analyse des données. Cela témoigne du dévouement des data scientists à atteindre l'exactitude et à maintenir la vérité dans leurs efforts scientifiques. Comme nous l’avons exploré, l’identification, l’analyse et le traitement minutieux des valeurs aberrantes non seulement affinent nos données, mais approfondissent également notre compréhension, révélant des informations qui autrement pourraient rester obscurcies. Ce guide complet souligne la nécessité d'aborder les valeurs aberrantes avec un équilibre entre connaissances techniques et considérations éthiques, en alignant nos pratiques sur la recherche plus excellente de révéler la vérité dans les données. Laissez ce guide inspirer une quête continue de connaissances et l’application de principes éthiques dans le traitement des cas aberrants, favorisant une culture d’intégrité et de rigueur au sein de la communauté scientifique.
Articles recommandés
Découvrez-en davantage sur la façon d’affiner vos prouesses analytiques. Lisez nos articles connexes sur les techniques avancées de science des données et améliorez vos connaissances dès aujourd'hui !
- Naviguer dans les bases des modèles linéaires généralisés : une introduction complète
- Exactitude, précision, rappel ou F1 : quelle métrique prévaut ?
- Histogramme incliné à droite : données asymétriques (Récit)
- Tests T appariés principaux (Récit)
- Exemple de test t apparié
Foire Aux Questions (FAQ)
Q1 : Que sont exactement les valeurs aberrantes en analyse de données ?Les valeurs aberrantes sont des points de données qui diffèrent significativement des autres observations, ce qui peut fausser les analyses et les résultats statistiques.
Q2 : Pourquoi la détection et le traitement des valeurs aberrantes sont-ils importants ?L’identification et le traitement des valeurs aberrantes sont essentiels pour une analyse précise des données, garantissant que les modèles reflètent les véritables tendances sous-jacentes.
Q3 : Les valeurs aberrantes peuvent-elles être considérées comme des données précieuses ?Les valeurs aberrantes peuvent révéler de nouvelles informations ou des erreurs dans la collecte des données, et leur interprétation nécessite souvent une analyse approfondie.
Q4 : Quelles sont les méthodes standard pour détecter les valeurs aberrantes ?Le score Z et l’écart interquartile (EIQ) sont des méthodes statistiques courantes.
Q5 : Comment les modèles d’apprentissage automatique gèrent-ils les valeurs aberrantes ?Selon l’algorithme, les modèles d’apprentissage automatique peuvent nécessiter un prétraitement pour minimiser l’impact des valeurs aberrantes ou les prendre en compte intrinsèquement.
Q6 : Quel est l’impact des valeurs aberrantes sur la modélisation prédictive ?Les valeurs aberrantes peuvent fausser les prédictions du modèle si elles ne sont pas correctement prises en compte, ce qui conduit à des résultats moins précis ou biaisés.
Q7 : Existe-t-il des outils automatisés pour la détection des valeurs aberrantes ?Plusieurs logiciels et progiciels sont conçus spécifiquement pour détecter et traiter les valeurs aberrantes dans les ensembles de données.
Q8 : Comment le traitement des valeurs aberrantes varie-t-il selon le type de données ?Les stratégies de traitement peuvent inclure transformation de données, la suppression ou l’imputation des données, en fonction de la nature des données et des objectifs d’analyse.
Q9 : Quelles sont les considérations éthiques liées au traitement des valeurs aberrantes ?Les considérations éthiques comprennent la garantie de l’intégrité des données et l’évitement de toute manipulation susceptible de biaiser les résultats ou les conclusions.
Q10 : Comment puis-je approfondir mes connaissances en matière de détection et de traitement des valeurs aberrantes ?Suivre des cours avancés en science des données, des tutoriels et réaliser des projets pratiques permet d’approfondir sa compréhension et ses compétences en analyse des valeurs aberrantes.