Exactitude, précision, rappel ou F1 : quelle métrique prévaut ?
Vous apprendrez les différences cruciales entre l'exactitude, la précision, le rappel et la F1 pour choisir la bonne métrique d'évaluation.
Introduction
Enscience des donnéeseten modélisation prédictive, mesurer avec précision la performance d'un modèle est aussi crucial que de développer le modèle lui-même. Pourtant, face à la multitude de métriques disponibles (exactitude, précision, rappel et score F1), choisir celle qui correspond réellement à l'objectif de votre analyse demeure un défi complexe.
Vous vous demandez peut-être : « Quelle métrique sert le mieux la vérité du pouvoir prédictif de mon modèle ? » Cette décision a de profondes implications, non seulement pour l’intégrité de votre modèle, mais aussi pour les conséquences concrètes qui dépendent de ses prédictions.
Prenons l'exemple du secteur de la santé, où la capacité d'un modèle à prédire une maladie peut être une question de vie ou de mort. Dans ce contexte, le choix de l'indicateur dépasse la simple quantification : il témoigne de la valeur que nous accordons à la vie et au bien-être humains. Dès lors,précisionseule est-elle suffisante lorsqu'elle ne tient pas compte d'un faux négatif, d'un patient diagnostiqué à tort comme étant indemne de maladie ?
Prenons l'exemple de la détection des fraudes financières. À quoi sert un modèleprécises'il ne parvient pas à identifier les transactions frauduleuses, les confondant avec des activités légitimes ? Les répercussions ne se limitent pas aux pertes financières ; elles ébranlent les fondements mêmes de la confiance sur lesquels repose le système financier.
Dans les sections suivantes, nous décortiquerons chaque métrique avec précision, dévoilerons les contextes dans lesquels chaque métrique brille et, finalement, vous donnerons le discernement nécessaire pour sélectionner une métrique qui reflète l'efficacité de votre modèle et résonne avec les impératifs éthiques de votre travail.
Points forts
- La précision peut être trompeuse ; un score de 99.9 % pourrait ignorer des faux négatifs importants.
- La précision mesure combien de positifs prédits sont vrais, ce qui est essentiel pour la détection du spam.
- Recall calcule le taux de capture des positifs réels, ce qui est essentiel pour la détection des fraudes et des maladies.
- Le score F1 équilibre précision et rappel, ce qui est utile dans les répartitions inégales des classes.
- Le choix des métriques dépend du contexte ; aucune mesure ne convient à toutes les situations.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Les pièges de se fier uniquement à la précision
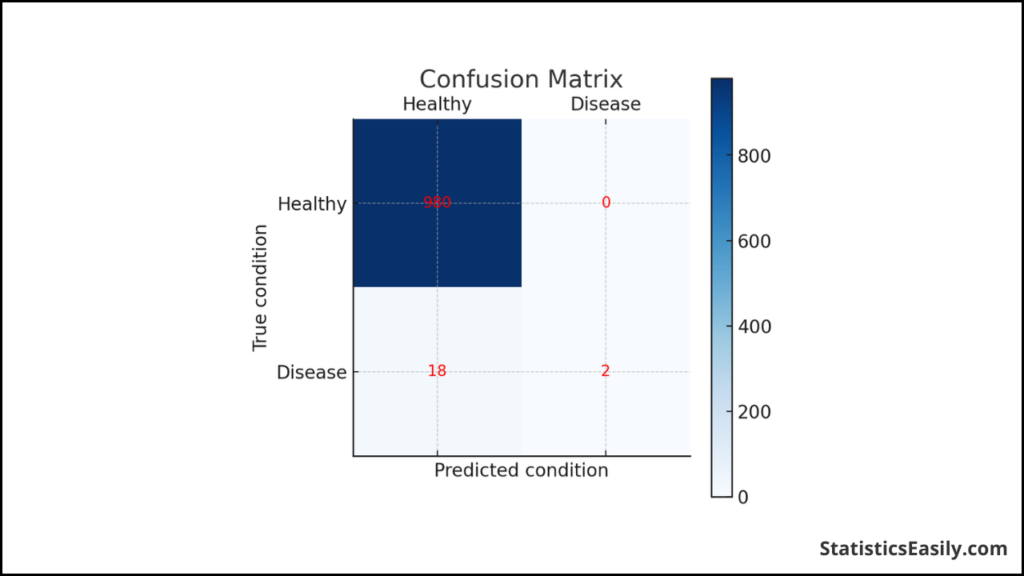
Exactitudeest souvent présentée comme la mesure par excellence de la performance d'un modèle, une preuve apparente de son pouvoir prédictif. Mais révèle-t-elle toute la vérité ? Analysons lamatrice de confusion, un tableau comparant les valeurs réelles et les valeurs prédites, afin de décrypter ce qui se cache derrière les chiffres.
Voici une matrice de confusion hypothétique pour un modèle de prédiction de maladie :
| État réel | Prévu en bonne santé | Maladie prédite |
|---|---|---|
| Sain | 980 | 0 |
| Maladie | 18 | 2 |
| Négatif prévu | Prédit positif | |
|---|---|---|
| Négatif réel | Vrai négatif | false positive |
| Positif réel | Faux négatif | Vrai positif |
À première vue, uneprécisionde 98.2 % peut sembler louable. Pourtant, ce seul indicateur masque une grave réalité. Sur 20 cas avérés de maladie, le modèle n'en a pas identifié 18. Cesfaux négatifsont un coût important : non détectées et non traitées, les personnes malades risquent de voir leur état s'aggraver, ou de propager involontairement la maladie.
Imaginez les conséquences dans un scénario concret : une épidémie de maladie contagieuse où la détection précoce est primordiale. Un modèle avec un tel taux de précision pourrait engendrer une catastrophe sanitaire. Dans ce cas, l’ indicateurprécisionn’est pas seulement trompeur ; il est potentiellement dangereux.
Exactitudenous berce d'illusions, masquant les défaillances critiques aux conséquences potentiellement désastreuses. À elle seule, la précision est insuffisante dans les contextes où le coût d'unfaux négatifest élevé, comme dans le domaine de la santé ou de la cybersécurité. Il nous faut dépasser les simples indicateurs pondérant chaque erreur de classification pour concevoir un modèle qui non seulement prédise, mais protège aussi.
Précision – L’art d’être précis
La précisions'avère un indicateur crucial pour évaluer les performances d'un modèle, notamment lorsque le coût d'un faux positif est élevé. La précision correspond au rapport entre les vrais positifs et le nombre total de positifs prédits ; elle mesure la capacité d'un modèle à identifier uniquement les cas pertinents.
Prenons l'exemple d'un système de détection de spam : un courriel signalé à tort comme spam (faux positif) peut signifier la perte d'une communication cruciale. Dans ce cas, la précision est essentielle pour éviter de telles erreurs coûteuses. Il ne s'agit pas seulement de bloquer tous les spams, mais aussi de garantir qu'aucun courriel légitime ne soit perdu.
La formule deprécisionest une expression simple mais profonde :
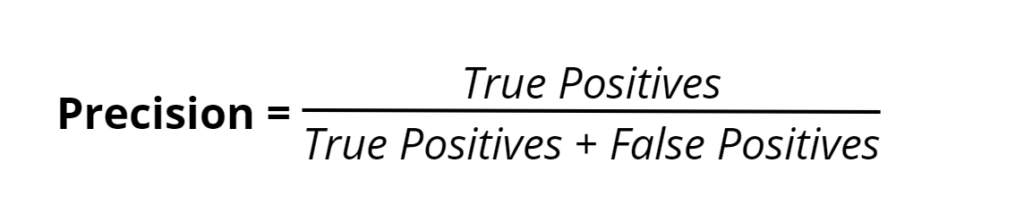
Cela se traduit par la part des cas réellement positifs parmi toutes les instances que le modèle a qualifiées de positives. Dans notre précédent exemple de soins de santé, un modèle de haute précision identifierait correctement les patients atteints de la maladie et minimiserait ceux mal diagnostiqués, maintenant ainsi la confiance dans le processus de diagnostic médical.
Les enjeux sont importants dans des domaines comme la finance, où un faux positif pourrait signifier qu’une transaction légitime est signalée comme frauduleuse. Precision garantit que les transactions quotidiennes ne sont pas entravées, reflétant la capacité du modèle à maintenir l'intégrité opérationnelle et la responsabilité éthique envers les parties prenantes.
Ainsi, tandis queprécisiondonne une vue d'ensemble des performances d'un modèle,précisionen précise les détails, en se concentrant sur la qualité des prédictions positives. Elle témoigne de la capacité d'un modèle non seulement à détecter, mais aussi à discerner, reflétant un engagement envers la vérité et la fiabilité exigées dans la prise de décision à forts enjeux.
Rappel – Assurer une détection complète
Rappelerest essentiel pour une détection exhaustive parmi les indicateurs de performance. Il permet de vérifier non seulement l'exactitude de nos prédictions, mais aussi notre capacité à identifier tous les cas positifs. Le rappel correspond à la proportion d'instances pertinentes effectivement retrouvées parmi l'ensemble des cas pertinents.
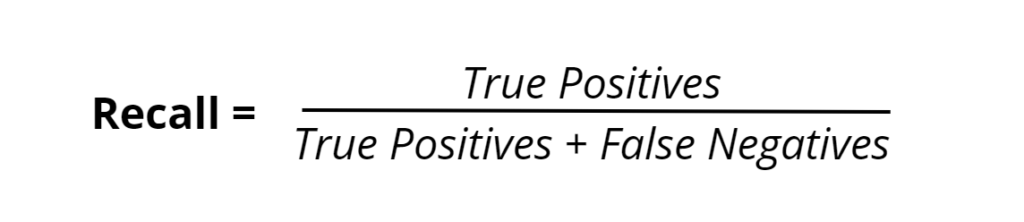
Dans le domaine des soins de santé, le rôle du rappel ne peut être surestimé. Pour des maladies telles que le cancer, le fait de ne pas identifier un cas positif (un faux négatif) pourrait signifier une occasion manquée d’intervention précoce, ce qui peut avoir un impact significatif sur les taux de survie des patients. Ici, un taux de rappel élevé garantit que presque tous les cas de maladie sont identifiés, ce qui est impératif.
De même, en matière de détection des fraudes, le coût de la non-détection d’une transaction frauduleuse est considérable. Même si un faux positif dans ce contexte peut conduire au mécontentement des clients, un faux négatif pourrait entraîner des pertes financières importantes et nuire à la crédibilité institutionnelle. Ainsi, un modèle qui tend vers un rappel plus élevé pourrait être préférable dans de tels domaines, même s’il risque de générer quelques faux positifs supplémentaires.
L’impératif du rappel va au-delà de la précision technique ; cela fait écho à la responsabilité morale de minimiser les dommages. Dans les domaines où le coût de manquer un résultat positif est bien plus élevé que le coût d’en identifier un de manière incorrecte, le rappel devient la mesure du choix éthique. Il s’agit de garantir qu’un système soit aussi inclusif que possible de tous les cas réels, incarnant l’engagement à faire le bien grâce à une détection minutieuse.
Le score F1 – Équilibrer précision et rappel
The F1 Scoreétablit un équilibre harmonieux entre la précision et le rappel, offrant une mesure unique qui englobe ces deux dimensions de la précision d'un modèle. Il est particulièrement utile lorsque l'importance relative des faux positifs et des faux négatifs est cruciale. Le score F1 est défini comme la moyenne harmonique de la précision et du rappel.
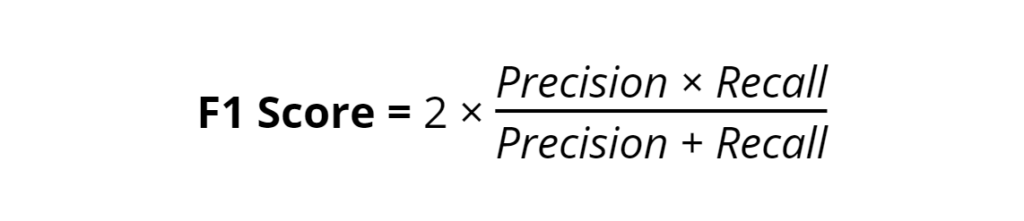
Cette formule garantit que la précision et le rappel contribuent de manière égale au score, pénalisant les valeurs extrêmes lorsque l'une ou l'autre des mesures est trop faible. Le score F1 brille par son utilisation plutôt que par sa précision, en particulier dans les ensembles de données déséquilibrés où une classe est nettement plus nombreuse qu'une autre. Dans de tels cas, la précision à elle seule pourrait suggérer une performance trompeuse en prédisant simplement la classe majoritaire.
Prenons un ensemble de données présentant un grave déséquilibre de classes, comme des transactions frauduleuses dans un vaste ensemble de données d'activités financières. Un modèle peut être très précis en prédisant rarement la fraude, mais en manquant la plupart des transactions frauduleuses en raison de leur rareté. Ici, un score F1 élevé indiquerait non seulement que le modèle capture la plupart des cas de fraude (rappel élevé), mais également qu'il ne signale pas trop les transactions légitimes comme étant des fraudes (haute précision).
Essentiellement, le score F1 transcende la simplicité de l'exactitude en intégrant la profondeur de la précision et l'étendue du rappel, nous guidant ainsi vers une évaluation plus équilibrée et nuancée des performances du modèle. Cela nécessite un modèle non seulement pour identifier ou exclure, mais pour faire les deux judicieusement dans la recherche d'une représentation plus véridique de la réalité dans nos décisions fondées sur les données.
Analyse comparative de toutes les mesures
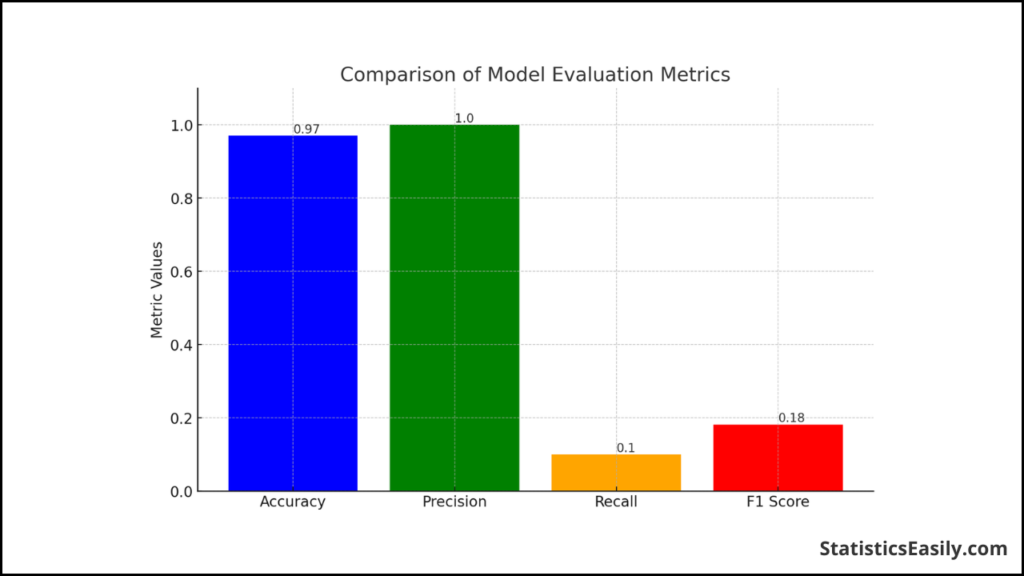
En analyse de données, l'évaluation d'un modèle se résume souvent à quatre indicateurs clés :l'exactitude, la précision, le rappelet leF1 Score. Chacun de ces indicateurs offre une perspective unique sur la performance du modèle, et comprendre leurs interactions est essentiel pour choisir le plus approprié en fonction du problème métier spécifique à résoudre.
Le tracer à barres suivant illustre les différences entre ces quatre indicateurs sur la base d'un modèle hypothétique de prédiction de la maladie :
| État réel | Prévu en bonne santé | Maladie prédite |
|---|---|---|
| Sain | 980 | 0 |
| Maladie | 18 | 2 |
Voici une répartition des performances du modèle selon différentes métriques :
- Exactitude: 97 % – Bien qu'élevé, ce chiffre ne tient pas compte de la gravité des faux négatifs de notre ensemble de données.
- La précision: 100 % – Toutes les prédictions positives du modèle sont correctes, mais cela ne prend pas en compte le nombre de vrais positifs manqués.
- Rappeler: 10 % – Ce faible score indique que le modèle ne parvient pas à identifier 90 % des cas positifs réels, un défaut critique dans des contextes spécifiques tels que le diagnostic de maladies.
- F1 Score: Environ 0.18 – Ce score équilibre précision et rappel, mais dans ce cas, il penche vers la précision en raison du très faible rappel.
Lors du choix d’une mesure, il faut tenir compte des implications commerciales des faux positifs et des faux négatifs. Dans des scénarios tels que les soins de santé, un rappel élevé est essentiel pour garantir que tous les cas de maladie sont identifiés malgré le risque de faux positifs. En revanche, la précision peut être plus importante dans des scénarios tels que la détection du spam, où les faux positifs (e-mails légitimes marqués comme spam) peuvent être très perturbateurs.
The F1 Scoreest particulièrement pertinent lorsqu'une seule mesure permet d'équilibrer précision et rappel. Il est notamment utile pour les jeux de données déséquilibrés, où la surreprésentation d'une classe peut fausser l'exactitude.
En résumé, si l'exactitude fournit une idée générale des performances du modèle, la précision, le rappel et le score F1 offrent une vue plus nuancée qui peut être adaptée aux besoins spécifiques d'un problème. Le déploiement d'un modèle doit être guidé par une mesure qui correspond à l'objectif ultime : sauvegarder la santé humaine ou protéger les actifs financiers, intégrant ainsi à la fois la rigueur scientifique et les impératifs éthiques des applications du monde réel.
Conclusion
Au fil de notre exploration des subtilités des métriques d'évaluation des modèles, l'importance de comprendre les attributs et applications spécifiques de chaque métrique devient évidente.L'exactitude, la précision, le rappelet lescore F1mettent en lumière différentes facettes de la performance d'un modèle, offrant des informations précieuses pour affiner nos outils prédictifs.
Exactitudeoffre une vue d'ensemble, mais elle ne rend pas toujours compte des subtilités de la performance du modèle, notamment en cas de déséquilibre des classes.La précisionmet en évidence la capacité du modèle à minimiser les faux positifs, ce qui est crucial lorsque le coût de l'étiquetage erroné d'un cas est élevé. D'autre part,recall , quant à lui, garantit que le modèle détecte le plus grand nombre possible de vrais positifs, un point essentiel dans des domaines comme la santé et la détection de la fraude, où manquer un cas positif peut avoir des conséquences désastreuses. Lescore F1harmonise la précision et le rappel, offrant une mesure équilibrée particulièrement utile lorsque les faux positifs et les faux négatifs ont un impact significatif.
La « meilleure » sélection de mesures dépend intrinsèquement du contexte, soulignée par les exigences spécifiques et les implications du problème en question. Par exemple, le rappel peut avoir la priorité dans un scénario de diagnostic médical pour garantir qu’aucune condition ne passe inaperçue. En revanche, la précision peut être plus critique dans la détection du spam par courrier électronique afin d'éviter une mauvaise classification des messages essentiels.
En conclusion, une approche réfléchie et perspicace de la sélection des paramètres est primordiale. Cela nécessite un alignement avec les impératifs éthiques et les réalités pratiques de chaque application, garantissant que nos modèles non seulement prédisent avec précision, mais le font d'une manière qui respecte les valeurs de vérité. Cet engagement en faveur d'une science des données fondée sur des principes nous permet d'exploiter tout le potentiel de nos modèles, en faisant progresser des innovations qui sont non seulement techniquement compétentes, mais également éthiquement saines et contextuellement pertinentes.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Articles recommandés
Approfondissez l’exactitude des données et l’évaluation des modèles – découvrez plus d’articles sur ces sujets essentiels sur notre blog.
- 10 techniques révolutionnaires pour maîtriser l'analyse des données
- 5 études de cas statistiques qui vous épateront
- Comment les statistiques peuvent changer votre vie : un guide pour les débutants
Foire Aux Questions (FAQ)
Q1 : Qu’est-ce que la précision dans l’évaluation d’un modèle ?La précision est la proportion de résultats corrects (vrais positifs et vrais négatifs) parmi le nombre total de cas examinés.
Q2 : Pourquoi la précision est-elle nécessaire dans les modèles prédictifs ?La précision est cruciale lorsque le coût d’un faux positif est élevé, comme dans la détection des spams, où des courriels valides pourraient être filtrés par erreur.
Q3 : Quand le rappel est-il la mesure privilégiée ?Le rappel doit être privilégié dans les scénarios où le fait de manquer un résultat positif est préjudiciable, comme dans le diagnostic de maladies graves.
Q4 : Comment le score F1 aide-t-il à évaluer un modèle ?Le score F1 équilibre la précision et le rappel, ce qui est particulièrement utile lorsqu’il s’agit d’ensembles de données déséquilibrés.
Q5 : Un modèle très précis peut-il néanmoins présenter des défauts ?Oui, un modèle peut être très précis tout en ne parvenant pas à identifier les cas positifs, ce qui le rend inefficace dans certaines applications.
Q6 : Vaut-il mieux privilégier la précision ou le rappel ?Le choix entre précision ou rappel dépend de l’application spécifique et des conséquences des faux positifs ou des faux négatifs.
Q7 : Quelle est la différence entre exactitude et précision ?L’exactitude désigne la proximité des mesures à une valeur de référence. En revanche, la précision désigne la proximité des mesures entre elles.
Q8 : Le score F1 peut-il être équivalent à la précision ?Le score F1 peut parfois être similaire à la précision. Cependant, il s’agit de mesures distinctes qui peuvent diverger selon l’équilibre de l’ensemble de données.
Q9 : Comment calcule-t-on le score F1 ?Le score F1 est la moyenne harmonique de la précision et du rappel, calculée comme 2 * (précision * rappel) / (précision + rappel).
Q10 : Pourquoi la précision n’est-elle pas toujours la meilleure mesure pour un modèle de classification ?La précision peut ne pas être optimale pour les ensembles de données déséquilibrés où une classe est nettement plus nombreuse que l’autre, car la classe majoritaire peut biaiser le résultat.