


L'avantage SQL pour les requêtes de données
Ce guide montre aux analystes et scientifiques des données comment les principes fondamentaux du SQL peuvent permettre de construire des pipelines de données plus rapides, plus robustes et plus faciles à maintenir que les scripts Python à usage général.
Introduction : Le coût caché du « simple survol »
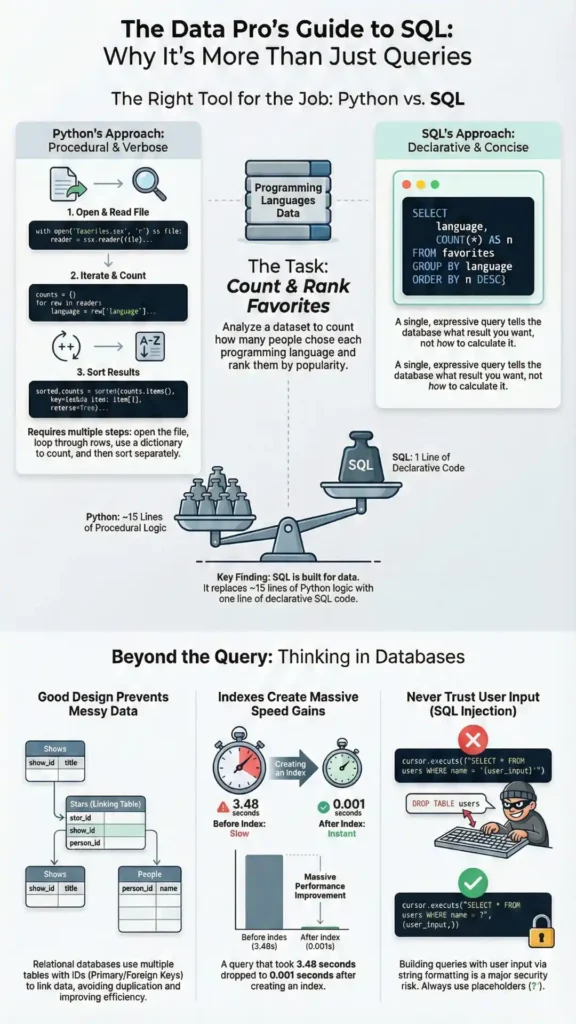
Pour de nombreux professionnels des données, l'approche par défaut face à un nouveau fichier CSV consiste à écrire un script Python. On ouvre le fichier, on parcourt les lignes et on construit manuellement des compteurs ou des listes pour répondre à des questions qui semblent simples. Bien que cette méthode fonctionne, elle aboutit souvent à un code lent, fragile et difficile à maintenir. Quelques colonnes réorganisées dans le fichier source peuvent suffire à faire planter tout le script. Répondre à une question légèrement différente implique de réécrire des boucles et des conditions complexes. Cette approche impérative et séquentielle masque une méthode de travail avec les données plus puissante, élégante et efficace. En adoptant un langage spécialisé, on peut exprimer plus facilement des questions complexes et remplacer 17 lignes de Python fragiles par une seule ligne de SQL déclarative.
Point clé n° 1 : Renforcez votre processus d’ingestion de données
L'une des vulnérabilités les plus courantes dans un script de données Python simple est l'accès aux colonnes CSV par leur index numérique, comme row[1]. This code is fragile because it makes a hard-coded assumption about the data’s structure. If a colleague opens the source spreadsheet and moves the second column to the third position, the script will either crash or, worse, silently produce incorrect results by processing the wrong data.
Une solution plus robuste consiste à utiliser les fonctions intégrées de Python. csv.DictReader. Instead of treating each row as a list of values, DictReader treats it as a dictionary where the keys are the column headers from the first row of the file. This allows you to access data by its meaningful name (e.g., row['language']), not its arbitrary position. The code will now work correctly even if the columns are reordered, as long as the header names remain the same.
Lien avec la science des données : Cette pratique rend les pipelines d’ingestion de données beaucoup plus résilients aux modifications des fichiers sources. Elle réduit les bogues inattendus, minimise la maintenance et garantit que les résultats analytiques sont basés sur les colonnes de données appropriées, améliorant ainsi la fiabilité de l’ensemble du flux de travail.
Deuxième point à retenir : le changement de mentalité déclarative
Une différence fondamentale entre Python et SQL réside dans le paradigme de programmation qu'ils préconisent. Python est principalement impératif—vous le dites à l'ordinateur comment pour obtenir une réponse étape par étape. Pour compter les langages de programmation favoris à partir d'un fichier CSV, l'approche Python consiste à initialiser des variables de compteur, ouvrir un fichier, parcourir chaque ligne et utiliser if/elif statements to increment the correct counter. This process, which can take around 17 lines of code, is verbose and details a specific procedure.
SQL, en revanche, est déclaratif—vous déclarez est ce que nous faisons La réponse que vous souhaitez, le moteur de base de données détermine la méthode la plus efficace pour l'obtenir. En SQL, cette même opération de comptage se résume à une seule instruction : SELECT language, COUNT(*) FROM favorites GROUP BY language;. This query doesn’t specify loops or conditionals; it simply states the desired result: a count of entries for each language. This shift from describing a process to describing an outcome is a powerful mental leap.
Lien avec la science des données : La pensée déclarative permet aux analystes d’exprimer des questions complexes sur les données de manière plus directe et avec moins de risques d’erreurs logiques. Au lieu de construire des boucles procédurales complexes, vous pouvez vous concentrer sur la définition des données nécessaires, ce qui permet d’obtenir des requêtes plus claires, plus lisibles et plus précises.
« …on dirait qu’on passe un temps fou à développer tout ça alors qu’il serait bien de pouvoir simplifier ce code… Ce serait bien de pouvoir répondre à cette question très rapidement… » — Harvard CS50x 2025 (YouTube) — Cours : SQL
Point clé n° 3 : Une bonne structure des données n’est pas le fruit du hasard.
La structure de vos données a un impact considérable sur votre capacité à les analyser correctement et efficacement. Une erreur fréquente, illustrée par un tableur utilisé dans la série télévisée « The Office », consiste à mal organiser les données connexes. Une mauvaise conception consiste à ajouter une nouvelle colonne pour chaque acteur (star1, star2, etc.), which is inflexible and doesn’t scale. Another flawed approach is to have a row for each star, repeating the show’s title (“The Office”) over and over again, creating massive data redundancy.
La solution repose sur un concept de base de données appelé normalisationAu lieu d'un seul tableau confus, vous répartissez les données dans des tableaux distincts pour chaque entité. Par exemple, vous créez un tableau… shows table for TV shows and a people table for actors. You then create a third “join table,” stars, that links them together using their unique IDs (show_id et person_id).
Cette conception élimine les redondances en remplaçant les longues chaînes de caractères de longueur variable, comme « The Office », par de petits entiers de taille fixe (par exemple, un identifiant de 32 ou 64 bits). Cette approche permet de gagner beaucoup d’espace et d’améliorer les performances.
Lien avec la science des données : La normalisation offre un cadre de référence essentiel pour le nettoyage et la structuration des données. Identifier et corriger les redondances dans les ensembles de données complexes (comme les feuilles de calcul) permet de prévenir les erreurs d'analyse et garantit l'exactitude des résultats des agrégations et des jointures. Il s'agit d'une étape fondamentale pour préparer les données à une analyse fiable.
Quatrième point à retenir : La solution de performance en une seule ligne
La lenteur des requêtes constitue un goulot d'étranglement majeur dans l'analyse des données, en particulier sur les grands ensembles de données présentant des relations complexes. Par exemple, une requête joignant trois tables pour trouver toutes les séries télévisées de Steve Carell a mis 3.483 secondes à s'exécuter, un temps « exaspérant » jugé trop long lors du cours. Ce délai est dû au fait que, sans instruction préalable, la base de données effectue une recherche linéaire, vérifiant chaque ligne d'une table pour trouver des correspondances.
La solution consiste à créer un INDEX on the column being searched. An index is a special data structure, much like the index at the back of a book, that allows the database to find specific rows almost instantly without scanning the entire table. By running a command like CREATE INDEX name_index ON people (name), you instruct the database to build an efficient lookup structure (typically a B-tree). In the lecture’s example, creating two indexes reduced a query for Steve Carell’s shows from 0.215 seconds to just 0.001 seconds—a massive performance gain.
En contrepartie, les index consomment plus d'espace de stockage et peuvent légèrement ralentir les opérations d'écriture (INSERT, UPDATE, DELETE), as the index must also be updated. However, for read-heavy analytical workloads, the benefit to SELECT speed is almost always worth it.
Lien avec la science des données : Comprendre les index offre aux spécialistes des données un outil simple et très efficace pour lutter contre les goulots d’étranglement en matière de performances. Face à des requêtes lentes sur de grands ensembles de données, la création d’un index sur les colonnes filtrées constitue souvent la première et la plus efficace des mesures d’optimisation.
Cinquième point à retenir : cessez de vous fier aux données saisies par les utilisateurs.
L'insertion directe de données utilisateur dans une chaîne de caractères lors de la construction de requêtes, par exemple avec les f-strings de Python, crée une grave faille de sécurité appelée attaque par injection SQL. Ce type d'attaque se produit lorsqu'un utilisateur malveillant fournit des données qui sont exécutées directement dans la commande SQL.
L'exemple classique concerne un formulaire de connexion. Si le code construit une requête comme f"SELECT * FROM users WHERE username = '{username}'", a user could enter a username of admin' --. The single quote closes the string, and the -- starts a SQL comment, causing the rest of the original query (including the password check) to be ignored. The database is tricked into logging the user in as ‘admin’ without a valid password. This is famously alluded to in the “Little Bobby Tables” webcomic.
La solution est de toujours utilisé requêtes paramétréesAu lieu d'utiliser des f-strings, vous utilisez un espace réservé (comme ?) in your SQL string. You then provide the user’s input as a separate argument. The database library ensures that the input is treated strictly as data and never as executable code, completely preventing SQL injection attacks.
Lien avec la science des données : Il s’agit d’une pratique de sécurité essentielle pour toute personne développant des applications de données interactives, des tableaux de bord ou tout outil interrogeant une base de données en fonction de filtres ou d’entrées fournis par l’utilisateur. Ne pas paramétrer les requêtes expose vos données et vos systèmes à des risques importants.
Que postuler aujourd'hui
- Lors de la lecture d'un fichier CSV en Python, utilisez
csv.DictReaderinstead of accessing columns by number. - Avant d'écrire une boucle Python pour agréger des données, demandez-vous : « Pourrait-il s'agir d'une seule boucle ? »
GROUP BYquery in SQL?” - Si vous constatez qu'une même valeur textuelle se répète plusieurs fois dans une feuille de calcul, envisagez de scinder les données en deux tables liées par un identifiant unique.
- Si un
SELECTquery with aWHEREclause is slow, create anINDEXon the column(s) in theWHEREclause. - N’utilisez jamais de chaînes de caractères complexes (f-strings) ni la concaténation de chaînes pour ajouter des données saisies par l’utilisateur à une requête SQL. Utilisez toujours des espaces réservés.
Fermeture
Bien qu'il soit tentant d'utiliser un langage généraliste comme Python pour chaque tâche, ce cours CS50 démontre que les concepts fondamentaux de l'informatique offrent des avantages pratiques considérables pour le traitement des données. Ce cours fait partie d'une série complète qui montre comment les notions fondamentales d'informatique améliorent directement la qualité et l'efficacité de l'analyse des données. En tirant parti de la nature déclarative du SQL, de ses principes de modélisation des données rigoureux et de ses fonctionnalités performantes, les spécialistes des données peuvent écrire du code non seulement plus rapide, mais aussi plus robuste et plus facile à comprendre.
Quelle est une tâche de données courante que vous effectuez en Python et qui pourrait être remplacée par une simple requête SQL déclarative ? requête à la place ?





