


Leçons d'informatique sur le fonctionnement réel de l'IA
Pour les analystes de données et les scientifiques, cette analyse d'un cours d'informatique de Harvard transforme la théorie informatique en sagesse pratique pour votre travail quotidien.
Introduction : Le coût caché du « ça marche tout simplement »
Avez-vous déjà peiné à déboguer les résultats étranges d'un modèle ou à expliquer une prédiction opaque à un partenaire ? En science des données, nous utilisons souvent des outils puissants qui semblent fonctionner sans problème… jusqu'à ce qu'ils dysfonctionnent. La frustration engendrée par des résultats inattendus provient souvent d'un décalage entre l'utilisation d'un outil et la compréhension de ses principes fondamentaux. En abordant les problèmes de données modernes sous l'angle de l'informatique fondamentale, nous pouvons passer d'une simple utilisation des outils à une maîtrise assurée et précise. Cet article est une synthèse de la conférence CS50x 2025 (Harvard) sur l'intelligence artificielle, disponible sur YouTube. Il en dégage cinq points clés concrets qui relient la théorie informatique aux réalités pratiques du travail sur les données, vous offrant ainsi des concepts à fort impact que vous pouvez appliquer immédiatement.
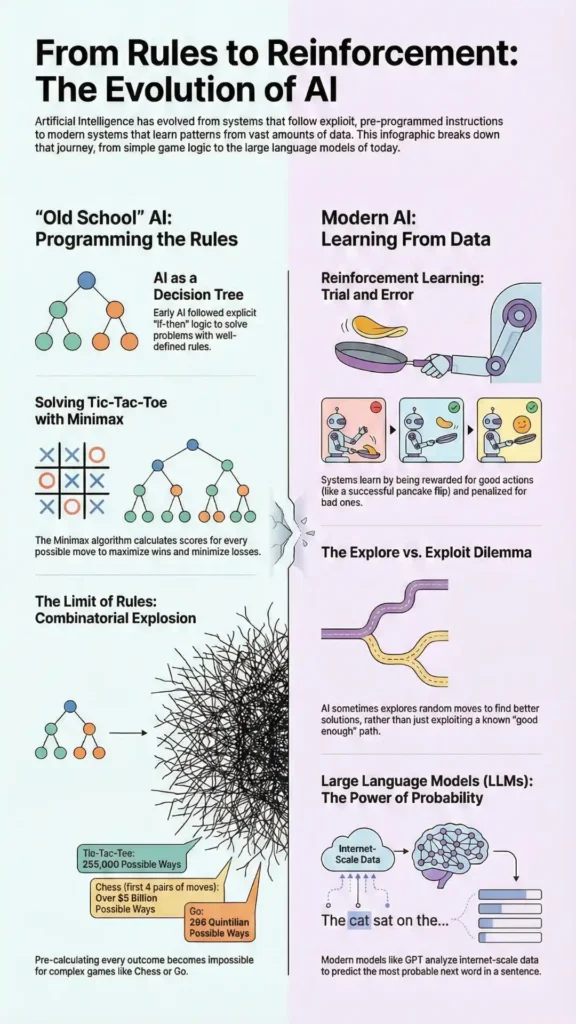
Point clé n°1 : L’IA est un spectre allant de règles simples à des probabilités complexes.
L'intelligence artificielle n'est pas un bloc monolithique ; c'est un spectre. À une extrémité, on trouve des systèmes simples et déterministes. Le cours utilise le jeu du Tic-Tac-Toe comme exemple classique. Une « IA » pour ce jeu peut être construite à l'aide d'un arbre de décision—une série de if-else rules—and an algorithm called MinimaxL'algorithme attribue un score aux états de l'échiquier (par exemple, +1 pour une victoire, -1 pour une défaite, 0 pour une égalité) et remonte le temps pour choisir le coup qui lui offre le meilleur résultat possible. Cette approche exhaustive garantit une victoire ou une égalité. Cependant, cette logique basée sur des règles n'est applicable que dans des environnements très contraints. Comme le souligne le cours, dans un jeu plus complexe comme les échecs, il existe plus de 85 milliards de façons de jouer les quatre premières paires de coups, ce qui rend la construction d'un arbre de décision complet impossible en pratique.
À l'autre extrémité du spectre se trouvent les systèmes probabilistes modernes, tels que les grands modèles de langage (LLM). Ces modèles ne suivent pas de règles explicites. Au contraire, comme l'explique le cours, ils fonctionnent en prédisant le mot suivant le plus probable dans une séquence, en se basant sur les nombreux schémas et fréquences appris grâce à leurs données d'entraînement. Ils fonctionnent avec des probabilités, et non avec des certitudes.
Lien avec la science des données : Ce spectre correspond directement aux approches courantes en science des données. Écrire des règles métier explicites en SQL, comme par exemple : CASE WHEN ... THEN, is like building a decision tree. In contrast, training a statistical model that assigns probabilities to different outcomes is working on the other end of the spectrum. Understanding where your specific business problem falls on this continuum—from needing deterministic rules to benefiting from probabilistic inference—is crucial for choosing the right tool for the job.
Deuxième point à retenir : « L’ingénierie des prompts » n’est rien d’autre qu’un contexte structuré
La compétence tant vantée de « l'ingénierie des invites » repose moins sur des commandes ésotériques que sur la fourniture d'un contexte structuré. Ce cours démystifie ce concept en utilisant l'assistant IA « canard en caoutchouc » du cours CS50 comme exemple parfait. Une invite comporte deux parties essentielles : l' invite système et le invite utilisateur. L'invite utilisateur est simplement la question posée par une personne. L'invite système, rédigée par le développeur, est un ensemble d'instructions qui indiquent à l'IA comment se comporter et quelles contraintes respecter.
L'équipe CS50 a fourni à son canard virtuel des instructions système très précises afin de modeler son comportement, d'un assistant d'apprentissage générique à un assistant pédagogique utile, mais non tricheur. Ces instructions comprenaient des commandes directes telles que :
« Vous êtes un assistant pédagogique amical et serviable pour le cours CS50. »
« Toi aussi, tu es un canard en caoutchouc. »
« Ne fournissez pas de réponses complètes aux problèmes posés, car cela constituerait une violation de l’intégrité académique. »
Ces instructions fournissent le contexte nécessaire à l'IA pour générer une réponse utile, spécifique au domaine et sûre, plutôt qu'une simple réponse par défaut.
Lien avec la science des données : Cela revient à définir le périmètre et les contraintes de tout projet d’analyse de données. Une bonne consigne d’analyse n’est pas destinée à une IA, mais à vous-même et à vos parties prenantes. Elle peut inclure la définition des termes clés (« Qu’est-ce qu’un utilisateur actif ? »), la spécification de la période ou l’énoncé de la question métier principale à laquelle vous cherchez à répondre. Ce cadrage initial évite les efforts inutiles et les erreurs d’interprétation, et garantit la pertinence et l’exactitude de l’analyse finale.
Point clé n° 3 : Le compromis crucial : exploration contre exploitation
L'un des concepts les plus importants en intelligence artificielle est le dilemme entre exploration et exploitation. La conférence l'illustre par un jeu de labyrinthe simple où un agent IA doit trouver une sortie verte tout en évitant les fosses de lave. Au départ, l'agent trouve a bon chemin par hasard et, grâce au renforcement, apprend à le suivre de manière répétée. C'est l'exploitation: utiliser des informations connues pour obtenir un résultat fiable.
Cependant, ce premier chemin n'est peut-être pas le meilleur . Pour trouver un itinéraire plus court et optimal, l'IA doit introduire une petite part d'aléatoire, définie dans le cours comme une « valeur epsilon », qui représente une probabilité fixe (par exemple, 5 % ou 10 %) que l'agent effectue un mouvement aléatoire au lieu du meilleur mouvement appris. Cela encourage l'exploration: tenter de nouveaux mouvements aléatoires, même au risque d'un échec à court terme, comme tomber dans un trou de lave. Avec le temps, cette petite marge d'exploration permet à l'IA de découvrir des stratégies supérieures.
Ce principe a été brillamment illustré par l'exemple d'une IA apprenant à jouer à Breakout. En se contentant d'exploiter les failles du jeu, l'IA aurait simplement déplacé la raquette d'avant en arrière. Mais en explorant, elle a découvert la stratégie contre-intuitive, mais extrêmement efficace, consistant à faire remonter la balle d'un côté, permettant ainsi au jeu de se dérouler quasiment tout seul et d'accumuler un score impressionnant.
Lien avec la science des données : Ce compromis est fondamental en science des données. Les tests A/B en sont une illustration concrète : on continue d’utiliser la solution qui a fait ses preuves (exploitation) tout en testant une nouvelle variante pour voir si elle est meilleure (exploration). Ce principe s’applique à l’optimisation des modèles, où l’on peut essayer de nouveaux hyperparamètres au lieu de se contenter de ceux qui fonctionnent déjà bien. Il s’applique même au développement de carrière : faut-il privilégier les outils que l’on maîtrise (exploitation) ou prendre le temps d’apprendre un nouveau langage ou framework potentiellement plus performant (exploration) ?
Quatrième point à retenir : les titulaires d’un LLM sont d’excellents détecteurs de schémas, et non des penseurs abstraits.
D'après la conférence, les modèles de langage à grande échelle (LLM) ne raisonnent pas au sens humain du terme. Ce sont des systèmes de reconnaissance de formes extrêmement sophistiqués. Basés sur des réseaux neuronaux, les LLM sont pré-entraînés sur d'immenses quantités de textes provenant d'Internet. Leur fonction principale est de calculer le mot suivant le plus probable dans une séquence, en fonction des mots précédents.
La conférence l'explique simplement : « …si quelqu'un me demande comment ça va, en me basant sur toutes ces données, je parie que dans 99 % des cas, je réponds par un simple "bien, merci, et vous ?", comme si je discutais avec PT ou le canard de cs50. » Le modèle ne se sent pas bien ; il génère simplement la réponse statistiquement la plus probable à partir de ses données d'entraînement.
Cette nature probabiliste est la cause directe des hallucinations. Lorsqu'un modèle linéaire à longue portée (MLP) affirme avec assurance une chose factuellement incorrecte, c'est parce que les schémas de ses données d'entraînement suggèrent que l'énoncé incorrect est une suite de mots qui semble plausible. Il construit une phrase statistiquement probable, et non vérifie un fait.
Lien avec la science des données : Ceci a des implications majeures pour les professionnels des données. Les résultats d’un modèle linéaire ne doivent jamais être considérés comme des vérités absolues. Il s’agit plutôt d’hypothèses bien formulées qui nécessitent une vérification auprès de sources primaires. Cette approche critique est essentielle pour garantir la rigueur analytique. Utiliser les résultats d’un modèle linéaire sans validation risque de propager des informations erronées dans vos rapports, tableaux de bord et modèles, et de nuire à la confiance accordée à votre travail.
Cinquième point clé : une véritable solution d’IA est un système, et non un simple modèle.
Un outil d'IA performant est rarement un simple modèle isolé. Il s'agit d'un système complet construit autour de ce modèle. Le cours présente un schéma architectural du débogueur « duck » du projet CS50 qui illustre parfaitement ce point. L'équipe CS50 n'a pas conçu son propre LLM de A à Z. Elle a plutôt créé un outil précieux en intégrant plusieurs composants clés.
Le système comprend une interface conviviale pour les étudiants, une base de données Vector locale permettant de stocker et de rechercher le contenu des cours transcrits, ainsi que des connexions à utilisé pour stocker et rechercher le contenu des cours transcrits, et des connexions à des tiers des API tierces de fournisseurs tels qu'OpenAI. La principale réussite de l'équipe ne réside pas dans la création d'un nouveau modèle fondamental, mais dans l'assemblage de ces éléments au sein d'un système qui résout efficacement un problème pédagogique spécifique.
Lien avec la science des données : C’est une leçon essentielle pour les data scientists, qui exige un changement de mentalité : passer de « Je crée des modèles » à « Je conçois des solutions axées sur les données ». La véritable valeur ajoutée pour l’entreprise réside rarement dans un modèle isolé, aussi complexe soit-il. Elle se trouve dans le système : les pipelines de données qui alimentent le modèle, les API qui fournissent ses prédictions et les interfaces qui le rendent utilisable. Penser comme un architecte signifie passer de l’optimisation d’un algorithme à la conception d’un système complet, capable de résoudre des problèmes.
Que postuler aujourd'hui
- Rédigez une « invite système » pour votre prochain projet : Avant d'écrire la moindre ligne de code, rédigez un paragraphe définissant vos objectifs, vos contraintes et les définitions clés, à l'instar de l'énoncé du canard CS50.
- Distinguer l'exploration de l'exploitation : Dans votre travail actuel, trouvez un domaine où vous exploitez un processus connu. Demandez-vous à quoi pourrait ressembler une petite expérience exploratoire.
- Transformer un problème en arbre de décision : Un tableau blanc représente un problème commercial simple en utilisant
if-then-elselogic of a decision tree. Does this clarify the logic? - Vérifiez, ne faites pas confiance : Considérez la prochaine information fournie par une IA générative comme une hypothèse. Consacrez trois minutes à tenter de la vérifier auprès d'une source primaire.
- Penser en termes de systèmes : Lors de la conception d'un modèle, dessinez un schéma simple des entrées nécessaires et des sorties produites. Comment une personne ou un autre système pourrait-il l'utiliser ?
Conclusion : Du code à la cognition
Comprendre les principes fondamentaux de l'informatique qui sous-tendent l'IA ne se contente pas de démystifier la technologie ; cela offre un cadre propice à la maîtrise, à la clarté et à l'esprit critique. Des concepts tels que les arbres de décision, le raisonnement probabiliste et le compromis exploration/exploitation ne sont pas des théories abstraites, mais des outils pratiques pour concevoir des solutions de données plus robustes et fiables. Ces idées constituent le socle sur lequel s'appuie une compréhension plus approfondie de sujets encore plus avancés. À mesure que ces systèmes probabilistes s'intègrent davantage à nos outils, comment devrons-nous adapter nos propres méthodes pour garantir la véracité des analyses ?



