


Structures de données : Guide du data scientist
Cet article aide les spécialistes des données à comprendre les structures de données fondamentales afin d'écrire un code plus rapide et plus économe en mémoire.
Un goulot d'étranglement fréquent dans les scripts de traitement de données, qu'il s'agisse de boucles d'ingénierie des caractéristiques lentes ou de recherches inefficaces, provient souvent d'une inadéquation entre la tâche et la structure de données sous-jacente. La cause profonde de ces problèmes de performance réside souvent non pas dans la logique du code, mais dans l'organisation des données en mémoire. Comprendre ces structures – et leurs compromis – est une compétence fondamentale pour concevoir des pipelines d'analyse efficaces et évolutifs. Cet article reprend les principaux enseignements sur les structures de données du célèbre cours CS50x de Harvard, en reliant ces fondamentaux de l'informatique au monde pratique de l'analyse et de la science des données.
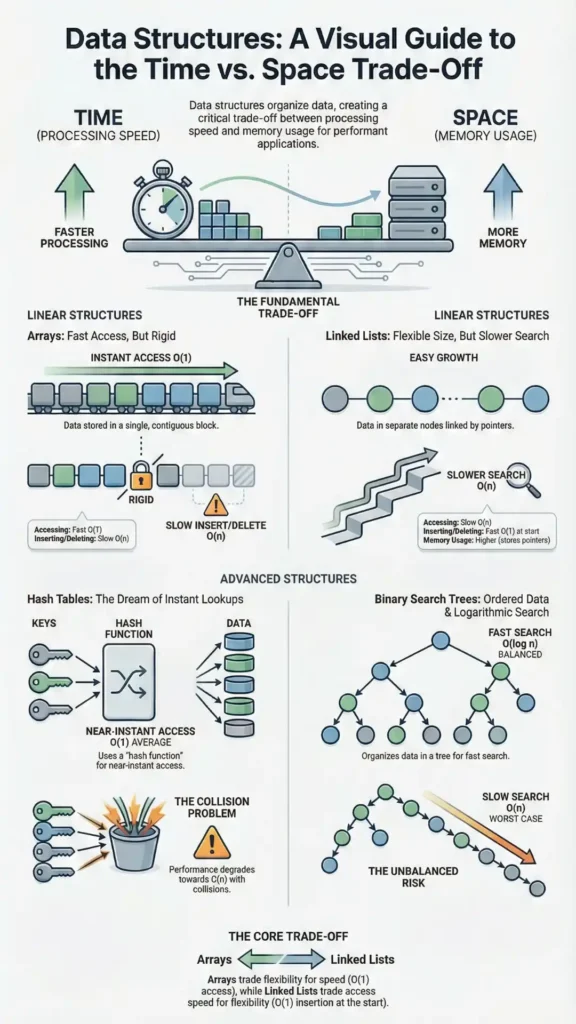
1. Les tableaux et leur coût caché de redimensionnement
Un tableau est une structure de données simple où les éléments de même type sont stockés les uns à la suite des autres (« contigus ») en mémoire. Cette disposition contiguë permet d'accéder très rapidement à n'importe quel élément par son index. Cependant, les tableaux présentent une limitation importante : leur taille doit être définie à l'avance.
Que se passe-t-il lorsqu'il faut agrandir un tableau déjà plein ? Impossible d'ajouter un nouvel élément à la fin si l'emplacement mémoire est déjà occupé. La seule solution consiste à allouer un nouveau bloc de mémoire plus grand, à copier manuellement chaque élément de l'ancien tableau vers le nouveau, puis à libérer la mémoire utilisée par le tableau d'origine. Ce processus de copie est une opération longue, de complexité linéaire : plus le tableau est grand, plus l'opération est longue.
Connexion à la science des données
De nombreux outils de données courants, comme les listes Python, se comportent comme des « tableaux dynamiques ». Bien qu'ils semblent s'agrandir automatiquement, ce redimensionnement coûteux est effectué en interne. Pour accélérer l'ajout d'éléments, les listes Python utilisent la surallocation(réservation d'espace supplémentaire), ce qui permet d'obtenir un temps d'exécution constant amorti (O(1) amorti) pour les ajouts. Cependant, l'insertion d'un élément au début d'une grande liste est lente, non seulement à cause du redimensionnement potentiel, mais aussi parce qu'elle nécessite de décaler chaque élément suivant d'une position vers la droite, un coût direct en O(n).
2. Listes chaînées : troquer la mémoire contiguë contre de la flexibilité
Une liste chaînée offre une solution au problème de redimensionnement rigide des tableaux. Au lieu de stocker les éléments de manière contiguë, une liste chaînée est constituée d'une série de « nœuds » pouvant être placés n'importe où en mémoire. Chaque nœud contient deux éléments : une donnée et un « pointeur » (une adresse) qui renvoie vers l'emplacement du nœud suivant. Cela permet d'assembler les emplacements mémoire disponibles selon les besoins.
Cette structure introduit un compromis majeur :
- Upside: La liste peut s'agrandir et se réduire dynamiquement sans qu'il soit nécessaire de déplacer tous les éléments existants. Cela permet une utilisation plus efficace de la mémoire fragmentée.
- Inconvénient: Au total, cela utilise plus de mémoire, car chaque élément nécessite un pointeur supplémentaire pour stocker l'adresse du suivant.
- Inconvénient majeur : Vous perdez la possibilité d'effectuer une recherche binaire rapide. Les éléments n'étant pas stockés de manière contiguë, vous ne pouvez pas accéder instantanément au milieu de la liste ; vous devez la parcourir nœud par nœud depuis le début.
Connexion à la science des données
Prenons l'exemple d'un journal d'événements en temps réel où des événements peuvent devoir être insérés ou supprimés au milieu d'une séquence en fonction des mises à jour. Un exemple standard de Python list would be punishingly slow for this, as each operation could require shifting many elements. A structure like Python’s collections.deque, however, is implemented using a doubly-linked list, providing fast O(1) appends and pops from tous les deux extrémités.
3. La vérité contre-intuitive : la liste la plus rapide est construite à l’envers
Lorsqu'on manipule une liste chaînée, la manière d'y ajouter des éléments a un impact considérable sur les performances. Pour insérer un nouveau nœud au début de la liste (ajout en préfixe), il suffit de créer ce nœud et de mettre à jour quelques pointeurs en tête de liste. Cette opération est indépendante de la taille totale de la liste.
L'ajout d'un élément en début de liste est donc une opération en temps constant (O(1)) , c'est-à-dire extrêmement rapide. En revanche, pour ajouter un nouveau nœud à la fin de la liste (ajout en fin de liste), il faut d'abord parcourir toute la liste depuis le début pour trouver le dernier nœud. L'ajout en fin de liste est donc une opération linear time (O(n)) , qui devient progressivement plus lente à mesure que la liste s'allonge.
Le résultat surprenant est que la méthode la plus performante pour construire une liste chaînée à partir de zéro consiste à ajouter chaque nouvel élément au début. Ainsi, si vous insérez les nombres 1, puis 2, puis 3, la liste finale en mémoire sera : 3 → 2 → 1.
Connexion à la science des données
Voici un exemple classique montrant comment un choix apparemment simple – ajouter au début ou à la fin – peut avoir des conséquences considérables sur les performances (O(1) contre O(n)). Cela souligne l'importance de comprendre la complexité temporelle des opérations que nous utilisons quotidiennement dans les scripts de nettoyage de données et d'ingénierie des caractéristiques. Une boucle lente peut masquer une opération linéaire qui pourrait être optimisée.
4. Arbres binaires de recherche : des recherches rapides qui peuvent dégénérer
Un arbre binaire de recherche (ABR) combine les avantages des tableaux triés et d'une liste chaînée. Il s'agit d'un arbre de nœuds, chaque nœud ayant jusqu'à deux enfants. Sa structure est régie par la propriété de recherche binaire : pour un nœud donné, toutes les valeurs de son sous-arbre gauche sont inférieures, et toutes les valeurs de son sous-arbre droit sont supérieures.
Cette propriété permet une recherche binaire en suivant simplement les pointeurs gauche ou droit dans l'arbre, ce qui garantit une performance de recherche efficace en temps logarithmique (O(log n)) en moyenne. Cependant, l'arbre binaire de recherche présente un défaut majeur. Dans le cas particulier où l'on insère des données déjà triées (par exemple, 1, puis 2, puis 3, puis 4), l'arbre devient totalement déséquilibré. Chaque nouveau nœud est simplement ajouté à droite du précédent.
Dans ce scénario du pire des cas, l'arbre de recherche binaire « se transforme en liste chaînée ». Ses performances de recherche passent d'un temps logarithmique à linear time (O(n)).
Connexion à la science des données
L'arbre binaire de recherche déséquilibré est une métaphore éloquente de la différence entre les performances moyennes et les performances dans le pire des cas. En science des données, la distribution et l'ordre des données d'entrée peuvent avoir un impact considérable sur l'efficacité d'un algorithme. C'est pourquoi les index de bases de données, souvent basés sur des structures arborescentes, nécessitent des algorithmes d'équilibrage complexes pour se réorganiser en permanence et éviter ce scénario catastrophe.
5. Tables de hachage : la voie pratique vers un temps constant
La table de hachage est la structure de données de prédilection pour implémenter des dictionnaires, qui stockent des paires clé-valeur. Elle combine habilement tableaux et listes chaînées pour permettre des recherches quasi instantanées. Ses principaux composants sont :
- An tableau de « seaux ».
- A fonction de hachage qui prend une clé (par exemple, le nom d'une personne) et la convertit de manière déterministe en un index pour le tableau.
- Listes liées dans chaque compartiment pour gérer les « collisions » — les cas où deux clés différentes correspondent au même index de tableau.
L'analogie des étagères de retrait de Sweetgreen, utilisée dans la conférence, illustre parfaitement ce concept. Votre nom sur la commande est la clé. L'employé qui choisit une étagère en fonction de la première lettre de votre nom (AE, FJ, etc.) représente la fonction de hachage. L'étagère elle-même est le panier (un index dans le tableau). Les quelques salades sur cette étagère que vous devez parcourir représentent la liste chaînée qui gère les collisions. Bien que le pire cas théorique soit linear time (O(n)) si toutes les clés entrent en collision dans une longue liste chaînée, les performances pratiques, en moyenne, sont remarquablement proches d' temps constant (O(1)).
« Oui, techniquement, les tables de hachage ont une complexité en N divisé par K, soit O(n). Mais en pratique, si vous êtes malin et que vous choisissez judicieusement votre fonction de hachage, la probabilité de collisions sera probablement si faible que même si, occasionnellement, le traitement se fait en temps linéaire, la plupart du temps, il sera en temps constant, soit O(1). » — Harvard CS50x 2025 (YouTube) — Cours : Structures de données
Connexion à la science des données
Les tables de hachage constituent le moteur des dictionnaires Python (dict) and sets (set). This is why key lookups (my_dict['key']) and membership testing (item in my_set) are exceptionally fast. These structures are fundamental tools for performant data manipulation, creating lookup tables, aggregating data by category, and building features efficiently.
Que postuler aujourd'hui
- Privilégiez toujours un dictionnaire/une table de hachage pour les recherches par paire clé-valeur. La recherche dans une liste de paires est plus efficace. La différence de performance entre O(1) et O(n) est énorme sur les grands ensembles de données.
- Tenez compte de l'ordre des données lorsque les performances sont importantes. Comme on l'observe avec les arbres binaires de recherche, l'insertion de données triées dans certaines structures peut déclencher un comportement catastrophique.
- Demandez-vous si vos données doivent être triées. Si vous n'avez besoin que de recherches rapides et de tests d'appartenance, un ensemble (basé sur le hachage) est beaucoup plus efficace qu'une liste.
- Visualisez les opérations sous-jacentes. Lorsqu'un script est lent, réfléchissez à la possibilité que vous forciez une opération linéaire O(n) à l'intérieur d'une boucle, créant par inadvertance une complexité O(n²).
- Prendre en compte le compromis temps-espace. Une table de hachage (comme une table de hachage Python)
dict) consumes more memory than a list to store its hash values and pointers, but it buys you dramatically faster lookups—a trade-off that is essential to writing performant code.
Fermeture
L'idée centrale est que chaque structure de données représente un compromis entre temps, espace et complexité d'implémentation. Il n'existe pas de structure « idéale », seulement la plus appropriée à la tâche à accomplir. Le cours aborde ensuite Python, un langage qui simplifie considérablement la gestion manuelle de la mémoire que nous avons évoquée. Cependant, les principes de performance restent tout aussi essentiels, car ces structures continuent d'opérer en interne. À quelle structure de données que vous utilisez quotidiennement porterez-vous désormais un regard différent ?




