


Ce que les data scientists oublient à propos de la mémoire
Un guide destiné aux analystes et scientifiques des données pour écrire un code plus robuste, efficace et prévisible en comprenant comment fonctionne réellement la mémoire.
Introduction : Les bugs qui ne sont pas dans votre logique
Vous avez alors Python Un script qui fonctionne parfaitement sur un petit échantillon de données, mais qui plante avec un message d'erreur cryptique. MemoryError on the full dataset. Or maybe you’ve encountered a bug in a data pipeline that vanishes when you try to debug it step-by-step. These frustrating problems often have nothing to do with a flaw in your business logic and everything to do with a gap in understanding what the computer is doing “under the hood.”
Bon nombre de ces problèmes complexes et imprévisibles trouvent leur origine dans des concepts fondamentaux de l'informatique liés à la mémoire. Les comprendre n'est pas qu'un simple exercice théorique ; c'est une compétence pratique essentielle pour écrire du code plus performant et plus fiable. Cet article est une synthèse du cours CS50x 2025 (Harvard) sur la mémoire, disponible sur YouTube.
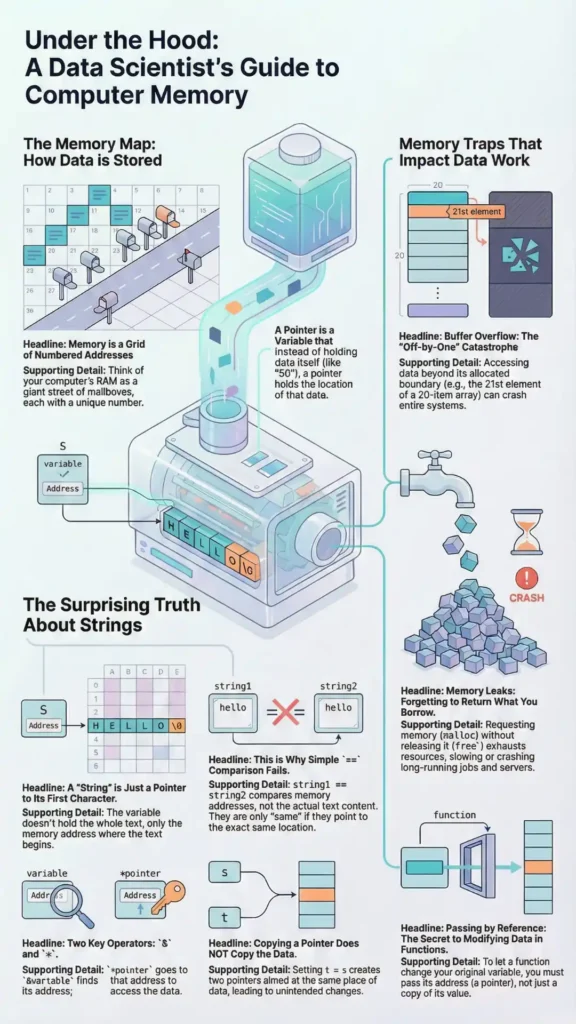
Conclusion n° 1 : « String » est une illusion
Dans de nombreux contextes d'introduction, un string is presented as a basic data type. The CS50 library, for instance, uses it as a helpful “training wheel” to get students started. However, in a foundational language like C, there is no built-in string data type. It’s an abstraction.
Ce que nous appelons une chaîne de caractères est en réalité une char *—a pointer to a character. This pointer is simply the memory address of the premier caractère dans une séquence. Pour savoir où se termine la chaîne, C utilise une valeur sentinelle spéciale : le terminateur nul (\0), a byte containing all zeros. Functions like printf read from the starting address character by character until they hit this null terminator. Without it, the function would just keep reading into adjacent memory, causing unpredictable behavior.
Lien avec la science des données : Ce concept est à l’origine de la manière dont les langages de haut niveau comme Python et R gèrent les chaînes de caractères et autres données de longueur variable. Il explique pourquoi la manipulation de chaînes peut s’avérer coûteuse en ressources de calcul ; le système recherche souvent un point de terminaison ou gère les tableaux sous-jacents. Pour les data scientists, ce principe est crucial lors de l’analyse de fichiers texte bruts ou de l’utilisation d’API ; un octet de terminaison manquant ou incorrect peut entraîner la corruption de données ou des erreurs d’analyse, comme la lecture incorrecte d’une ligne de fichier journal et la troncature d’informations d’erreur importantes.
Deuxième point à retenir : Pourquoi == Can Lie About Equality
Lorsque vous comparez deux variables entières en C avec ==, you’re comparing their values. But if you compare two string variables with ==, you are not comparing their content. Instead, you are comparing their memory adresses.
Si vous avez deux chaînes de caractères identiques, « high » et « high », mais qu'elles sont stockées à des emplacements différents en mémoire, == operator will return false. Their content is the same, but their addresses are different. This is why C requires a special function like strcmp (string comparison), which performs a character-by-character check to determine if the strings’ values are truly identical.
Lien avec la science des données : Cela correspond directement au concept d'identité d'objet par rapport à l'égalité des valeurs en Python. is in Python compares memory addresses (identity), while == typically compares values (equality). For complex objects like Pandas DataFrames, even == can be ambiguous. This is why dedicated methods like pandas.DataFrame.equals() exist. The fundamental C behavior explains why you can’t just compare two DataFrames with a simple operator; you need a robust method that iterates through and compares their actual contents, just like strcmp does for C strings.
Point clé n° 3 : Une copie pourrait bien n’être qu’un alias
En C, une instruction comme string t = s; might look like it’s creating a new copy of string s and naming it t. It is not. This operation does not copy the string’s content (the characters ‘H’, ‘I’, ‘!’, ‘\0’). It only copies the propos du premier caractère de la chaîne.
Cela signifie que les deux variables, s et t, now point to the exact same block of memory. They are two different names for the same underlying data. Consequently, if you modify the string using the variable t (for example, by capitalizing the first letter), you are also changing the string for s. There is only one string, and both variables point to it.
Lien avec la science des données : C’est l’origine du problème « vue vs copie » qui sème souvent la confusion chez les utilisateurs de Pandas. Un data scientist peut filtrer un DataFrame, l’assigner à une nouvelle variable et commencer à le modifier, croyant travailler sur une copie indépendante. Or, si Pandas renvoie une « vue » (un alias pointant vers les données originales), il modifie involontairement son jeu de données source. Cela peut engendrer des bogues subtils et dangereux, difficiles à détecter, car les données originales sont modifiées « mystérieusement » par une opération effectuée ailleurs.
« Lorsqu'on utilise littéralement l'opérateur « égal à » pour comparer deux chaînes de caractères… c'est-à-dire comparer deux caractères « * », c'est-à-dire comparer deux adresses, il est clair qu'elles se trouvent à des emplacements différents… Nous avions besoin d'une solution à ce problème, et c'est pourquoi nous avons introduit la fonction `stir comp` qui y remédie correctement. » — Harvard CS50x 2025 (YouTube) — Cours : Mémoire
Quatrième point à retenir : La mémoire est une ressource limitée que vous devez gérer.
Lorsqu'un programme a besoin de mémoire pendant son exécution (par exemple, pour stocker des données lues dans un fichier), il peut en faire la demande au système d'exploitation. En C, cela se fait grâce à une fonction appelée malloc() (memory allocation), which asks for a specific number of bytes from a large memory pool called the “heap.”
Toutefois, cette requête peut échouer. Si le système manque de mémoire disponible, malloc() will return NULL (a special pointer to address zero) to signal failure. Robust code must always check for this possibility. Furthermore, once the program is finished with that memory, it must explicitly return it to the system using free(). Failing to do so creates a “memory leak,” where the program holds onto memory it no longer needs, potentially causing it to run out of resources and crash over time.
Lien avec la science des données : Ceci s'applique directement au traitement de grands ensembles de données. Tenter de charger un fichier CSV ou Parquet volumineux dans un DataFrame Pandas peut facilement entraîner le plantage d'un script s'il requiert plus de mémoire que le système n'en a à disposition. Les principes de malloc et free are fundamental to writing scalable data pipelines, understanding why certain processes are “memory-bound,” and appreciating the design of modern data tools that use techniques like chunking or memory mapping to process data that won’t fit into memory all at once.
Point clé n°5 : Les fonctions disposent d’espaces de travail privés (la pile)
Lorsqu'une fonction est appelée, elle obtient son propre espace de travail privé dans une région de la mémoire appelée « pile ». Ce « cadre de pile » contient ses variables locales, y compris les arguments qui lui sont transmis.
Le cours CS50 illustre cela avec un swap function intended to swap two integer values. The initial version fails because it only swaps copies des valeurs contenues dans son propre cadre de pile privé. C'est ce qu'on appelle le « passage par valeur ». Une fois la fonction terminée, son cadre de pile disparaît et les variables d'origine de la fonction appelante (main) are left completely unchanged. The corrected version works by “pass by reference”—passing the memory adresses des variables d'origine. Cela donne le swap function the power to reach back into the caller’s stack frame and modify the original variables directly.
Lien avec la science des données : Ce concept est essentiel pour comprendre la portée et la mutabilité des variables lors de l’écriture de fonctions de transformation de données. Il permet d’expliquer pourquoi une fonction peut ne pas modifier un DataFrame qui lui est transmis comme prévu (par exemple, si elle réassigne la variable en interne au lieu de modifier l’objet directement). Il souligne également les principes de conception des « fonctions pures » — des fonctions qui ne modifient pas leurs entrées — indispensables à la création de pipelines d’analyse reproductibles, testables et exempts d’erreurs.
Point clé n°6 : Le bug du milliard de dollars est une erreur d’un seul indice.
Un « dépassement de tampon » se produit lorsqu'un programme tente d'écrire des données au-delà des limites allouées à une mémoire tampon, comme un tableau. C'est comme essayer de verser quatre litres d'eau dans un verre : l'excédent doit bien aller quelque part, et il écrase souvent la mémoire adjacente, provoquant des corruptions et des plantages.
La conférence fait référence à un incident réel impliquant le logiciel de sécurité CrowdStrike. Un bug dans une mise à jour a provoqué la panne de systèmes dans le monde entier. La cause première était étonnamment simple : le code attendait un tableau de 20 valeurs, mais en a reçu 21. La tentative d'accès au 21e élément inexistant a généré une erreur de lecture de mémoire hors limites, entraînant un plantage du système. Le langage C ne fournit aucune protection automatique contre ce type de bug, ce qui en fait une illustration frappante d'une catégorie de bug dangereuse.
Lien avec la science des données : Voici la leçon ultime de programmation défensive pour le traitement des données. Lors de l’analyse de fichiers, du parcours de listes ou du traitement de réponses d’API, il est impossible de présumer que les données entrantes correspondent à vos attentes. Cette vulnérabilité de bas niveau souligne l’importance cruciale d’une gestion robuste des erreurs et d’une validation rigoureuse des entrées. Avant tout traitement de données, il est impératif d’effectuer des vérifications explicites des formats, tailles et limites attendus afin d’éviter qu’une seule valeur inattendue ne provoque l’effondrement de l’ensemble du processus.
Que mettre en application aujourd'hui : une liste de contrôle pratique
- Examinez vos contrôles d'égalité : Lors de la comparaison d'objets complexes tels que des modèles ou des DataFrames, prenez un temps de pause et vérifiez s'il est nécessaire de savoir s'il s'agit du même type d'objet. objet exactement identique en mémoire (identité) ou s'ils simplement contiennent les mêmes données (égalité). Utilisez la méthode appropriée (
iset.equals()) for your goal. - Vérifiez les modifications apportées à votre DataFrame : Avant de modifier ce que vous pensez être une copie d'un DataFrame, vérifiez explicitement s'il s'agit d'une vue ou d'une copie. Une simple modification sur une vue peut corrompre silencieusement votre jeu de données d'origine.
.copy()to ensure you have an independent object. - Soyez proactif en matière de mémoire : Lorsque vous travaillez avec des fichiers volumineux, ne vous contentez pas de les charger en espérant que tout se passe bien. Utilisez des outils pour vérifier la mémoire système disponible et traitez les fichiers par petits morceaux (par exemple, en utilisant
chunksizedanspandas.read_csv) to avoid requesting more memory than is available. - Valider les limites des données : Chaque fois que vous accédez à des données par un index, comme dans une liste ou un tableau, considérez cela comme un point de défaillance potentiel. Ajoutez des vérifications pour vous assurer que l'index se situe dans la plage attendue, surtout si la taille des données est déterminée par une source externe.
- Ne jamais faire confiance aux données saisies : Considérez les données provenant de fichiers, d'API ou de saisies utilisateur comme fondamentalement non fiables. Avant toute opération, ajoutez des assertions ou des vérifications explicites des types, tailles et formats de données afin de détecter les problèmes inattendus avant qu'ils ne faussent votre analyse.
9. Réflexions finales
Ces concepts de mémoire de bas niveau ne sont pas de simples notions théoriques ; ils se manifestent directement à travers les bogues, les goulots d'étranglement en termes de performances et les failles de sécurité que nous rencontrons dans les travaux de pointe en science des données. En comprenant ce qui se passe en mémoire, nous pouvons passer de la confusion face aux symptômes au diagnostic de la cause profonde. Au fil du cours CS50, ces mêmes principes deviennent les fondements de la création des structures de données efficaces qui sous-tendent nos bases de données et nos algorithmes.
Quel bug « bizarre » récent dans votre code pourrait maintenant s'expliquer par l'un de ces principes fondamentaux de la mémoire ?




