Guide de sélection de la distribution et de la fonction de lien du modèle linéaire généralisé (GLM)
Vous apprendrez à sélectionner la distribution du modèle linéaire généralisé et la fonction de lien pour une précision de modélisation optimale.
Introduction
Les modèles linéaires généralisés (GLM) représentent une extension des modèles de régression linéaire traditionnels conçus pour s'adapter à un large éventail de types de données et de modèles de distribution. Cette flexibilité rend les GLM indispensables dans l’arsenal des data scientists et des statisticiens. À la base, les GLM se composent de trois éléments principaux :
- The composante aléatoire spécifie la distribution de probabilité de la variable de réponse ;
- The composante systématique relie les prédicteurs à la réponse par l'intermédiaire d'une fonction de prédicteur linéaire ;
- The fonction de lien relie la moyenne de la distribution au prédicteur linéaire.
Choisir uneDistribution de modèles linéaires généralisés et fonction de lienn'est pas qu'une simple décision technique ; c'est un art qui améliore la précision et les performances prédictives du modèle. Comprendre comment adapter la distribution et la fonction de lien aux caractéristiques intrinsèques des données est essentiel pour exploiter pleinement le potentiel des GLM et obtenir des analyses plus pertinentes et fiables. Ce guide a pour but de vous éclairer sur la voie d'une configuration optimale de votre modèle, afin que votre GLM tire véritablement parti de vos données.
Points forts
- Le choix de la distribution GLM correcte améliore considérablement la précision du modèle.
- Les fonctions de lien transforment les prédictions du modèle à l'échelle de la variable de réponse.
- La distribution binomiale avec un lien logit est idéale pour les données de résultats binaires.
- L'ajustement du modèle s'améliore en faisant correspondre la distribution à la nature des données.
- Les tests itératifs des fonctions de lien peuvent révéler les meilleures performances du modèle.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Comprendre la distribution GLM
Les modèles linéaires généralisés (GLM) sont une pierre angulaire de l'analyse statistique, permettant de traiter un large éventail de types de données grâce à leur cadre adaptable. Leur utilité repose essentiellement sur le concept dedistribution GLM, qui leur permet de dépasser les limitations de la régression linéaire traditionnelle en intégrant des distributions autres que la loi normale. Cette section explore les différentes distributions sous-jacentes aux GLM et vous guide dans le choix dedistribution GLM.
Diverses distributions pour des types de données variés
Les GLM sont spécialement conçus pour gérer différentes distributions de données, chacune répondant à des types spécifiques de variables de réponse. La distribution binomiale est fréquemment utilisée pour les résultats binaires, tels que les scénarios de réussite/échec. En revanche, la distribution de Poisson est essentielle pour compter les données, en abordant la question « combien ? ». Pour les données continues qui adhèrent à des valeurs positives, la distribution Gamma offre un modèle adapté. Chaque distribution est adaptée pour capturer l'essence de la structure de données sous-jacente, garantissant ainsi que les hypothèses du modèle s'alignent sur le comportement naturel des données.
Adaptation du modèle à vos données
Choisir ladistribution GLMappropriée n'est pas une solution unique, mais une décision nuancée qui influence considérablement la précision et l'interprétabilité du modèle. La clé réside dans la compréhension de la distribution de vos données et de leurs caractéristiques intrinsèques. Par exemple, la distribution de Poisson peut être un bon point de départ si vos données représentent des effectifs ou des taux. À l'inverse, la distribution binomiale sera plus appropriée pour des données binaires ou des proportions. Ce choix est crucial, car il garantit que le GLM reflète les processus réels qui génèrent vos données, améliorant ainsi les capacités prédictives et l'interprétabilité du modèle.
En associant soigneusement vos données avec le bondistribution GLMappropriée pour vos données , vous renforcez la rigueur analytique de votre étude, ouvrant la voie à des conclusions plus précises et pertinentes. Cette étape fondamentale est essentielle pour exploiter pleinement le potentiel des GLM et leur permettre de révéler les informations complexes que recèlent vos données.
Le rôle des fonctions de lien dans les GLM
Les fonctions de lien sont les piliers des modèles linéaires généralisés (GLM), servant de pont essentiel entre les prédicteurs linéaires et la valeur attendue de la variable de réponse. Leur rôle ne peut être sous-estimé, car ils permettent de modéliser un large éventail de types de données au-delà des capacités de la régression linéaire traditionnelle. En transformant les prédictions à l'échelle de la variable de réponse, les fonctions de lien garantissent que les sorties du modèle adhèrent à la plage et à la distribution de données appropriées, améliorant ainsi l'interprétabilité et la précision des prédictions du modèle.
Transformer les prédictions en réalité : l'essence des fonctions de lien
Les fonctions de lien ne sont pas universelles ; elles sont soigneusement sélectionnées en fonction de la nature de la variable réponse et de la distribution choisie pour le modèle linéaire généralisé (GLM). Parmi les fonctions de lien standard, on trouve la fonctionlogit, largement utilisée en régression logistique pour les données binaires, qui transforme les probabilités en une échelle continue non bornée. La fonction de lienidentité, inhérente aux modèles à distribution normale, suppose une relation directe entre les prédicteurs et la variable réponse. La fonction de lien logarithmique est typique des données de comptage modélisées par une distribution de Poisson, garantissant ainsi que les prédictions du modèle restent positives et continues.
Applications des fonctions de lien : de la théorie à la pratique
Le choix de la fonction de lien a de profondes implications pour l'application et l'interprétation du modèle. Par exemple, en épidémiologie, le lien logit dans la régression logistique modélise la probabilité qu'un événement se produise, comme la présence ou l'absence d'une maladie. En économie, le lien d'identité dans les modèles de régression linéaire prédit directement des résultats quantitatifs tels que le revenu sur la base de prédicteurs tels que l'éducation et l'expérience. Pendant ce temps, dans le domaine de l’assurance, le lien exponentiel dans les modèles de régression de Poisson compte les sinistres, garantissant que les prédictions sont non négatives et discrètes.
En sélectionnant et en appliquant judicieusement la fonction de lien appropriée, les statisticiens et les data scientists peuvent créer des GLM qui capturent les modèles sous-jacents de leurs données et transmettent leurs résultats de manière précise et intuitivement compréhensible à leur public. Cette section du guide démystifie la sélection et l'application des fonctions de lien, vous fournissant les connaissances nécessaires pour améliorer la précision et l'interprétabilité de vos GLM.
Sélection de la bonne fonction de distribution et de liaison
Le choixDistribution de modèles linéaires généralisés et fonction de lienest essentiel à la réussite de votre analyse statistique. La nature de votre variable réponse et la relation entre celle-ci et les prédicteurs orientent ce choix. Vous trouverez ici un guide détaillé pour vous accompagner dans ce processus crucial.
Étape 1 : Identifier le type de variable de réponse
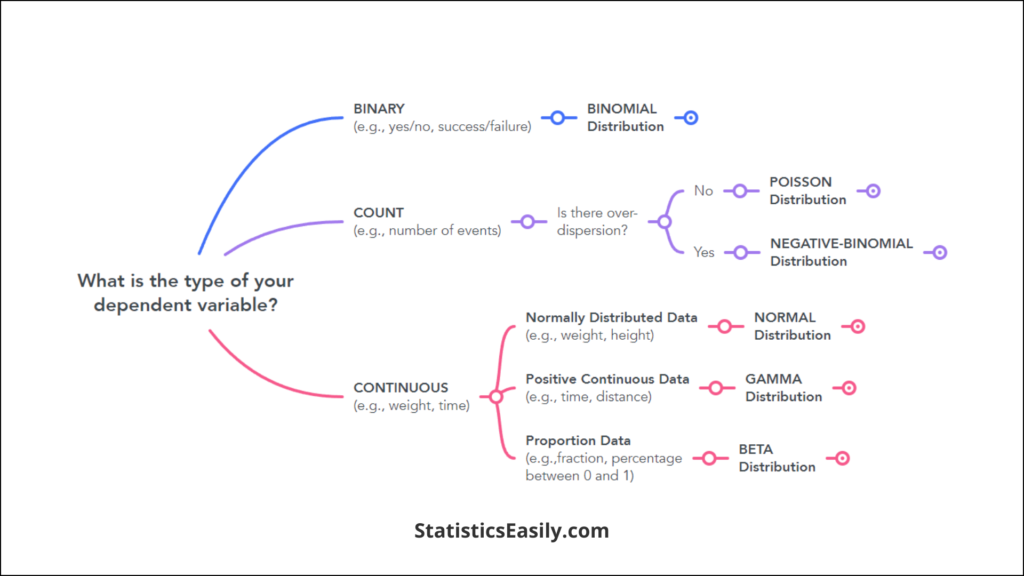
La première étape pour choisir la distribution appropriée consiste à identifier clairement le type de données avec lequel vous travaillez :
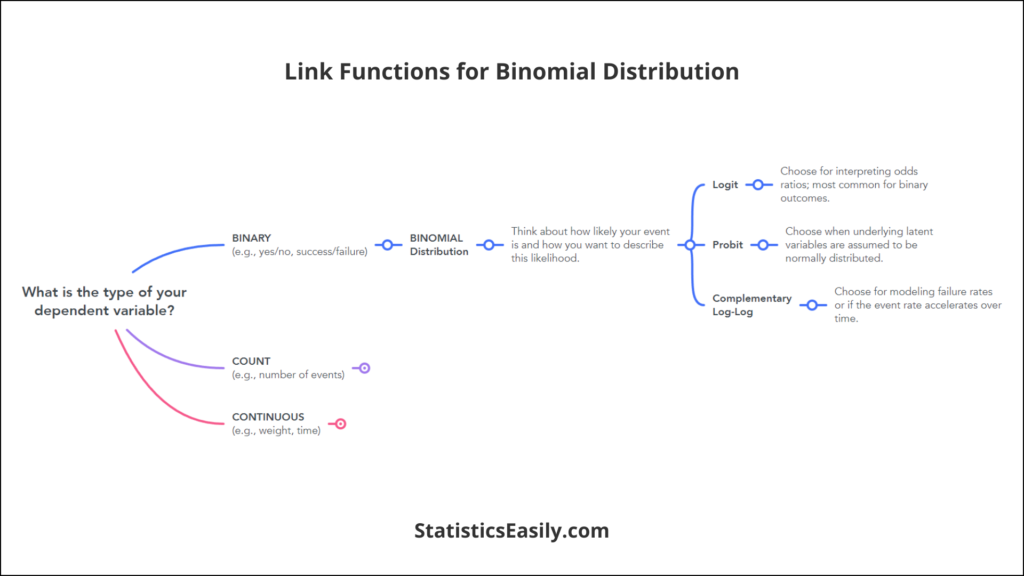
- Données binaires: Pour les résultats qui entrent dans l'une des deux catégories (par exemple, succès/échec, oui/non), ledistribution binomialeest le choix incontournable. Cette distribution modélise le nombre de succès dans une série d'essais indépendants.
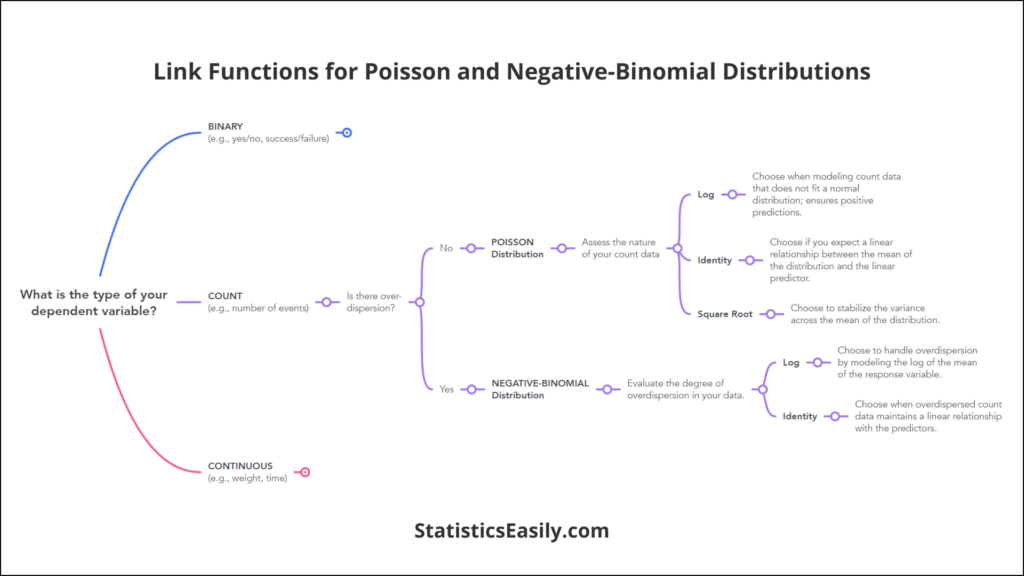
- Compter les données: LesLoi de Poissonest généralement utilisé lorsqu'il s'agit d'occurrences dénombrables (par exemple, le nombre d'événements dans un temps ou un espace donné). Il est idéal pour les données qui représentent des décomptes et sont des entiers non négatifs.
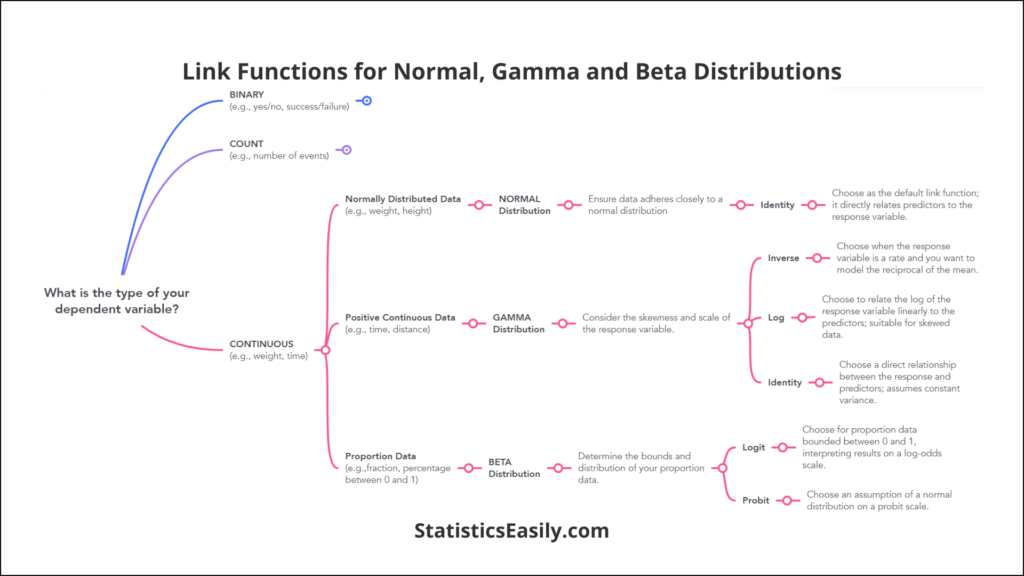
- Données continues: Lesdistribution Gammaconvient souvent aux données prenant n'importe quelle valeur dans une plage, en particulier les nombres positifs tels que les durées ou les montants. Il est utilisé pour modéliser des données positivement asymétriques.
- Données normalement distribuées: Lorsque vos données suivent approximativement une distribution normale, notamment dans le cas de résultats continus pouvant prendre à la fois des valeurs positives et négatives, leDistribution normalepeut être appliqué dans le cadre GLM.
Étape 2 : Comprendre la relation entre les variables
La fonction de lien connecte le prédicteur linéaire à la moyenne de la distribution des réponses. Il doit être choisi en fonction de la façon dont vous vous attendez à ce que les changements dans vos prédicteurs influencent la variable de réponse :
- Pour les données binaires: LesLien de connexionLa fonction est couramment utilisée, transformant la combinaison linéaire de prédicteurs pour qu'elle se situe entre 0 et 1, représentant ainsi les probabilités.
- Pour les données de comptage: LesLien de journalLa fonction est un choix naturel, en particulier avec la distribution de Poisson, garantissant que les prédictions sont toujours positives et bien adaptées aux données de dénombrement.
- Pour les données continues avec une asymétrie positive (Gamma): LesLien inverseLa fonction peut être pratique lors de la modélisation de taux ou de délais, garantissant des prédictions positives.
- Pour les données normalement distribuées: LesLien d'identitéLa fonction, qui implique une relation directe entre les prédicteurs et la variable de réponse, est souvent utilisée. Cette fonction simple implique que la valeur attendue de la réponse est égale au prédicteur linéaire.
Étape 3 : Application des diagnostics du modèle
Après avoir sélectionné une fonction préliminaire de distribution et de liaison en fonction des critères ci-dessus, il est crucial de valider votre choix via des diagnostics de modèle :
- Analyse résiduelle: Examinez les résidus à la recherche de modèles qui pourraient suggérer un mauvais ajustement, indiquant la nécessité d'une fonction de distribution ou de lien différente.
- Tests d'adéquation: Utilisez des tests tels que Deviance ou AIC pour évaluer dans quelle mesure votre modèle s'adapte quantitativement aux données. Ces tests peuvent vous guider dans la comparaison de différents modèles ou configurations pour trouver la meilleure solution.
Raffinement itératif
Le processus de sélection de la distribution et de la fonction de lien appropriées est souvent itératif. En fonction des diagnostics, vous devrez peut-être revoir vos choix, en essayant différentes distributions ou fonctions de liaison jusqu'à ce que les diagnostics indiquent un bon ajustement.
En suivant ces étapes détaillées, vous serez mieux équipé pour sélectionner la fonction de distribution et de liaison la plus appropriée pour votre GLM, améliorant ainsi la précision et l'interprétabilité du modèle.
| Type de variable de réponse | Distribution suggérée | Fonctions de lien communes | Case Study |
|---|---|---|---|
| Résultat binaire (par exemple, succès/échec) | Binomial | Logit, Probit, Log-Log complémentaire | Modélisation des probabilités de résultats binaires, tels que la présence/absence d'une maladie. |
| Compter les données (par exemple, nombre d'événements) | Poisson | Journal, identité, racine carrée | Compter les occurrences à intervalles fixes, comme le nombre d'appels reçus par un centre d'appels par heure. |
| Compter les données avec surdispersion | Binomial négatif | Journal, identité | Comptez les données qui présentent une variabilité dépassant les hypothèses de Poisson, comme le nombre de réclamations d'assurance par client. |
| Proportions continues | bêta | Logit, Probit | Proportions qui varient entre 0 et 1, comme la fraction d'une zone affectée par une certaine condition. |
| Données continues positives | Gamma | Inverse, Journal, Identité | Modélisation des temps d'attente ou de service, où la variable de réponse est toujours positive. |
| Données normalement distribuées | Normal (gaussien) | Identité | Résultats continus distribués symétriquement, tels que les résultats aux tests ou les hauteurs. |
Conseils pratiques pour l'optimisation GLM
Pour implémenter efficacement des modèles linéaires généralisés (GLM) enRetPythonil est essentiel de comprendre les subtilités de ces outils puissants. En exploitant judicieusement laDistribution de modèles linéaires généralisés et fonction de lien, vous pouvez affiner vos modèles afin d'obtenir une précision accrue et une meilleure interprétabilité. Voici quelques conseils pratiques pour vous guider dans cette démarche :
Meilleures pratiques pour implémenter des GLM dans R :
1. Utilisez la‘glm()‘fonction` : la fonction `glm()` de R est polyvalente et vous permet de spécifier la formule du modèle, la famille de distributions et la fonction de lien. Par exemple, `glm(response ~ predictors, family=binomial(link="logit"), data=mydata)` ajustera un modèle de régression logistique.
2. Diagnostic avec‘plot()‘et‘summary()` : Après avoir ajusté votre modèle, utilisez `summary(glm_model)` pour obtenir un résumé détaillé des coefficients du modèle, des niveaux de signification, etc. La fonction `plot(glm_model)` peut générer des graphiques de diagnostic pour évaluer l’ajustement et vérifier les hypothèses.
3. Sélection de modèle avec l'AIC: Utilisez la fonction 'step()' pour effectuer une sélection de modèle par étapes basée sur le critère d'information d'Akaike (AIC), vous aidant à choisir un modèle qui équilibre la complexité avec la qualité de l'ajustement.
4. Validation croisée: Pour la validation du modèle, envisagez d'utiliser des packages comme 'caret' ou 'cv.glm()' du package boot pour effectuer une validation croisée et évaluer les performances prédictives du modèle.
Meilleures pratiques pour implémenter des GLM en Python :
1. Utilisez‘statsmodels‘ou‘scikit-learn» : Python propose plusieurs bibliothèques pour l’implémentation de modèles linéaires généralisés (GLM). Pour une approche plus statistique, «statsmodels» fournit des résumés et des diagnostics détaillés. Pour une approche d’apprentissage automatique, «scikit-learn» offre simplicité et intégration aux flux de travail d’apprentissage automatique.
2. Modélisation avec‘statsmodels» : Utilisez «statsmodels.api.GLM» pour ajuster un modèle linéaire généralisé (GLM), en spécifiant la famille et la fonction de lien. Par exemple, «GLM(y, X, family=sm.families.Binomial(sm.families.links.logit)).fit()» ajuste une régression logistique.
3. Diagnostic et validation: Utilisez «statsmodels‘ » pour des techniques telles que la validation croisée.sklearn.model_selection‘ pour des techniques comme la validation croisée.
4. Sélection de caractéristiques: Dans 'scikit-learn', vous pouvez utiliser les techniques de régularisation disponibles dans les implémentations de régression logistique («LogisticRegressionCV») pour effectuer la sélection de caractéristiques et éviter le surapprentissage.
Affinement du modèle à l'aide de la fonction de distribution et de liaison :
Amélioration itérative: La modélisation est un processus itératif. Commencez par un modèle simple et complexifiez-le progressivement. Utilisez des outils de diagnostic à chaque étape pour évaluer les performances du modèle et prendre des décisions éclairées quant à son amélioration.
Choix de la distribution: Choisissez la distribution qui correspond le mieux à la nature de votre variable réponse. Pour les variables binaires, privilégiez la distribution binomiale ; pour les données de comptage, envisagez la distribution de Poisson ou la distribution binomiale négative en cas de surdispersion.
Choix de la fonction de lien: La fonction de lien doit refléter la relation entre les prédicteurs linéaires et l’échelle de réponse. Par exemple, utilisez une fonction de lien logit pour les probabilités dans un modèle binomial ou une fonction de lien logarithmique pour les données de comptage dans un modèle de Poisson.
Validation et diagnostic: Effectuez régulièrement des diagnostics du modèle afin de détecter des problèmes tels que la non-linéarité, les points de forte influence ou l’hétéroscédasticité. Utilisez les graphiques de résidus, les graphiques d’influence et la distance de Cook pour identifier les problèmes potentiels.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusion
Au terme de notre exploration des subtilités deDistribution de modèles linéaires généralisés et fonction de liendu choix de la fonction de lien, il est essentiel de revenir sur les notions fondamentales qui améliorent la précision de nos modèles statistiques et la profondeur de nos analyses. Ce guide a éclairé la voie vers l'exploitation optimale du potentiel des modèles linéaires généralisés, en soulignant l'importance cruciale d'adapter les composantes du modèle aux caractéristiques intrinsèques des données.
Principaux plats à emporter:
Approche personnalisée: L’optimisation des modèles linéaires généralisés (GLM) repose essentiellement sur le choix judicieux de la distribution et de la fonction de lien, en fonction de la nature de la variable réponse et de la relation attendue avec les prédicteurs. Qu’il s’agisse de variables binaires nécessitant une distribution binomiale associée à une fonction de lien logit ou de données de comptage modélisées de façon optimale par une distribution de Poisson et une fonction de lien logarithmique, chaque choix est fondamental pour la précision du modèle.
Diagnostic et itération: Le processus ne s’arrête pas à la sélection initiale. Le diagnostic est crucial pour affiner le modèle ; l’analyse des résidus et les tests d’adéquation guident les ajustements itératifs afin d’obtenir le meilleur ajustement possible.
Application concrète: La véritable validation de ces principes réside dans leur application à des données réelles. La polyvalence des modèles linéaires généralisés (GLM) permet de les adapter à un large éventail de scénarios, allant des études épidémiologiques prédisant l’incidence des maladies aux modèles économétriques évaluant les tendances du marché.
Articles recommandés
Explorez davantage de connaissances et de techniques avancées dans notre collection complète d'articles sur la modélisation statistique et l'analyse des données . Plongez au cœur de la science des données grâce à nos guides d'experts.
- Naviguer dans les bases des modèles linéaires généralisés : une introduction complète
- Guide de sélection de la distribution et de la fonction de lien du modèle linéaire généralisé (GLM)
- Comprendre les distributions des modèles linéaires généralisés
- Le rôle des fonctions de lien dans les modèles linéaires généralisés
Foire Aux Questions (FAQ)
Q1 : Qu’est-ce qu’un modèle linéaire généralisé (GLM) ?Un GLM est une généralisation flexible de la régression linéaire ordinaire qui permet aux variables de réponse d’avoir des modèles de distribution d’erreur autres qu’une distribution normale.
Q2 : Pourquoi est-il important de choisir la bonne distribution dans les GLM ?Sélectionner la distribution appropriée permet de modéliser les données avec précision, en reflétant leur structure et leur variabilité sous-jacentes.
Q3 : Que sont les fonctions de lien dans les GLM ?Les fonctions de lien définissent la relation entre le prédicteur linéaire et la moyenne de la fonction de distribution.
Q4 : Comment choisir la fonction de lien appropriée pour mon modèle linéaire généralisé (GLM) ?Le choix de la fonction de lien dépend de la nature de la variable dépendante et de la distribution des données.
Q5 : Puis-je utiliser plusieurs distributions dans un seul GLM ?Une seule distribution est généralement choisie pour s’ajuster au mieux aux données dans un GLM, mais les modèles complexes peuvent intégrer diverses distributions.
Q6 : Quelle est la distribution la plus couramment utilisée dans les GLM ?La distribution binomiale est largement utilisée pour les données binaires, tandis que la distribution normale est typique des données continues.
Q7 : Quel est le rôle des diagnostics dans la distribution GLM et la sélection de la fonction de lien ?Les diagnostics aident à évaluer l’adéquation du modèle, à identifier la présence de valeurs aberrantes et à guider le processus de sélection.
Q8 : Les outils logiciels peuvent-ils aider à sélectionner la distribution et la fonction de lien du modèle linéaire généralisé (GLM) ?Oui, les logiciels statistiques comme R et Python proposent des packages qui facilitent la sélection et l’évaluation des GLM.
Q9 : Comment le choix de la fonction de lien affecte-t-il l’interprétation du modèle ?La fonction de lien influence l’interprétation des coefficients du modèle, affectant la clarté et la pertinence des conclusions.
Q10 : Puis-je modifier la distribution et la fonction de lien après l’ajustement du modèle ?Oui, l’amélioration du modèle implique souvent de tester itérativement différentes distributions et fonctions de lien afin d’améliorer l’ajustement et la précision.