Guide statistique du coefficient de corrélation de Pearson
Vous découvrirez les subtilités de l’interprétation des valeurs R et leur impact profond sur l’analyse de corrélation des données avec notre guide statistique du coefficient de corrélation de Pearson.
Introduction
Au cœur de l'analyse statistique se trouve lecoefficient de corrélation de Pearson (r)— un outil fondamental pour quantifier la force et la direction d'une relation linéaire entre deux variables continues.
Que ce soit dans la recherche scientifique, la science des données ou les prévisions économiques, le coefficient de corrélation de Pearson constitue une mesure essentielle, offrant un aperçu de la mesure dans laquelle deux variables évoluent à l'unisson.
Loin d'être une simple abstraction mathématique, « r » reflète l'interaction nuancée entre les ensembles de données, guidant les analystes dans la découverte des modèles sous-jacents au sein du tissu de structures de données complexes.
Ce guide statistique analysera le coefficient de corrélation de Pearson, élucidant ses calculs, ses interprétations et les hypothèses critiques qui sous-tendent son utilisation.
Points forts
- Le Pearson r quantifie les relations linéaires entre des variables allant de +1 à -1.
- Les valeurs de r plus proches de +1 ou -1 indiquent des associations linéaires plus fortes dans les ensembles de données.
- Le coefficient de corrélation de Pearson n'est pas affecté par les différentes unités de mesure.
- Les hypothèses de linéarité et d'homoscédasticité sont cruciales pour la validité r de Pearson.
- Le r de Pearson n'implique pas de causalité, mais seulement le degré de corrélation linéaire.
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Comprendre le coefficient de corrélation de Pearson (r)
The coefficient de corrélation de Pearson (r)est la norme statistique permettant de mesurer le degré de relation linéaire entre deux variables. Ce coefficient fournit un résumé numérique compris entre -1 et +1, chaque extrémité représentant une relation linéaire parfaite, négative ou positive. Une valeur de r égale à 0 indique l'absence de corrélation linéaire entre les variables. Il reflète la capacité d'une variable à prédire l'autre par une équation linéaire. En pratique, la valeur de r aide les analystes à déterminer la prédictibilité et la force de la relation, fournissant ainsi une base pour la modélisation et l'inférence statistiques ultérieures.
Comprendre le coefficient « r » est essentiel pour les domaines qui s'appuient sur l'analyse des données pour prendre des décisions éclairées, de la recherche médicale aux prévisions financières. Son calcul consiste à comparer la variance partagée entre les variables au produit de leurs variances, ce qui permet de saisir l'essence de leurs fluctuations synchrones.
Aide visuelle
À titre d’exemple, considérons un ensemble de données examinant la relation entre les heures d’études et les résultats des examens. Nous nous attendons à voir une corrélation positive ; à mesure que les heures d’étude augmentent, les résultats aux examens devraient augmenter également. Cela serait représenté comme une collection de points ascendants sur un nuage de points.
À l’inverse, supposons que nous examinions le nombre d’heures consacrées aux activités de loisirs et les résultats aux examens. Dans ce cas, on pourrait trouver une corrélation négative, illustrée par une tendance à la baisse.
Les points n’afficheraient aucune tendance ou direction perceptible dans un scénario sans corrélation, comme la relation entre la pointure des chaussures et les résultats des examens.
Vous trouverez ci-dessous une représentation visuelle de ces scénarios :
- Correlation positive: À mesure qu’une variable augmente, l’autre augmente également.
- Corrélation négative: À mesure qu’une variable augmente, l’autre diminue.
- Aucune corrélation: Aucun modèle linéaire perceptible dans la relation entre les variables.
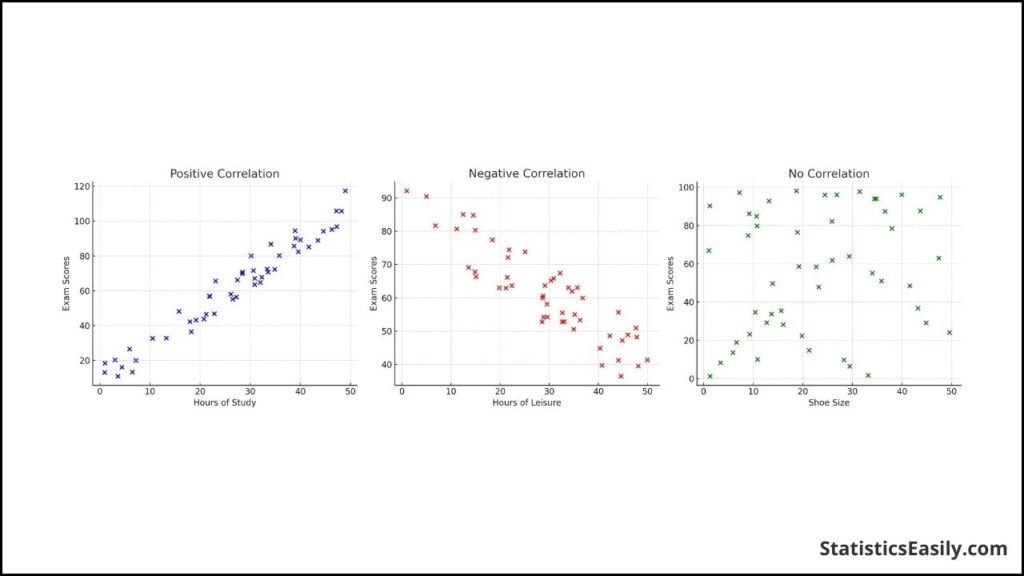
Ce graphique est un outil puissant dans l'analyse préliminaire, permettant une évaluation rapide des relations potentielles méritant d'être étudiées avec des techniques statistiques plus sophistiquées.
La gamme de valeurs et ce qu’elles indiquent
Le coefficient de corrélation de Pearson (r) quantifie l'intensité et le sens de la relation linéaire entre deux variables. Ses valeurs se situent toujours entre -1 et +1. Aux extrémités de cet intervalle, on observe des corrélations parfaites : +1 indique une corrélation linéaire positive parfaite, où les variables évoluent de concert, tandis que -1 indique une corrélation linéaire négative parfaite, où une variable augmente lorsque l'autre diminue. Une valeur de r égale à 0 signifie l'absence de corrélation linéaire ; les variables ne présentent aucune dépendance linéaire.
Cette plage est cruciale pour comprendre la dynamique entre les variables. Par exemple, une valeur « r » proche de +1 suggère qu’une augmentation d’une variable sera probablement accompagnée d’une augmentation de l’autre dans une mesure similaire. À l’inverse, une valeur « r » proche de -1 indique qu’une augmentation de l’un est généralement associée à une diminution de l’autre. Plus la valeur est proche de 0, plus la relation linéaire est faible, ce qui signifie que les variations d'une variable ne prédisent pas de manière fiable les changements de l'autre.
Le coefficient de détermination (r²)
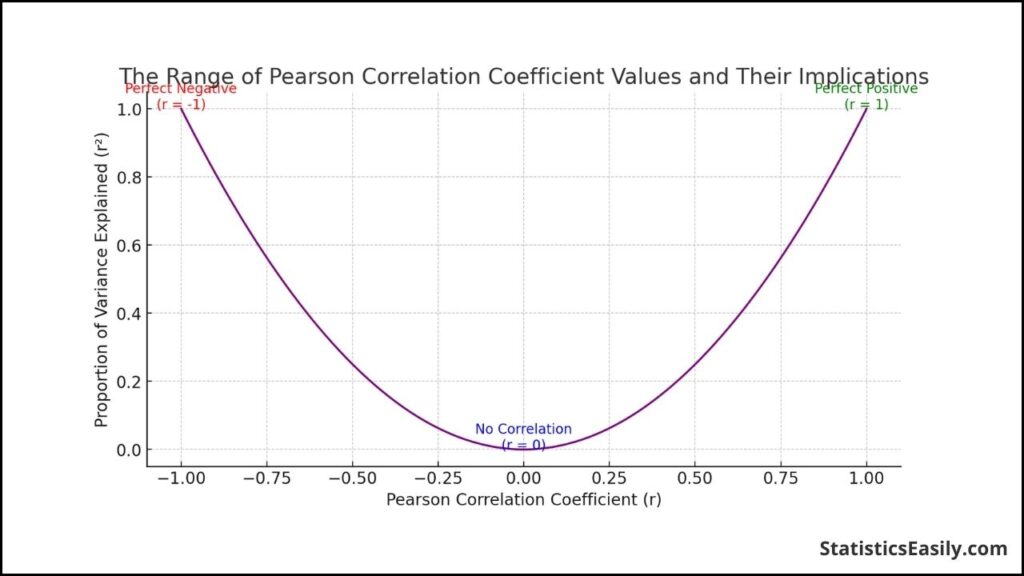
Après avoir compris « r », le coefficient de détermination, noté « r² », devient une mesure essentielle. Il représente la valeur au carré de « r ». Il indique la proportion de la variance de la variable dépendante qui est prévisible à partir de la variable indépendante. Essentiellement, « r² » nous donne le pourcentage dans lequel une variable explique l'autre.
Par exemple, si « r » vaut 0.8, le mettre au carré pour obtenir « r² » donne 0.64. Cela signifie que la variance de l'autre variable représente 64 % de la variance d'une variable. Il s'agit d'un moyen puissant de quantifier le pouvoir prédictif du modèle linéaire créé par les deux variables. Lorsque « r² » est élevé, les prédictions du modèle basées sur la relation linéaire seront probablement plus précises.
La représentation graphique illustre cette relation, illustrant comment la valeur de « r » est en corrélation avec la variance expliquée. Cela donne une compréhension visuelle et intuitive de la manière dont « r² » fonctionne comme déterminant de la force de corrélation.
Force de l’association : interpréter les valeurs « r »
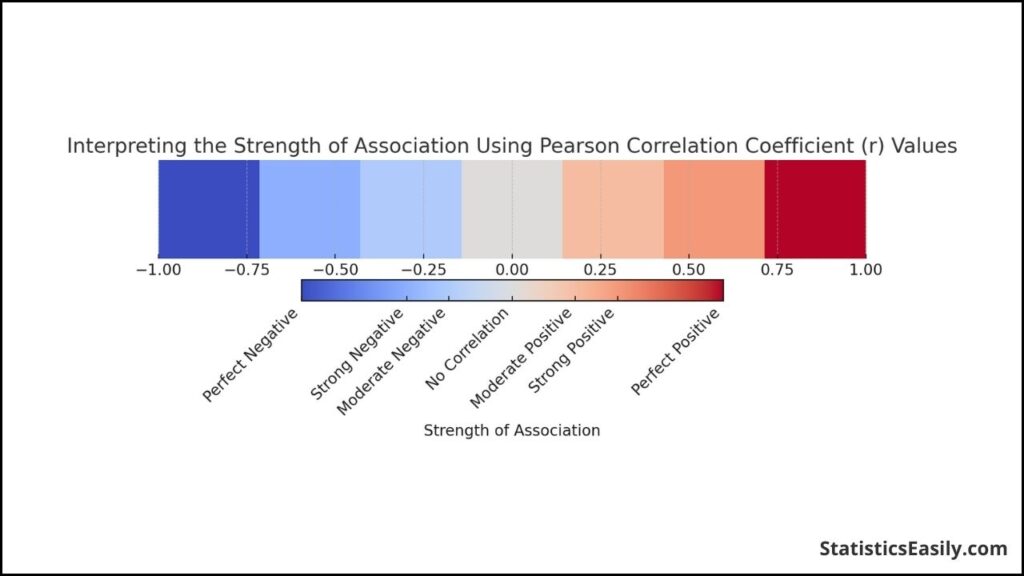
La force de l'association entre deux variables, comme l'indique le coefficient de corrélation de Pearson « r », mesure dans quelle mesure les points de données se conforment à un modèle linéaire. Lors de l’interprétation des valeurs « r », plusieurs seuils sont couramment utilisés pour décrire qualitativement la force de la relation :
- voiture: Une valeur « r » de -1 ou +1 signifie que les points de données se trouvent précisément sur une ligne ; autrement dit, les deux variables sont en parfaite association linéaire.
- Forte: Les valeurs 'r' plus proches de -1 ou +1 (mais pas parfaites) suggèrent une forte relation linéaire avec peu d'écart par rapport à la ligne.
- Modérée: les valeurs 'r' plus éloignées des extrêmes (environ -0.5 à 0.5) indiquent une association linéaire plus modérée.
- Faible ou aucun: Lorsque 'r' est proche de 0, cela suggère une association linéaire faible ou inexistante ; les variables ne semblent pas avoir de relation linéaire.
La représentation graphique qui l'accompagne mappe les valeurs « r » sur un spectre de couleurs où les extrêmes (rouge pour négatif et bleu pour positif) représentent des associations plus fortes, et le point médian (blanc) ne représente aucune association.
Types variables adaptés au r de Pearson
Le coefficient de corrélation de Pearson est conçu pour mesurer la relation linéaire entre deux variables qui sont à la fois continues et sur une échelle d'intervalle ou de rapport. Les variables continues peuvent prendre des valeurs infinies dans une plage donnée, comme la température, la taille, le poids ou les résultats des tests.
Les variables d'intervallesont des valeurs numériques où l'ordre et la différence exacte entre les valeurs sont significatifs, comme la température en degrés Celsius ou Fahrenheit.
Variables de ratio: Elles possèdent toutes les propriétés des variables d’intervalle et une définition claire du zéro. Le poids en kilogrammes ou l’âge en années en sont des exemples.
Les variables qui ne conviennent pas au r de Pearson incluent :|
Variables nominales: Il s’agit de données catégorielles qui n’ont pas de valeur numérique ni d’ordre, comme le sexe, la race ou la présence ou l’absence d’une affection.
Variables ordinales: Bien qu’elles impliquent un ordre, les intervalles entre les valeurs ne sont ni uniformes ni connus. L’échelle de Likert (par exemple, une note de 1 à 5) en est un exemple.
Il est essentiel de s'assurer que les données ne violent pas les hypothèses de la corrélation de Pearson, telles que l'hypothèse de linéarité, la présence de valeurs aberrantes et l'homoscédasticité (variances égales le long de la ligne de meilleur ajustement).
Mesure unitaire et sa non-pertinence par rapport à « r »
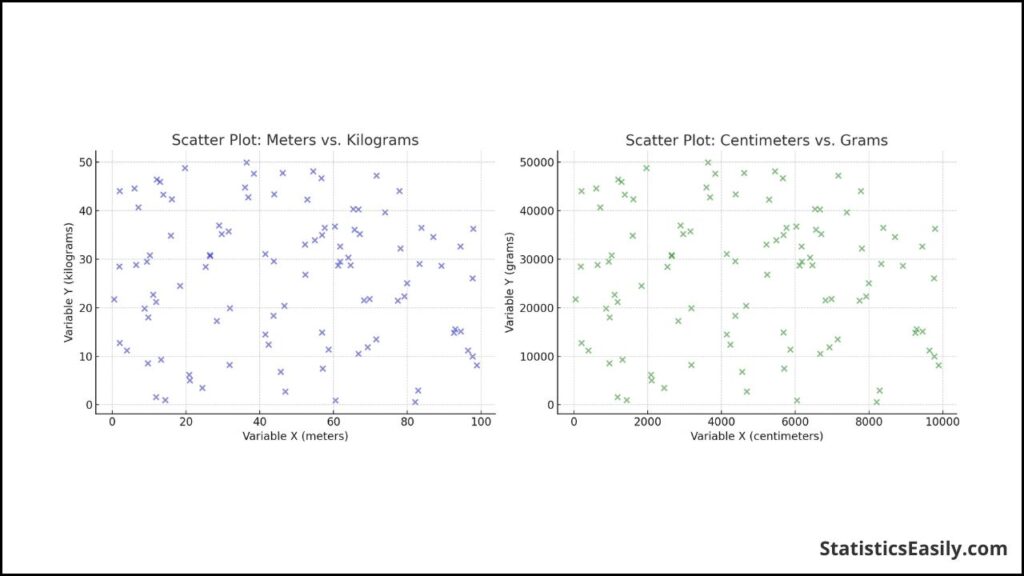
Le coefficient de corrélation de Pearson, « r », est une mesure sans dimension. Cela signifie que cela ne dépend pas des unités de mesure des variables impliquées. Au lieu de cela, il quantifie la force et la direction de la relation linéaire entre deux variables. Par conséquent, que vous mesuriez ces variables en mètres ou en centimètres, en kilogrammes ou en grammes, n'affecte pas la valeur de « r ».
Par exemple, si vous avez deux variables, la variable X mesurée en mètres et la variable Y mesurée en kilogrammes, et que vous calculez « r », vous obtiendrez la même valeur que si vous mesuriez la variable X en centimètres et la variable Y en grammes. En effet, la formule pour « r » normalise les variables en fonction de leurs écarts types, supprimant ainsi les unités de l'équation.
Dans notre exemple, le calcul de « r » pour les variables en mètres et en kilogrammes a abouti à une corrélation d'environ -0.0661. Lorsque nous avons converti ces variables en centimètres et en grammes et recalculé « r », nous avons obtenu la même valeur de corrélation d’environ -0.0661. Cela démontre le manque de pertinence des unités par rapport au coefficient de corrélation de Pearson, garantissant que la mesure de l'association reste cohérente quelles que soient les échelles utilisées pour la mesure.
Cette propriété est particulièrement utile en recherche et en analyse, permettant la comparaison directe des résultats d’études pouvant utiliser différentes unités de mesure. Cela simplifie également l’interprétation de la corrélation, en se concentrant sur la relation elle-même plutôt que sur l’ampleur spécifique du changement.
Variables indépendantes et dépendantes : l'impartialité de « r »
Une caractéristique notable de « r » est son impartialité quant à la catégorisation des variables comme dépendantes ou indépendantes.
Lors du calcul de « r », l'accent est mis sur la direction et la force de l'association linéaire, et non sur les variables qui en sont la cause ou l'effet. Cette impartialité fait de « r » une mesure robuste applicable dans divers contextes, quelle que soit la nature des variables impliquées.
La neutralité du « r » en action
Pour illustrer, considérons une étude examinant la relation entre la quantité d'engrais utilisée (en kilogrammes) et le rendement des cultures (en tonnes). Supposons que nous désignons la quantité d'engrais comme variable indépendante et le rendement des cultures comme variable dépendante et que nous calculions « r ». Dans ce cas, nous obtenons une valeur reflétant la force de cette association linéaire.
Il est intéressant de noter que si nous inversons les rôles des variables, en traitant le rendement des cultures comme indépendant et la quantité d'engrais comme dépendante, la valeur de « r » reste inchangée. Cela montre que « r » n'est pas affecté par la dépendance fonctionnelle des variables ; il quantifie simplement la relation linéaire entre eux.
Pour visualiser cette impartialité, considérons le schéma suivant :
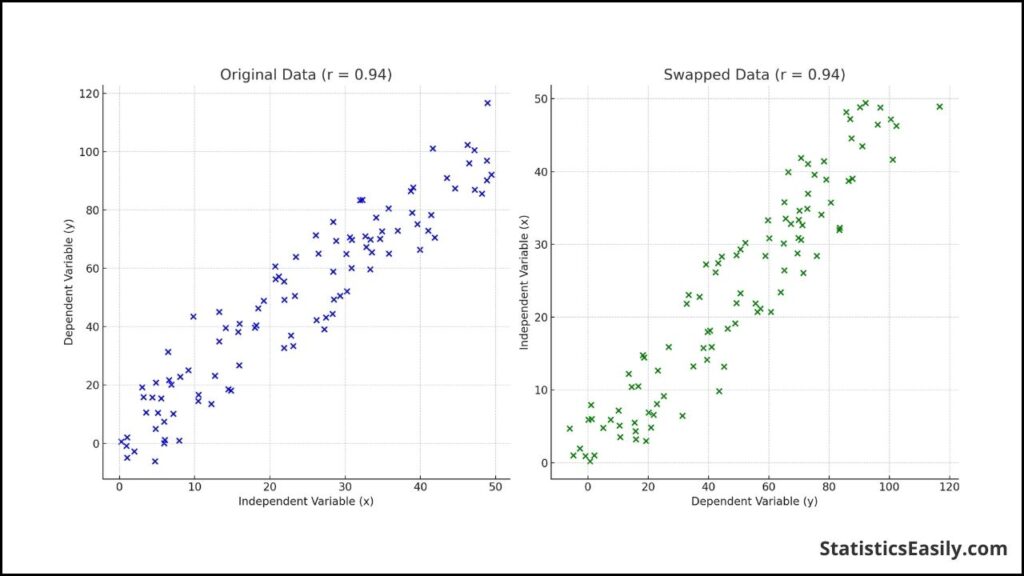
Dans le diagramme, deux nuages de points représentent la même relation linéaire avec les variables échangées. Dans les deux tracés, la droite de meilleur ajustement est identique et la valeur calculée de « r » est la même. Cela sert de rappel visuel que quelle que soit la variable indépendante ou dépendante, « r » fournit une mesure cohérente de la relation linéaire.
Les hypothèses derrière la corrélation de Pearson
Le coefficient de corrélation de Pearson (r) est valable dans des conditions spécifiques. Ici, nous discutons des sept hypothèses critiques requises :
Échelle continue: Les deux variables doivent être mesurées sur une échelle continue. Les données continues peuvent prendre n’importe quelle valeur dans un intervalle et ne sont pas limitées à des catégories ou à des valeurs discrètes.
Observations appariées: Les données des deux variables doivent être appariées. Chaque observation d’une variable correspond à une observation de l’autre variable.
Indépendance des observations: Chaque paire d’observations doit être indépendante de toutes les autres paires. La valeur d’une paire ne dépend pas de la valeur d’une autre.
Relation linéaire: Il doit exister une relation linéaire entre les deux variables. Cela signifie que lorsque l’une augmente ou diminue, l’autre variable augmente ou diminue également, de manière à être représentée par une droite.
Distribution normale bivariée: Idéalement, les deux variables devraient suivre une distribution normale, et les paires de variables devraient suivre une distribution normale bivariée.
L'homoscédasticité: Les points de données autour de la droite de régression doivent être répartis de manière uniforme à chaque niveau de la variable indépendante, ce qui signifie que la variance au sein de chaque variable est constante.
Absence de valeurs aberrantes: les données ne doivent contenir aucune valeur aberrante significative, car celles-ci peuvent affecter de manière disproportionnée la valeur du coefficient de corrélation.
En répondant à ces hypothèses, le coefficient de corrélation de Pearson peut être une mesure fiable de l'association entre deux variables continues, reflétant le degré de relation linéaire. Les aides visuelles peuvent servir d’outil de diagnostic pour garantir que ces hypothèses sont respectées.
Détection et gestion des valeurs aberrantes
Les valeurs aberrantes peuvent fausser la véritable relation entre deux variables de plusieurs manières :
- Augmentation ou diminution de r: Une valeur aberrante peut gonfler ou dégonfler artificiellement le coefficient de corrélation, donnant une fausse impression d'une relation linéaire plus forte ou plus faible que celle qui existe réellement.
- Interprétation trompeuse: Les valeurs aberrantes peuvent donner l'impression qu'une relation non linéaire est linéaire ou masquer une relation significative, conduisant à des conclusions incorrectes.
Méthodes de détection des valeurs aberrantes
La détection des valeurs aberrantes implique à la fois des méthodes graphiques et statistiques :
- Méthodes graphiques: Les nuages de points sont inestimables pour inspecter visuellement les données à la recherche de valeurs aberrantes. Les points éloignés du groupe de données principal peuvent être considérés comme des valeurs aberrantes potentielles.
- Méthodes statistiques: Des techniques telles que le score Z, où les valeurs supérieures à 3 écarts types par rapport à la moyenne sont souvent considérées comme des valeurs aberrantes, et la méthode de l'intervalle interquartile (IQR), où les valeurs en dehors de 1.5 fois l'IQR des quartiles sont des valeurs aberrantes, sont couramment utilisées.
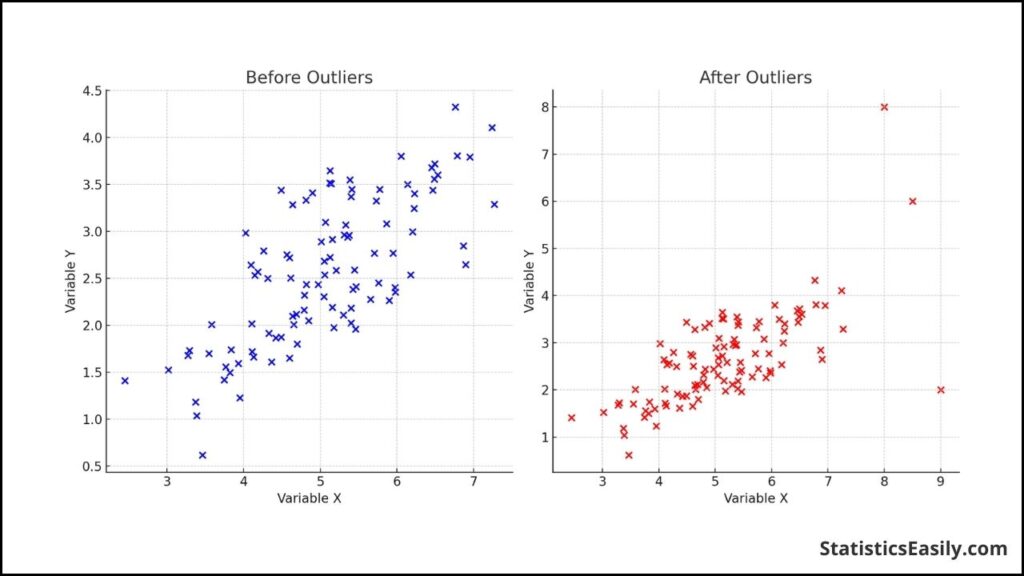
Avant l'introduction des valeurs aberrantes: Le graphique de gauche montre une relation relativement linéaire entre les variables X et Y, indiquant une corrélation positive potentielle en l'absence de valeurs aberrantes. Après l'introduction des valeurs aberrantes: Le graphique de droite introduit des valeurs aberrantes dans l'ensemble de données, ce qui fausse visiblement la relation perçue entre X et Y et peut affecter significativement le coefficient de corrélation de Pearson r.
Gestion des valeurs aberrantes
Une fois détectées, les valeurs aberrantes peuvent être gérées via différentes approches :
- Exclusion: Supprimer les valeurs aberrantes de l'analyse, ce qui est approprié si les valeurs aberrantes sont des erreurs ou ne sont pas représentatives de la population.
- Transformation: application d'une transformation mathématique, telle que des transformations logarithmiques ou racine carrée, pour réduire l'asymétrie causée par les valeurs aberrantes.
- L'imputation: Remplacer les valeurs aberrantes par des valeurs plus représentatives, telles que la moyenne ou la médiane des données, bien que cela puisse potentiellement biaiser les résultats.
Rapport des résultats de la corrélation de Pearson
Lorsque vous rapportez les résultats d’une analyse de corrélation de Pearson, vous devez inclure les éléments suivants :
Coefficient de corrélation (r): Il s'agit du principal résultat de votre analyse, indiquant la force et la direction de la relation linéaire entre les deux variables.
Degrés de liberté (df): Ils sont calculés comme le nombre de paires de scores moins 2 (N− 2). Ils sont utilisés dans les tests de signification.
Valeur p: Elle indique si la corrélation observée est statistiquement significative. Le seuil de signification standard estp < 0.05, mais il peut varier selon le domaine et le contexte de recherche.
Intervalle de confiance: Bien qu'il ne soit pas toujours inclus, l'intervalle de confiance pourrfournit une plage dans laquelle le véritable coefficient de corrélation se situera probablement.
Explication narrative: Outre les résultats numériques, une brève interprétation de la signification du coefficient de corrélation dans le contexte de votre étude est utile.
Exemple de rapport
Voici un exemple illustrant la façon de rapporter les résultats de la corrélation de Pearson dans un document de recherche ou un rapport d'analyse :
“Une analyse de corrélation de Pearson a été menée afin d'examiner la relation entre le nombre d'heures d'étude et les notes aux examens chez les étudiants universitaires. Les résultats ont indiqué une forte corrélation positive entre les deux variables, r(98) = 0.76, p < 001. Cela suggère qu'un nombre accru d'heures d'étude est associé à de meilleures notes aux examens. La force de cette relation est considérée comme robuste, comme l'indiquent le coefficient de corrélation élevé et la valeur p significative.“
Points clés à retenir
- Indiquez toujours la valeur exacte deret lep-valeur.
- Interprétez les résultats dans le contexte de votre étude, en expliquant ce que la corrélation signifie pour votre question de recherche spécifique.
- Soyez prudent de ne pas impliquer une causalité à partir d’une corrélation. Un haut ou un basrLa valeur indique uniquement la force et la direction d’une relation linéaire, et non qu’une variable entraîne des changements dans l’autre.
- Envisagez de discuter de toute limitation ou facteur potentiel susceptible d'affecter l'interprétation de la corrélation, comme la présence de valeurs aberrantes ou l'hypothèse de linéarité.
En suivant ces directives, vous vous assurez que vos rapports sur les résultats de la corrélation de Pearson sont clairs, complets et précieux pour votre public, contribuant ainsi efficacement au dialogue scientifique plus large.
Signification statistique et coefficient de détermination (r²)
Comprendre la signification statistique et le coefficient de détermination (r) est essentiel pour interpréter les résultats d'une analyse de corrélation de Pearson. Ces concepts permettent de déterminer la force et le sens de la relation linéaire entre deux variables, ainsi que la fiabilité et le pouvoir explicatif de la corrélation observée.
Signification statistique
La signification statistique, dans le contexte d'une corrélation de Pearson, indique la probabilité que la corrélation observée entre deux variables ne soit pas due au hasard. Lap-valeur associée au coefficient de corrélation de Pearsonrindique si la corrélation observée est statistiquement significative.
Interprétation: Le seuil de signification statistique généralement retenu estp < 0.05, ce qui signifie que la probabilité que la corrélation observée soit due au hasard est inférieure à 5 %. Toutefois, ce seuil peut varier selon le contexte ou la discipline de l’étude.
Rapport: Lors de la présentation de la signification statistique, incluez la valeurpexacte . Par exemple : «La corrélation entre les variables X et Y était significative, r(48) = 0.62, p = 0.003.“
Coefficient de Détermination (r²)
Le coefficient de détermination,r, est obtenu en élevant au carré le coefficient de corrélation de Pearson (r). Il représente la proportion de la variance d'une variable qui est prévisible à partir de l'autre variable.
Interprétation: Un coefficient de déterminationr) de 0.36, par exemple, indique que la variance de l’autre variable explique 36 % de la variance de la première variable. Plus lerest élevé , plus le pouvoir explicatif de la relation linéaire est important.
Pertinence contextuelle: roffre une compréhension plus intuitive de la force de la corrélation en quantifiant la part de la variation d'une variable associée aux variations de l'autre.
Exemple de reporting r²
“Dans notre analyse, le coefficient de corrélation de Pearson entre le temps d'étude et les notes aux examens était de r = 0.60, statistiquement significatif avec p < 0.001. En élevant ce coefficient de corrélation au carré pour calculer le coefficient de détermination (r²², nous obtenons r²²0.36. Cela indique que 36 % de la variabilité des notes aux examens peut être expliquée par le temps consacré à l'étude. Ce résultat souligne l'impact considérable du temps d'étude sur la performance aux examens.“
Titre de l'annonce
Description de l'annonce. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Conclusion
Ce guide complet explore les subtilités du coefficient de corrélation de Pearson (r), un outil fondamental de l'analyse statistique permettant de mesurer la relation linéaire entre deux variables continues. De la recherche scientifique aux prévisions économiques,rconstitue un indicateur essentiel, révélant la synchronisation des variables et facilitant la découverte des tendances sous-jacentes dans les données.
À retenir:
- PearsonrAutonomie: Le Pearsonrla valeur varie de +1 à -1, où les valeurs proches des extrêmes indiquent de fortes associations linéaires et une valeur de 0 signifie aucune corrélation linéaire.
- Interprétation der: La valeur derquantifie la direction et la force d'une relation linéaire, permettant des prédictions et des informations sur les interdépendances variables.
- Signification statistique: L'importance der, déterminé par lep-value, évalue si la corrélation observée n'est probablement pas due au hasard.
- Coefficient de détermination (r²): Quadraturerrendementsr², qui explique le pourcentage de variance d'une variable prévisible par rapport à l'autre, améliorant ainsi l'interprétabilité de l'impact de la corrélation.
- Hypothèses de validité: L'application valide de Pearsonrnécessite le respect d'hypothèses telles que la linéarité, l'homoscédasticité et l'absence de valeurs aberrantes, garantissant des résultats fiables.
- Gestion des valeurs aberrantes: Il est crucial d’identifier et de traiter les valeurs aberrantes, car elles peuvent fausser considérablementr, affectant la précision et l'interprétation de la corrélation.
Le coefficient de corrélation de Pearson transcende la simple analyse numérique, offrant une fenêtre sur la danse élégante des variables au sein des ensembles de données. Cela oblige les chercheurs et les analystes à approfondir leurs données, à découvrir les relations qui éclairent les théories, conduisent aux découvertes et guident la prise de décision.
Articles recommandés
Explorez davantage d’informations et approfondissez votre compréhension des corrélations statistiques dans notre collection d’articles guidés par des experts.
Foire Aux Questions (FAQ)
Q1 : Qu’est-ce que le coefficient de corrélation de Pearson exactement ?C’est une mesure statistique qui reflète la relation linéaire entre deux variables continues, notée r.
Q2 : Quand est-il approprié d’utiliser le coefficient de corrélation de Pearson (r) ?Utilisez le coefficient de corrélation de Pearson (r) pour mesurer la force et la direction d’une relation linéaire entre deux variables.
Q3 : Le coefficient de corrélation de Pearson (r) permet-il de déterminer la causalité entre des variables ?Non, le coefficient de corrélation de Pearson (r) indique seulement la force d’une association linéaire, et non une relation de cause à effet.
Q4 : Comment l’échelle de mesure affecte-t-elle le coefficient de corrélation de Pearson (r) ?Elle ne l’affecte pas ; le coefficient de corrélation de Pearson (r) est invariant d’échelle, ce qui signifie qu’il n’est pas affecté par les unités de mesure des variables.
Q5 : Que signifie une valeur r de Pearson de 0 ?Une valeur r de 0 suggère l’absence de corrélation linéaire entre les variables étudiées.
Q6 : Existe-t-il des hypothèses sous-jacentes à l’utilisation du coefficient de corrélation de Pearson (r) ?Oui, les données doivent notamment suivre une distribution normale, être linéairement corrélées et homoscédastiques.
Q7 : Quelle est la plage de valeurs du coefficient r de Pearson ? Lecoefficient r de Pearson peut varier de +1, indiquant une corrélation positive parfaite, à -1, une corrélation négative parfaite.
Q8 : Comment les valeurs aberrantes affectent-elles le coefficient de corrélation de Pearson (r) ?Les valeurs aberrantes peuvent fausser considérablement les résultats, donnant l’impression que la corrélation est plus forte ou plus faible qu’elle ne l’est réellement.
Q9 : Le coefficient de corrélation de Pearson peut-il être utilisé pour des données ordinales ?Non, le coefficient de corrélation de Pearson n’est pas adapté aux données ordinales. On utilise généralement à la place le coefficient de corrélation de rang de Spearman.
Q10 : Comment présente-t-on les résultats de la corrélation de Pearson ?Pour déterminer la signification statistique, indiquez la valeur r, les degrés de liberté et la valeur p.